Sur un Mac Apple Silicon, prenez MLX avec mlx-lm ou le moteur MLX de LM Studio : sur 6 des 7 modèles mesurés, le MLX 4 bits pèse 4 à 8 % de moins que le GGUF Q4_K_M. Prenez GGUF pour llama.cpp, pour un autre ordinateur ou pour plus de niveaux de compression. Ollama choisit pour vous.
Cette dernière phrase cache la découverte la plus curieuse de cette page, et nous y viendrons. D’abord, la méthode. Le 27 octobre 2026, nous avons mesuré sur Hugging Face la taille réelle des mêmes 7 modèles dans les deux formats, lu le code d’Ollama 0.40.11 là où il décide quel fichier votre Mac télécharge, et demandé 9 modèles à son catalogue exactement comme Ollama les demande. Les versions ce jour-là : mlx-lm 0.32.2 avec mlx 0.32.4, llama.cpp v0.7.0, Ollama 0.40.11 et LM Studio 0.4.26. Ce que nous n’avons pas fait, c’est chronométrer MLX contre llama.cpp sur un Mac à nous : vous ne trouverez donc pas ici de vainqueur en vitesse, et nous expliquons pourquoi plus bas.
 MLX (mlx-lm)Fiche logiciel
 llama.cppFiche logiciel
| MLX | GGUF | |
|---|---|---|
| Ce que c’est | Le framework d’apprentissage automatique d’Apple et son format de modèle : un dossier avec config.json, le tokeniseur et les poids en fichiers safetensors |
Le format créé par llama.cpp : 1 fichier avec les poids, le tokeniseur et les réglages (les gros modèles arrivent découpés en parties) |
| Où il tourne | Mac Apple Silicon sous macOS 14 ou plus récent ; sous Linux, avec CUDA ou le processeur seul via des paquets supplémentaires | Windows, macOS (processeur seul sur les Mac Intel), Linux et Android |
| Programmes qui l’exécutent | mlx-lm, le moteur MLX de LM Studio et Ollama sur Apple Silicon | llama.cpp, LM Studio et Ollama ; pas mlx-lm |
| Versions au 27 octobre 2026 | mlx-lm 0.32.2, mlx 0.32.4 | llama.cpp v0.7.0 (compilation b11669) |
| Niveaux de compression | 2, 3, 4, 5, 6 ou 8 bits, plus mxfp4, nvfp4 et mxfp8, des recettes mixtes et des versions DWQ | 25 fichiers pour Qwen3 8B dans un seul dépôt, de IQ1_S à Q8_0 et BF16 |
| Le même modèle en 4 bits (Qwen3 Coder 30B) | 16,00 Gio, 4,50 bits par poids | 17,28 Gio en Q4_K_M, 4,86 bits par poids |
| Modèles qui comprennent les images | La partie image voyage dans le même dossier | Un fichier mmproj à part, 0,87 Gio pour Qwen3.6 27B |
| Dans Ollama 0.40.11 | Téléchargé par un Mac Apple Silicon quand l’étiquette a une version MLX | Téléchargé partout ailleurs, et sur Mac quand l’étiquette n’a pas de version MLX |
| Faire le vôtre | mlx_lm.convert -q à partir des poids d’origine |
Le script convert_hf_to_gguf.py du dépôt de llama.cpp, puis son outil de quantification |
| Serveur local | mlx_lm.server sur 127.0.0.1:8080 |
llama serve sur 127.0.0.1:9931 |
| Vitesse | Pas mesurée par nous | Pas mesurée par nous |
2 formats et 4 programmes : qui lit quoi
La comparaison s’embrouille parce que MLX désigne 2 choses à la fois. C’est le framework d’Apple, la couche de calcul qui travaille sur la puce graphique du Mac en profitant de sa mémoire unifiée, et c’est aussi le nom qu’on donne aux modèles convertis pour lui. GGUF n’est qu’un format de fichier, celui qu’a inventé llama.cpp, et les 3 programmes de cette page qui le lisent embarquent llama.cpp.
Sur un Mac, 4 programmes se partagent la lecture, et chacun choisit son camp :
- mlx-lm exécute MLX et rien d’autre. Il charge un dossier avec
config.jsonet des fichiersmodel*.safetensors; un*.ggufne figure même pas dans la liste des fichiers qu’il télécharge. Il sait exporter un modèle en GGUF, mais seulement les modèles de type Mistral, Mixtral et Llama en fp16. - llama.cpp exécute GGUF et rien d’autre, sur la puce graphique du Mac via Metal. Un modèle en safetensors doit d’abord être converti.
- LM Studio exécute les deux. Sa recherche affiche GGUF et MLX côte à côte ; le GGUF part vers son moteur llama.cpp et le MLX vers son propre moteur MLX, open source sous licence MIT.
- Ollama exécute aussi les deux, mais choisit à votre place : sur un Mac Apple Silicon, il télécharge la version MLX d’un modèle quand elle existe, sinon la version GGUF.
 LM StudioFiche logiciel
 OllamaFiche logiciel
« MLX ou GGUF ? », ce sont donc en réalité 2 questions : quel fichier, et quel programme va l’exécuter. Si le programme est llama.cpp, la réponse est GGUF et la page s’arrête là. Le plus amusant commence avec les 3 autres.
Même modèle, 2 tailles : ce que nous avons mesuré sur 7 modèles
Nous avons pris 7 modèles qui existent dans les deux formats et additionné les octets de tous leurs fichiers de poids sur Hugging Face le 27 octobre 2026 : la version MLX 4 bits de l’organisation mlx-community face au GGUF Q4_K_M des dépôts qu’utilise déjà notre trouveur de modèle, pour que les chiffres puissent être recoupés avec lui.
| Modèle | MLX 4 bits | GGUF Q4_K_M | Écart |
|---|---|---|---|
| Qwen3 8B | 4,29 Gio | 4,68 Gio | −0,39 Gio (−8,4 %) |
| Qwen3.5 9B* | 5,54 Gio | 5,29 Gio | +0,25 Gio (+4,7 %) |
| Gemma 4 12B | 6,28 Gio | 6,63 Gio | −0,35 Gio (−5,3 %) |
| gpt-oss-20b | 10,41 Gio | 10,83 Gio | −0,42 Gio (−3,8 %) |
| Qwen3.6 27B* | 14,95 Gio | 15,66 Gio | −0,71 Gio (−4,5 %) |
| Qwen3 Coder 30B A3B | 16,00 Gio | 17,28 Gio | −1,28 Gio (−7,4 %) |
| Qwen3.6 35B A3B* | 19,00 Gio | 20,61 Gio | −1,61 Gio (−7,8 %) |
Mesuré : taille des fichiers de poids sur Hugging Face le 27 octobre 2026, en Gio (l’unité de notre trouveur de modèle). MLX : mlx-community, versions 4 bits (affine, groupes de 64 ; pour gpt-oss-20b, sa version MXFP4-Q4). GGUF : unsloth, Q4_K_M (UD-Q4_K_M pour Qwen3.6 35B A3B, le fichier que compte notre catalogue). *Le dossier MLX de ces 3 modèles inclut la partie qui lit les images ; en GGUF, c’est un fichier à part de 0,84 à 0,87 Gio, utile seulement pour les images. Le dossier MLX de Gemma 4 12B embarque aussi une petite partie image et audio ; son fichier image GGUF séparé pèse 0,16 Gio.
MLX sort plus léger dans 6 cas sur 7, de 0,35 à 1,61 Gio. L’intrus, Qwen3.5 9B, ne fait pas exception à la règle : son dossier MLX embarque le lecteur d’images, et dès qu’on ajoute au GGUF son fichier image séparé (0,86 Gio), MLX redevient plus léger, de 9,9 %.
Lequel répond le mieux « en 4 bits » ? Q4_K_M dépense plus de bits, mais ce que cela change dans les réponses, nous ne l’avons pas mesuré, et la taille d’un fichier ne le dit pas. Ce que nous pouvons vous dire, c’est que les 2 étiquettes, « 4-bit » et « Q4 », ne décrivent pas la même chose.
Ce qui tient dans votre Mac : le même calcul, avec MLX presque toujours du côté sûr
Notre trouveur de modèle et nos fiches matériel additionnent le fichier GGUF Q4_K_M, la mémoire du contexte pour la longueur choisie et une marge pour le programme, et mettent de côté 3 Gio de mémoire unifiée pour macOS et vos applications ouvertes. Ces tailles sont celles du GGUF. Dans 6 des 7 modèles ci-dessus, la version MLX 4 bits pesait moins : pour ceux-là, le calcul du trouveur reste du côté sûr pour ce qui est du fichier ; Qwen3.5 9B, avec son lecteur d’images intégré, pèse 0,25 Gio de plus en MLX. Pour un modèle que nous n’avons pas mesuré dans les deux formats, vérifiez la taille des fichiers MLX avant de vous fier au calcul fait sur le GGUF.
Le contexte coûte la même chose des deux côtés. mlx-lm garde son cache de contexte en pleine précision, sauf si vous demandez --kv-bits, et llama.cpp le garde sur 16 bits par défaut : la mémoire que prend une longue conversation dépend du modèle et de la longueur, pas du format.
Il y a un piège propre à MLX. mlx-lm demande à macOS combien de mémoire il recommande pour la puce graphique et en verrouille jusqu’à cette quantité, et sur un Mac de 16 Go cette recommandation reste bien en dessous des 13 Gio que nos fiches laissent au modèle. Quand les poids dépassent 90 % de ce chiffre, mlx-lm vous prévient avant le premier jeton ; au-delà, tout ralentit ou plante. Les chiffres réels d’un Mac de 16 Go, l’avertissement et la façon de relever ce plafond sont dans notre guide des erreurs de MLX. Et si vous préférez mesurer plutôt que calculer, mlx_lm.generate affiche Peak memory (en Go de 10^9 octets) après chaque réponse : ce que le modèle et la conversation ont réellement occupé sur votre Mac.
Ollama choisit pour vous : MLX sur Mac, GGUF partout ailleurs
Voici la découverte curieuse. Depuis la 0.40.0, une étiquette du catalogue d’Ollama peut être une liste à 2 versions : une MLX, faite de safetensors, et une GGUF. Dans le code de la 0.40.11, la fonction runnerPreferences() décide de l’ordre : sous macOS avec Apple Silicon, MLX d’abord, puis llama.cpp ; sur tous les autres systèmes, llama.cpp d’abord et MLX en dernier. Au chargement, un GGUF part vers le serveur de llama.cpp lui-même et un modèle MLX vers l’exécuteur MLX d’Ollama.
Nous avons demandé 9 étiquettes au catalogue d’Ollama avec la même requête qu’Ollama envoie, celle qui accepte une liste. 6 sont revenues avec 2 versions, et voici ce que télécharge chaque machine :
| Étiquette | Mac Apple Silicon (MLX) | Windows, Linux, Mac Intel (GGUF) |
|---|---|---|
qwen3.5:9b |
7,11 Gio | 6,10 Gio |
gemma4:e4b |
8,81 Gio | 6,13 Gio |
gemma4:12b |
7,18 Gio | 7,47 Gio |
qwen3.6:27b |
17,49 Gio | 16,55 Gio |
qwen3.6:35b |
21,98 Gio | 21,07 Gio |
flint:latest |
21,03 Gio | 21,29 Gio |
Mesuré : somme des couches de chaque version dans le registre d’Ollama le 27 octobre 2026, parties image et d’appoint comprises. Les 3 autres étiquettes demandées, qwen3:8b, gpt-oss:20b et qwen3-coder:30b, n’ont qu’une version GGUF, le même fichier sur toutes les machines.
Regardez bien : dans 4 cas sur 6, le Mac télécharge le fichier le plus gros, jusqu’à 2,68 Gio de plus pour gemma4:e4b. La raison : les versions MLX d’Ollama ne sont pas les versions 4 bits de mlx-community de la section précédente. La plupart sont produites avec l’outil ModelOpt de NVIDIA en NVFP4, un format 4 bits propre à NVIDIA, et certaines gardent des parties du modèle sur 8 bits ou plus ; la version MLX de Flint utilise de simples entiers sur 4 bits. « MLX est plus léger » vaut donc pour les fichiers que vous choisissez vous-même, pas pour ce qu’Ollama choisit à votre place.

Les étiquettes à une seule version GGUF tournent aussi sur Mac : Ollama les confie à llama.cpp, qui utilise la puce graphique via Metal. Ce n’est pas vous qui choisissez le moteur ; c’est l’étiquette. Le moteur MLX d’Ollama est son propre code, pas mlx-lm, et notre comparatif MLX vs Ollama vérifie quels modèles connaît chacun des deux.
Niveaux de compression : 25 fichiers GGUF contre une poignée de versions MLX
Ici, GGUF gagne sur le choix. Pour Qwen3 8B, un seul dépôt GGUF propose 25 fichiers : les i-quants de IQ1_S à IQ4_NL, les k-quants de Q2_K à Q6_K, Q4_1, Q8_0 et BF16, plus des versions mixtes « XL ». Cette échelle très fine permet de caser un modèle dans la mémoire exacte dont vous disposez, un barreau à la fois. Le poids de chaque barreau, sa vitesse d’écriture et son écart avec l’original, nous les avons mesurés dans notre guide de la quantification GGUF : sur Qwen2.5 1.5B, Q4_K_M a fait le même premier choix que le modèle non quantifié pour 89 % des tokens.
Côté MLX, l’organisation mlx-community propose Qwen3 8B en 3, 4, 6 et 8 bits et en bf16, plus quelques versions 4 bits spéciales : AWQ et DWQ. DWQ est l’astuce maison de mlx-lm : on entraîne un modèle déjà compressé à imiter l’original, si bien qu’il garde la taille du 4 bits tout en essayant de regagner une partie de ce que la compression a enlevé. Combien il regagne, nous ne l’avons pas mesuré.
Convertir un modèle vous-même est plus simple en MLX. 1 commande télécharge les poids d’origine et les compresse :
mlx_lm.convert --model Qwen/Qwen3-8B -qSeul, -q signifie 4 bits par groupes de 64, en mode affine ; --q-bits change le nombre de bits, --q-mode accepte mxfp4, nvfp4 et mxfp8, et --quant-predicate prend 4 recettes mixtes, de mixed_2_6 à mixed_4_6. Pour GGUF, vous passez le script convert_hf_to_gguf.py du dépôt de llama.cpp, puis son outil de quantification. Dans les deux cas, vous téléchargez d’abord les poids d’origine : environ 15 Gio pour un modèle 8B en BF16.
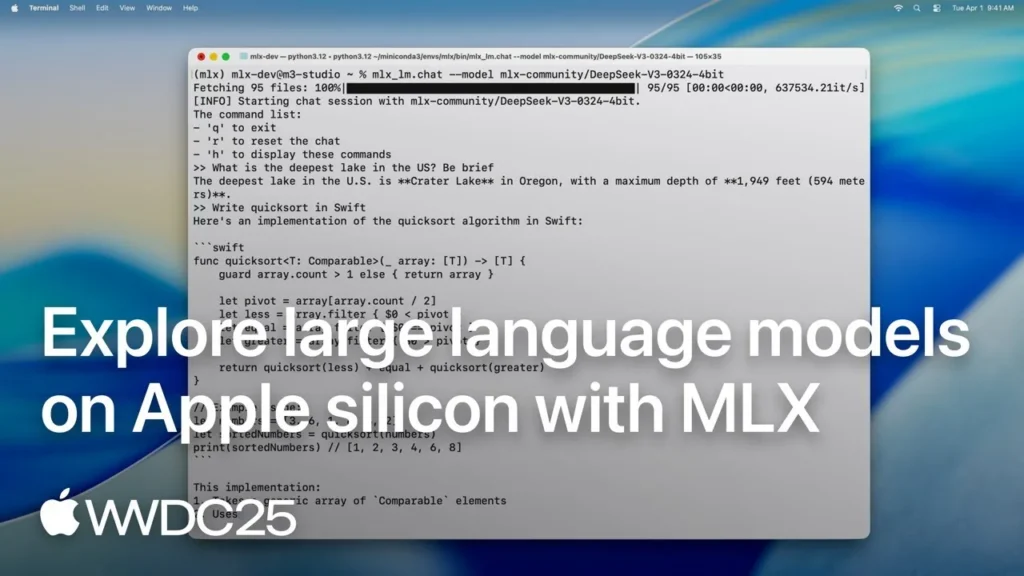
Si vous préférez voir avant de faire, la session d’Apple sur les grands modèles de langage avec MLX montre mlx-lm en train de générer du texte et, dans son chapitre sur la quantification, ce même mlx_lm.convert. Elle a été enregistrée avec un mlx-lm plus ancien : là où ses options et cette page diffèrent, cette page suit la 0.32.2.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Vitesse : pourquoi cette page ne désigne pas de vainqueur
Nous aimerions beaucoup vous donner un chiffre ici, et nous n’allons pas l’inventer. Nous n’avons pas mesuré MLX contre llama.cpp sur un Mac à nous, et un chiffre de vitesse n’a de sens qu’avec la machine, le modèle, la compression, le contexte et les 2 versions écrits à côté. Les deux tournent sur la même puce graphique et avec la même mémoire, et MLX est le framework qu’Apple conçoit pour ses propres puces ; c’est une raison de l’essayer, pas une mesure.
La bonne nouvelle, c’est que vous pouvez trancher sur votre propre Mac en 2 exécutions. mlx_lm.generate affiche à chaque exécution les jetons par seconde pour la lecture de la question et pour l’écriture de la réponse ; donnez à llama.cpp le même modèle en GGUF et la même question, et croyez votre machine plutôt que n’importe quel graphique, le nôtre compris.
Si vous voulez voir des moteurs côte à côte avant d’essayer, ce test fait passer 5 modèles par 3 moteurs d’inférence sur un Mac mini M6. Ses chiffres viennent de sa machine et de ses versions, qui ne sont pas celles de cette page.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Portabilité, portes ouvertes et ce que chacun envoie
Un fichier GGUF va partout : le même fichier tourne dans llama.cpp sous Windows, sous Linux, sur un Mac Intel ou sur un téléphone Android, ainsi que dans LM Studio et Ollama. Un dossier MLX est fait pour Apple Silicon. Le framework mlx existe aussi pour Linux avec CUDA ou le processeur seul, et mlx-lm y propose les extras cuda12, cuda13 et cpu, mais sous Windows pip install mlx-lm installe les outils sans le moteur. Si vos modèles vivent sur un disque partagé avec un PC, c’est GGUF qui fonctionne des deux côtés.
Le format lui-même n’écoute personne et n’envoie rien : c’est le programme qui le fait. Chacun ouvre une porte différente sur votre machine, et d’origine, toutes uniquement sur la machine elle-même :
- mlx-lm :
mlx_lm.serversur127.0.0.1:8080, sans clé et avec un CORS ouvert à n’importe quelle page web. De lui-même, il ne passe aucun appel ; la bibliothèque Hugging Face qui lui sert à télécharger demande à huggingface.co si un modèle a changé chaque fois que vous le chargez par son nom, jusqu’à ce que vous définissiezHF_HUB_OFFLINE=1. - llama.cpp :
127.0.0.1:9931depuis la v0.7.0, sans clé sauf si vous ajoutez--api-key, CORS ouvert à n’importe quelle page web, et rien d’envoyé de lui-même. - LM Studio : son serveur sur
127.0.0.1:1234, avec le CORS désactivé par défaut. Selon son éditeur, l’application vérifie les mises à jour et ses moteurs se mettent à jour tout seuls ; son code est fermé, c’est donc tout ce qu’on peut en dire de l’extérieur. - Ollama :
127.0.0.1:11434, CORS ouvert seulement aux pages de localhost, 127.0.0.1 et 0.0.0.0. Avecollama serveseul, 2 types d’appel vers ollama.com, queOLLAMA_NO_CLOUD=1coupe ; avec l’application de bureau, 4.

Chaque destination, avec sa source et sa date, figure sur nos pages consacrées à MLX, llama.cpp, LM Studio et Ollama.
Ce que nous téléchargerions, selon votre profil
- Un Mac Apple Silicon et une fenêtre pour discuter : LM Studio, avec les versions MLX quand elles existent. Vous avez en général le fichier le plus léger, et le GGUF est à 1 clic quand un modèle n’a pas de version MLX.
- Un Mac et le terminal : mlx-lm avec les versions 4 bits de mlx-community ; notre guide d’installation de MLX vous mène de l’installation au serveur.
- Un Mac avec Ollama : laissez-le choisir, mais comptez le téléchargement : sur 4 des 6 étiquettes que nous avons mesurées, sa version MLX est la plus grosse.
- Les mêmes modèles sur un Mac et un PC, ou un Mac Intel : GGUF, avec llama.cpp, LM Studio ou Ollama.
- Peu de mémoire, et le modèle doit tenir au gigaoctet près : GGUF, pour son échelle de 25 fichiers.
- Vos propres compressions ou un affinage sur le Mac : MLX, avec
mlx_lm.convertet son DWQ.
Si quelque chose coince en route, nous avons des guides pour quand MLX ne fonctionne pas et quand llama.cpp ne fonctionne pas. Vous hésitez entre les programmes plutôt qu’entre les fichiers ? Nos comparatifs LM Studio vs Ollama et llama.cpp vs Ollama les mettent face à face, et le trouveur de modèle vous dit quels modèles tiennent dans votre Mac. Si le choix se joue entre mlx-lm et llama.cpp eux-mêmes, notre comparatif MLX vs llama.cpp compte lesquels de nos 27 modèles chaque moteur connaît.