Accueil›Matériel›Mac mini avec M6 et 32 Go unifiés
Mac mini avec M6 et 32 Go unifiés
Puce Apple32 GiB170 GB/s5,5 TFLOPS
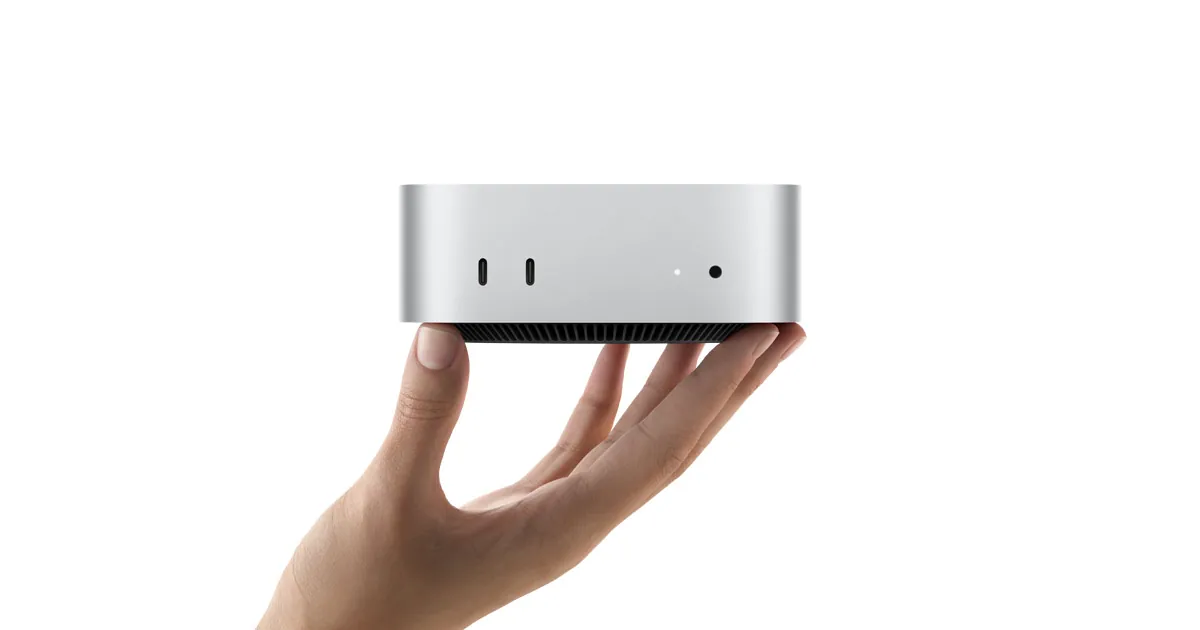
Une fois que le système a pris sa part, cette machine laisse 29,00 Gio au modèle : de quoi accueillir 19 des 26 modèles que nous mesurons à la compression de référence, et le plus lourd qui y tient est nemotron-3.5-lightning-30b. Et sa vitesse de réponse ? Ce n’est pas la puce qui la dicte, ce sont ses 170 GB/s de bande passante mémoire.
Reste pour le modèle
Estimation maison
Bande passante mémoire
Déclaré par le fabricant
Modèles qui tiennent
Mesuré par Local AI Scope
Vidéos : Mac mini avec M6 et 32 Go unifiés 4
Les meilleures démonstrations que nous avons trouvées. Appuyez et la vidéo s’ouvre ici.
Les vidéos sont sur YouTube et rien ne se charge depuis YouTube tant que vous n’appuyez pas (mode sans cookies). La miniature est servie par nous.
La mémoire réellement utilisable
La mémoire unifiée est partagée avec le système d’exploitation et tout ce que vous avez ouvert. La réserve indiquée ici est volontairement prudente ; vous pouvez la modifier dans l’outil.
| Mémoire | Gio |
|---|---|
| Mémoire de la machine | 32 |
| Réservée au système | −3,00 |
| Reste pour le modèle | 29,00 |
Il n’existe pas de Mac mini avec M6 et 64 Go. L’annonce d’Apple elle-même indique 16 Go de mémoire unifiée de série, configurables jusqu’à 32 Go. La configuration de 64 Go est celle de l’autre Mac mini annoncé le même jour, celui à M5 Pro, une puce différente avec un plafond différent. Ce plafond décide si un modèle tient tout court : c’est donc le chiffre le plus important de cette page, et il vaut 32.
Bande passante mémoire
Ce sont deux limites différentes, et il est facile de les confondre. Pendant que le modèle écrit sa réponse, c’est la bande passante qui commande : chaque token oblige à relire les poids qu’il utilise (tous dans un modèle dense ; dans un mélange d’experts, les couches communes et seulement les experts actifs), si bien que les tokens par seconde valent à peu près la bande passante divisée par cette quantité. Pendant que le modèle lit votre document, c’est le calcul qui commande : l’entrée est traitée d’un seul coup. D’où un portable sans GPU qui met des minutes avant le premier mot puis écrit à un rythme acceptable.
170 GB/s — Déclaré par le fabricant · vérifié sur la page du fabricant le 2026-08-27 (Source).
Les 170 GB/s sont ceux du M6. Apple a annoncé le même jour un second Mac mini, celui à M5 Pro : une autre puce, 307 GB/s et jusqu’à 64 Go, à partir de 1 699 dollars. Et Apple qualifie le M6 de « première puce de 2 nanomètres » sans nommer de fondeur : le procédé précis que répète la presse n’est pas la parole d’Apple, donc il ne figure pas ici.
Calcul: 5,5 TFLOPS (estimation pour cette classe de machine) — Estimé · le fabricant ne publie ce chiffre nulle part ; le nôtre est une estimation prudente, pas une spécification. Les chiffres de cette ligne ne proviennent pas tous de la même mesure selon la machine, car chaque fabricant en publie une différente. Comparez-les d’une machine à l’autre en le sachant.
Quels modèles tiennent ici, et lesquels non
Tenir signifie que trois choses tiennent à la fois dans la mémoire restante : le fichier du modèle, sa mémoire de contexte et la marge de travail du runtime. La mémoire de contexte est calculée à partir du schéma d’attention que chaque modèle déclare, couche par couche, et non de la formule générique : c’est pourquoi des modèles que cette formule jugerait impossibles tiennent ici.
| Modèle | Compression affichée | Taille du modèle | 8k | 32k | 128k | Plus grand contexte qui tient |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | oui | oui | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | oui | oui | oui | 128k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | oui | oui | oui | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | oui | oui | oui | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | oui | oui | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | oui | oui | oui | 128k |
| qwen3.5-9b | Q4_K_M |
5,29 GiB | oui | oui | oui | 256k |
| gemma4-12b | Q4_K_M |
6,63 GiB | oui | oui | oui | 256k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | oui | oui | oui | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | oui | oui | non | 64k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | oui | oui | oui | 128k |
| muse-glimmer-30b | Q4_K_M |
15,61 GiB | oui | oui | oui | 128k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | oui | oui | oui | 128k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | oui | oui | oui | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | oui | oui | non | 64k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | oui | oui | non | 64k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | oui | oui | oui | 128k |
| flint-40b | Q4_K_M |
23,61 GiB | oui | oui | non | 64k |
| nemotron-3.5-lightning-30b | Q4_K_M |
23,73 GiB | oui | oui | oui | 128k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | non | non | non | — |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | non | non | non | — |
| nemotron-3.5-super-120b | Q4_K_M |
65,29 GiB | non | non | non | — |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | non | non | non | — |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | non | non | non | — |
| glm-5.3-flash | Q4_K_M |
187,04 GiB | non | non | non | — |
| glm-5.2 | Q4_K_M |
433,83 GiB | non | non | non | — |
Les tailles sont celles des fichiers réellement publiés à la compression de référence, un palier par ligne : Q4_K_M lorsque l’auteur la publie, le voisin le plus proche sinon. Chaque ligne indique laquelle elle affiche. Q4_K_M est notre plancher de qualité : en dessous, la perte s’entend dans les réponses. Un modèle qui ne tiendrait ici qu’avec une compression plus agressive est classé comme ne tenant pas, à dessein. Un tiret dans une colonne de contexte signifie que le modèle n’offre pas ce contexte, il n’y a donc rien à faire tenir.
Modèles qui tiennent — 19 sur les 26 modèles mesurés
- qwen3-1.7b
Q4_K_M— contexte 32k tokens - qwen3-4b-2507
Q4_K_M— contexte 128k tokens - gemma4-e2b
Q4_K_M— contexte 128k tokens - gemma4-e4b
Q4_K_M— contexte 128k tokens - qwen3-8b
Q4_K_M— contexte 32k tokens - granite-4.2-8b
Q4_K_M— contexte 128k tokens - qwen3.5-9b
Q4_K_M— contexte 256k tokens - gemma4-12b
Q4_K_M— contexte 256k tokens - gpt-oss-20b
Q4_K_M— contexte 128k tokens - mistral-small-24b
Q4_K_M— contexte 64k tokens - qwen3.8-27b
Q4_K_M— contexte 128k tokens - muse-glimmer-30b
Q4_K_M— contexte 128k tokens - qwen3.6-27b
Q4_K_M— contexte 128k tokens - gemma4-26b-a4b
Q4_K_M— contexte 256k tokens - gemma4-31b
Q4_K_M— contexte 64k tokens - qwen3-coder-30b
Q4_K_M— contexte 64k tokens - qwen3.6-35b-a3b
Q4_K_M— contexte 128k tokens - flint-40b
Q4_K_M— contexte 64k tokens - nemotron-3.5-lightning-30b
Q4_K_M— contexte 128k tokens
Modèles qui ne tiennent pas — 7 sur les 26 modèles mesurés
- gpt-oss-120b
Q4_K_M— il manque 30,28 GiB - llama4-scout-17b
Q4_K_M— il manque 33,30 GiB - nemotron-3.5-super-120b
Q4_K_M— il manque 37,00 GiB - qwen3.8-flash-next
IQ4_XS— il manque 59,02 GiB - deepseek-v4-flash
IQ4_XS— il manque 99,29 GiB - glm-5.3-flash
Q4_K_M— il manque 158,80 GiB - glm-5.2
Q4_K_M— il manque 406,12 GiB
Les machines voisines
- Mac avec M4 Pro et 24 Go — 21,00 Gio pour le modèle, 16 / 26 modèles
- Station de travail avec RTX 4090 24 Go — 23,20 Gio pour le modèle, 17 / 26 modèles
- Mini-PC avec NPU et 32 Go LPDDR5X — 29,00 Gio pour le modèle, 19 / 26 modèles
- Serveur avec 2× RTX 3090 (48 Go) — 47,20 Gio pour le modèle, 19 / 26 modèles
La même machine avec une autre mémoire
- Mac mini avec M6 et 16 Go unifiés — 13,00 Gio pour le modèle, 9 / 26 modèles
Prix et disponibilité
Ce que coûte une machine pèse autant que ce qui y tient : le prix a donc sa place sur cette page. Ci-dessous, uniquement ce que publie le fabricant, avec le marché concerné et le jour de la lecture.
À partir de 1.299 $ (États-Unis), publié le 2026-09-23 (Source). Déclaré par le fabricant
C’est le prix de cette configuration exacte : 32 Go avec le disque d’entrée de 256 Go. L’annonce ne cite que 899 $, ceux de la version 16 Go ; les 32 Go coûtent donc 400 $ de plus, et le palier 24 Go est à 1 099 $. Apple ne publie pas de prix en euros : ce chiffre est en dollars des États-Unis.
Ce que nous gagnons sur cette page
Rien, aujourd’hui. Cette page ne contient aucun lien d’affiliation, et aucun accord commercial ne se cache derrière ses chiffres. Si un lien d’achat y apparaît un jour, il sera signalé comme tel et la commission sera déclarée dans ce même bloc. Deux règles ne changeront pas ce jour-là : le classement de ce site est calculé avant toute disponibilité commerciale, et « meilleur » ne veut jamais dire « paie le plus ».