Matériel
Choisir la machine qui fera tourner une IA chez vous, c’est la partie la plus amusante, jusqu’à ce qu’on arrive aux petits caractères. Chaque fiche matériel répond à ce que la fiche technique élude : combien de mémoire reste vraiment une fois que le système a pris sa part (il se sert toujours en premier), et lesquels des modèles que nous mesurons tiennent dans ce qui reste, avec le contexte que chacun supporte. Deux listes par machine, ceux qui tiennent et ceux qui ne tiennent pas, pour voir ce qu’il ne faut PAS acheter.
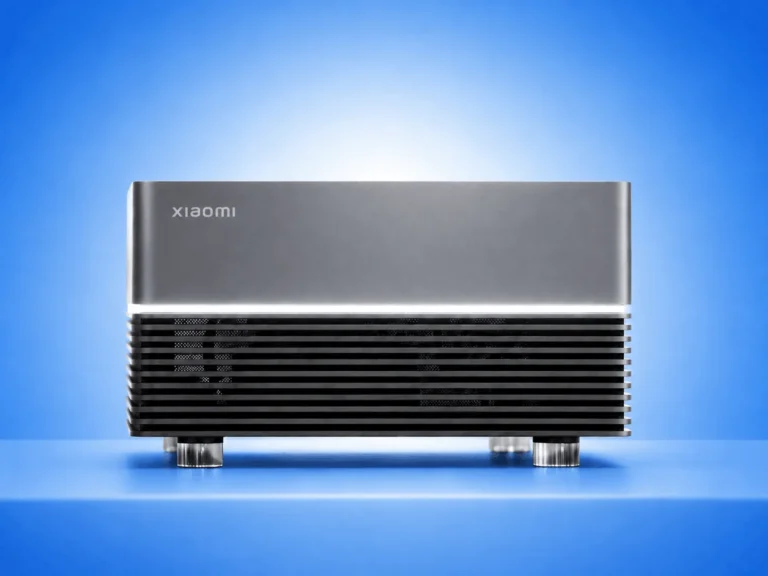 Prototype5Xiaomi AI Cube, 80 Go — prototype d’ingénierie80 Go
 4Mac mini avec M6 et 32 Go unifiés32 Go
 3Mac Studio avec M5 Max et 128 Go unifiés128 Go3Mac mini avec M5 Pro et 64 Go unifiés64 Go4Mac Studio avec M5 Ultra et 512 Go unifiés512 Go3Mac mini avec M6 et 16 Go unifiés16 Go
 3Mac avec M4 Max et 64 Go64 Go
 2Mac avec M4 Pro et 24 Go24 Go
 2Mac avec M4 et 16 Go unifiés16 Go
 2Station de travail avec RTX 4090 24 Go24 Go
 3PC avec RTX 3060 12 Go12 Go
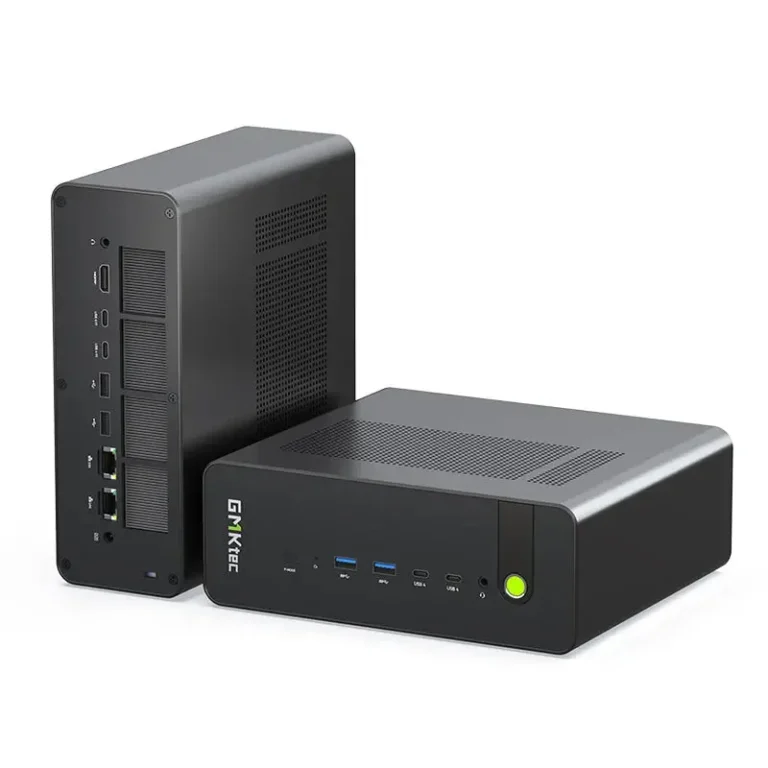 2PC avec Ryzen AI Max+ PRO 495 et 192 Go unifiés192 Go
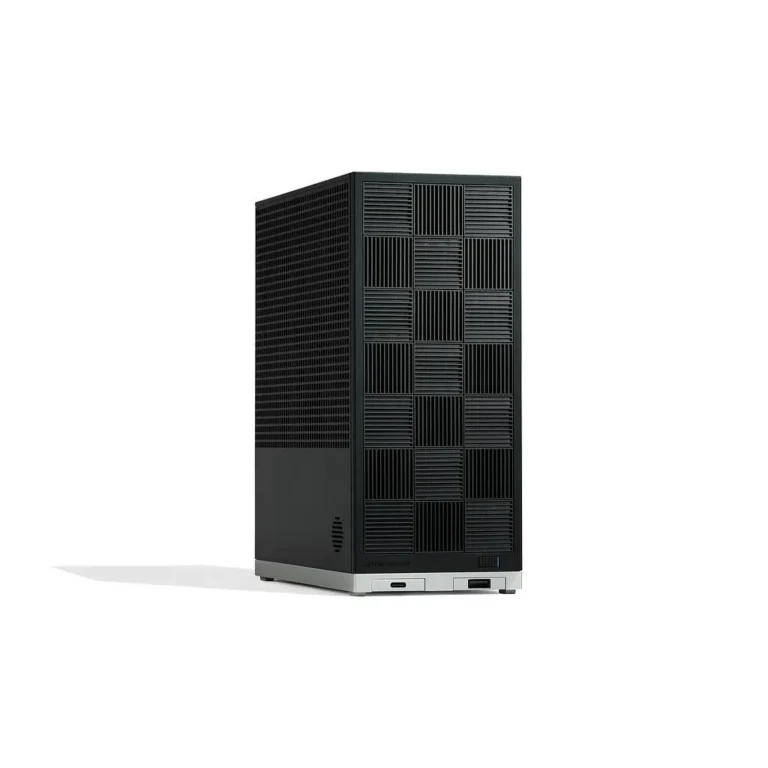 2PC avec Ryzen AI Max+ 395 et 128 Go unifiés128 Go2PC avec RTX 4060 8 Go8 GoPC avec RTX 4070 12 Go12 Go3Serveur avec 2× RTX 3090 (48 Go)48 GoType de machineMini-PC avec NPU et 32 Go LPDDR5X32 GoType de machinePortable de bureau, processeur seul, 16 Go16 Go
| Machine | Mémoire restante pour le modèle | Bande passante | Modèles qui tiennent à 8k | et à 32k | Plus grand modèle admis |
|---|---|---|---|---|---|
| PC avec RTX 4060 8 Go | 7,20 GiB | 272 GB/s dérivé, non publié | 7 / 26 | 3 / 26 | qwen3.5-9b 5,29 GiB |
| PC avec RTX 3060 12 Go | 11,20 GiB | 360 GB/s dérivé, non publié | 8 / 26 | 8 / 26 | gemma4-12b 6,63 GiB |
| PC avec RTX 4070 12 Go | 11,20 GiB | 504 GB/s dérivé, non publié | 8 / 26 | 8 / 26 | gemma4-12b 6,63 GiB |
| Mac avec M4 et 16 Go unifiés | 13,00 GiB | 120 GB/s déclaré par le fabricant | 9 / 26 | 9 / 26 | gpt-oss-20b 10,83 GiB |
| Mac mini avec M6 et 16 Go unifiés | 13,00 GiB | 153 GB/s déclaré par le fabricant | 9 / 26 | 9 / 26 | gpt-oss-20b 10,83 GiB |
| Portable de bureau, processeur seul, 16 Go | 13,00 GiB | 83 GB/s estimé | 9 / 26 | 9 / 26 | gpt-oss-20b 10,83 GiB |
| Mac avec M4 Pro et 24 Go | 21,00 GiB | 273 GB/s déclaré par le fabricant | 16 / 26 | 14 / 26 | qwen3-coder-30b 17,28 GiB |
| Station de travail avec RTX 4090 24 Go | 23,20 GiB | 1008 GB/s déclaré par le fabricant | 17 / 26 | 17 / 26 | qwen3.6-35b-a3b 20,61 GiB |
| Mac mini avec M6 et 32 Go unifiés | 29,00 GiB | 170 GB/s déclaré par le fabricant | 19 / 26 | 19 / 26 | nemotron-3.5-lightning-30b 23,73 GiB |
| Mini-PC avec NPU et 32 Go LPDDR5X | 29,00 GiB | 120 GB/s estimé | 19 / 26 | 19 / 26 | nemotron-3.5-lightning-30b 23,73 GiB |
| Serveur avec 2× RTX 3090 (48 Go) | 47,20 GiB | 936 GB/s déclaré par le fabricant | 19 / 26 | 19 / 26 | nemotron-3.5-lightning-30b 23,73 GiB |
| Mac avec M4 Max et 64 Go | 61,00 GiB | 546 GB/s déclaré par le fabricant | 20 / 26 | 20 / 26 | gpt-oss-120b 58,46 GiB |
| Mac mini avec M5 Pro et 64 Go unifiés | 61,00 GiB | 307 GB/s déclaré par le fabricant | 20 / 26 | 20 / 26 | gpt-oss-120b 58,46 GiB |
| Xiaomi AI Cube, 80 Go — prototype d’ingénierie | 77,00 GiB | 341 GB/s estimé | 22 / 26 | 22 / 26 | nemotron-3.5-super-120b 65,29 GiB |
| PC avec Ryzen AI Max+ 395 et 128 Go unifiés | 96,00 GiB | 256 GB/s dérivé, non publié | 23 / 26 | 23 / 26 | qwen3.8-flash-next 87,25 GiB |
| Mac Studio avec M5 Max et 128 Go unifiés | 125,00 GiB | 614 GB/s déclaré par le fabricant | 23 / 26 | 23 / 26 | qwen3.8-flash-next 87,25 GiB |
| PC avec Ryzen AI Max+ PRO 495 et 192 Go unifiés | 160,00 GiB | 273 GB/s dérivé, non publié | 24 / 26 | 24 / 26 | deepseek-v4-flash 127,28 GiB |
| Mac Studio avec M5 Ultra et 512 Go unifiés | 509,00 GiB | 1200 GB/s déclaré par le fabricant | 26 / 26 | 26 / 26 | glm-5.2 433,83 GiB |
Tenir signifie que le fichier du modèle, sa mémoire de contexte et la marge du runtime tiennent dans ce qui reste une fois que le système a pris sa part, en Q4_K_M ou à la compression la plus proche publiée par l’auteur. La bande passante porte sa provenance dans la cellule : 8 de ces 18 chiffres ne sont publiés nulle part par le fabricant, et nous le disons au lieu de les faire passer pour des spécifications.
Le Xiaomi AI Cube est un prototype, et dans le tableau sa bande passante est marquée estimé, pas déclaré par le fabricant. Cette vidéo (en anglais) explique pourquoi un chiffre de bande passante ne vaut que s’il appartient à la mémoire où loge le modèle. Dans notre tableau, chaque cellule de bande passante dit d’où vient son chiffre.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →