Accueil›Matériel›Mac Studio avec M5 Ultra et 512 Go unifiés
Mac Studio avec M5 Ultra et 512 Go unifiés
Puce Apple512 GiB1.200 GB/s36,8 TFLOPS
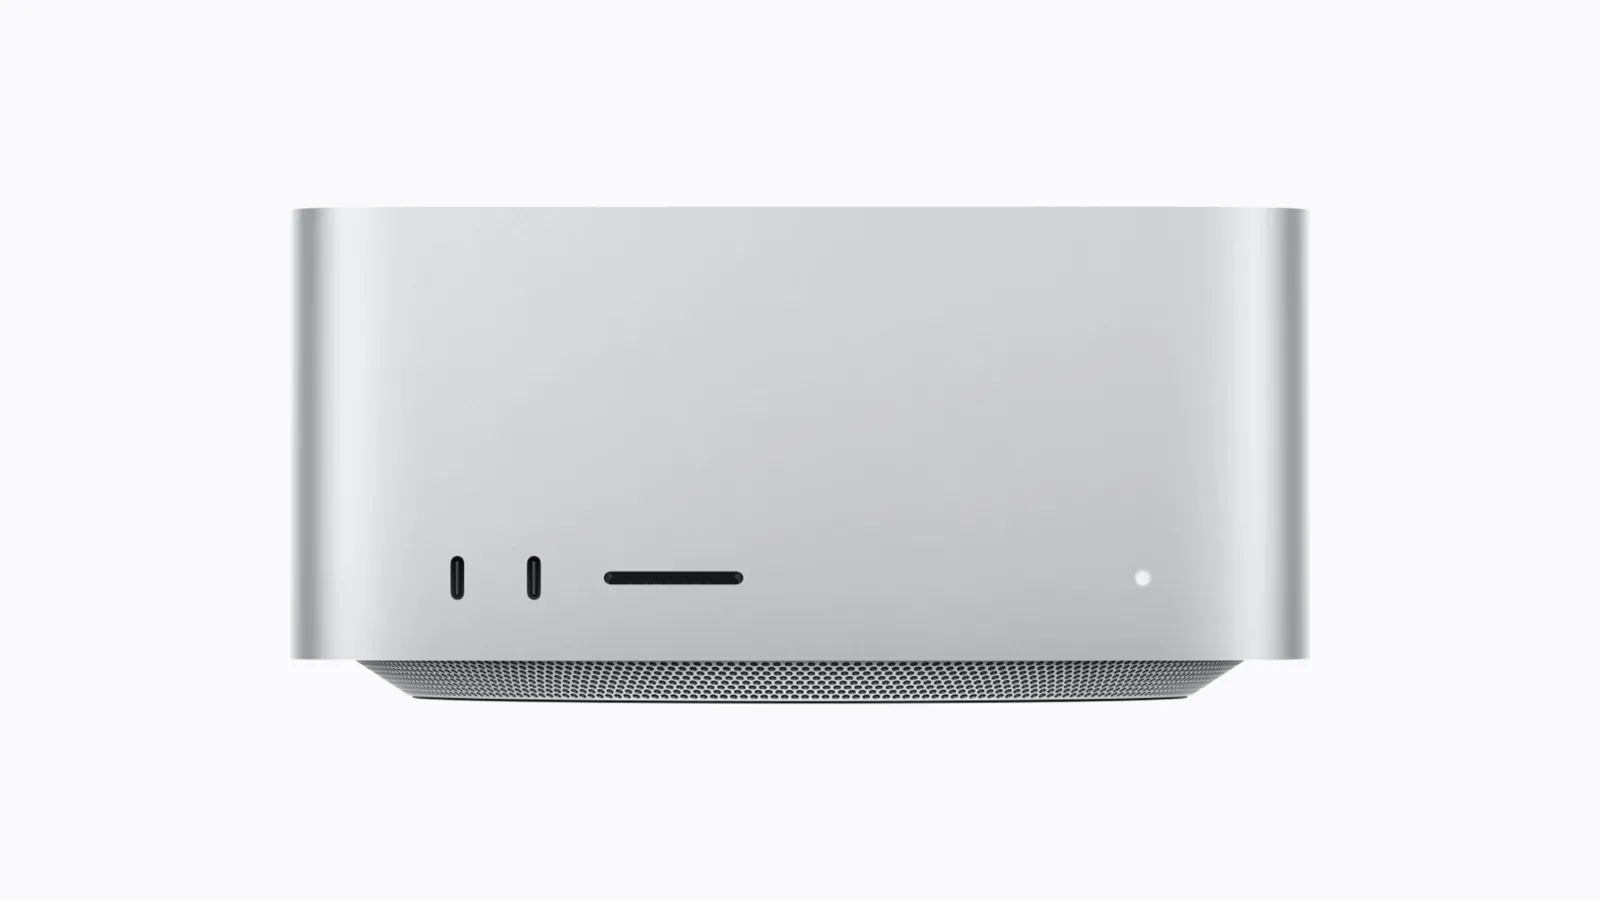
Une fois que le système a pris sa part, cette machine laisse 509,00 Gio au modèle : de quoi accueillir 27 des 28 modèles que nous mesurons à la compression de référence, et le plus lourd qui y tient est glm-5.2. Et sa vitesse de réponse ? Ce n’est pas la puce qui la dicte, ce sont ses 1.200 GB/s de bande passante mémoire.
Reste pour le modèle
Estimation maison
Bande passante mémoire
Déclaré par le fabricant
Modèles qui tiennent
Mesuré par Local AI Scope
Vidéos : Mac Studio avec M5 Ultra et 512 Go unifiés 4
Les meilleures démonstrations que nous avons trouvées. Appuyez et la vidéo s’ouvre ici.
Les vidéos sont sur YouTube et rien ne se charge depuis YouTube tant que vous n’appuyez pas (mode sans cookies). La miniature est servie par nous.
La mémoire réellement utilisable
La mémoire unifiée est partagée avec le système d’exploitation et tout ce que vous avez ouvert. La réserve indiquée ici est volontairement prudente ; vous pouvez la modifier dans l’outil.
| Mémoire | Gio |
|---|---|
| Mémoire de la machine | 512 |
| Réservée au système | −3,00 |
| Reste pour le modèle | 509,00 |
512 Go est le plafond, pas ce que l’on obtient au prix de départ. C’est la plus grande configuration proposée par Apple, une option sur mesure qui n’existe qu’avec la version de la puce à 36 cœurs CPU et 80 cœurs GPU, et la dernière à avoir été mise en vente, fin octobre 2026. Tout sur cette page est calculé sur 512 : si vous achetez une configuration inférieure, le tableau ci-dessous n’est pas le vôtre. C’est aussi la première machine de ce catalogue où tous les modèles mesurés tiennent, y compris glm-5.2 et ses 433,83 Gio, qu’aucune autre machine d’ici n’accepte.
Bande passante mémoire
Ce sont deux limites différentes, et il est facile de les confondre. Pendant que le modèle écrit sa réponse, c’est la bande passante qui commande : chaque token oblige à relire les poids qu’il utilise (tous dans un modèle dense ; dans un mélange d’experts, les couches communes et seulement les experts actifs), si bien que les tokens par seconde valent à peu près la bande passante divisée par cette quantité. Pendant que le modèle lit votre document, c’est le calcul qui commande : l’entrée est traitée d’un seul coup. D’où un portable sans GPU qui met des minutes avant le premier mot puis écrit à un rythme acceptable.
1.200 GB/s — Déclaré par le fabricant · vérifié sur la page du fabricant le 2026-08-31 (Source).
Les 1,2 To/s sont ceux du M5 Ultra. Apple a annoncé deux Mac Studio le même jour : l’autre embarque le M5 Max, une puce différente qui plafonne à 614 GB/s et 128 Go, à partir de 2 499 dollars. Appliquer la bande passante de l’Ultra au Max reviendrait à se tromper du simple au double. Et Apple ne publie aucun TFLOPS pour ses puces M — seulement des nombres de cœurs et des comparaisons avec sa propre génération précédente —, donc la ligne de calcul ci-dessous est un plancher maison, pas une spécification.
Calcul: 36,8 TFLOPS (estimation pour cette classe de machine) — Estimé · le fabricant ne publie ce chiffre nulle part ; le nôtre est une estimation prudente, pas une spécification. Les chiffres de cette ligne ne proviennent pas tous de la même mesure selon la machine, car chaque fabricant en publie une différente. Comparez-les d’une machine à l’autre en le sachant.
Quels modèles tiennent ici, et lesquels non
Tenir signifie que trois choses tiennent à la fois dans la mémoire restante : le fichier du modèle, sa mémoire de contexte et la marge de travail du runtime. La mémoire de contexte est calculée à partir du schéma d’attention que chaque modèle déclare, couche par couche, et non de la formule générique : c’est pourquoi des modèles que cette formule jugerait impossibles tiennent ici.
| Modèle | Compression affichée | Taille du modèle | 8k | 32k | 128k | Plus grand contexte qui tient |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | oui | oui | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | oui | oui | oui | 256k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | oui | oui | oui | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | oui | oui | oui | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | oui | oui | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | oui | oui | oui | 128k |
| qwen3.5-9b | Q4_K_M |
5,29 GiB | oui | oui | oui | 256k |
| gemma4-12b | Q4_K_M |
6,63 GiB | oui | oui | oui | 256k |
| phi-4 | Q4_K_M |
8,43 GiB | oui | — | — | 16k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | oui | oui | oui | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | oui | oui | oui | 128k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | oui | oui | oui | 256k |
| muse-glimmer-30b | Q4_K_M |
15,61 GiB | oui | oui | oui | 128k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | oui | oui | oui | 256k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | oui | oui | oui | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | oui | oui | oui | 256k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | oui | oui | oui | 256k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | oui | oui | oui | 256k |
| flint-40b | Q4_K_M |
23,61 GiB | oui | oui | oui | 256k |
| nemotron-3.5-lightning-30b | Q4_K_M |
23,73 GiB | oui | oui | oui | 256k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | oui | oui | oui | 128k |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | oui | oui | oui | 1024k |
| nemotron-3.5-super-120b | Q4_K_M |
65,29 GiB | oui | oui | oui | 1024k |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | oui | oui | oui | 256k |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | oui | oui | oui | 1024k |
| glm-5.3-flash | Q4_K_M |
187,04 GiB | oui | oui | oui | 1024k |
| glm-5.2 | Q4_K_M |
433,83 GiB | oui | oui | oui | 256k |
| mistral-large-4 | Q4_K_M |
591,21 GiB | non | non | non | — |
Les tailles sont celles des fichiers réellement publiés à la compression de référence, un palier par ligne : Q4_K_M lorsque l’auteur la publie, le voisin le plus proche sinon. Chaque ligne indique laquelle elle affiche. Q4_K_M est notre plancher de qualité : en dessous, la perte s’entend dans les réponses. Un modèle qui ne tiendrait ici qu’avec une compression plus agressive est classé comme ne tenant pas, à dessein. Un tiret dans une colonne de contexte signifie que le modèle n’offre pas ce contexte, il n’y a donc rien à faire tenir.
Ce qui change entre Q8_0, Q4_K_M et Q3_K_M (taille, vitesse et qualité), nous l’avons mesuré nous-mêmes dans notre guide de la quantification GGUF.
Modèles qui tiennent — 27 sur les 28 modèles mesurés
- qwen3-1.7b
Q4_K_M— contexte 32k tokens - qwen3-4b-2507
Q4_K_M— contexte 256k tokens - gemma4-e2b
Q4_K_M— contexte 128k tokens - gemma4-e4b
Q4_K_M— contexte 128k tokens - qwen3-8b
Q4_K_M— contexte 32k tokens - granite-4.2-8b
Q4_K_M— contexte 128k tokens - qwen3.5-9b
Q4_K_M— contexte 256k tokens - gemma4-12b
Q4_K_M— contexte 256k tokens - phi-4
Q4_K_M— contexte 16k tokens - gpt-oss-20b
Q4_K_M— contexte 128k tokens - mistral-small-24b
Q4_K_M— contexte 128k tokens - qwen3.8-27b
Q4_K_M— contexte 256k tokens - muse-glimmer-30b
Q4_K_M— contexte 128k tokens - qwen3.6-27b
Q4_K_M— contexte 256k tokens - gemma4-26b-a4b
Q4_K_M— contexte 256k tokens - gemma4-31b
Q4_K_M— contexte 256k tokens - qwen3-coder-30b
Q4_K_M— contexte 256k tokens - qwen3.6-35b-a3b
Q4_K_M— contexte 256k tokens - flint-40b
Q4_K_M— contexte 256k tokens - nemotron-3.5-lightning-30b
Q4_K_M— contexte 256k tokens - gpt-oss-120b
Q4_K_M— contexte 128k tokens - llama4-scout-17b
Q4_K_M— contexte 1024k tokens - nemotron-3.5-super-120b
Q4_K_M— contexte 1024k tokens - qwen3.8-flash-next
IQ4_XS— contexte 256k tokens - deepseek-v4-flash
IQ4_XS— contexte 1024k tokens - glm-5.3-flash
Q4_K_M— contexte 1024k tokens - glm-5.2
Q4_K_M— contexte 256k tokens
Modèles qui ne tiennent pas — 1 sur les 28 modèles mesurés
- mistral-large-4
Q4_K_M— il manque 83,37 GiB
Les machines voisines
- Xiaomi AI Cube, 80 Go — prototype d’ingénierie — 77,00 Gio pour le modèle, 23 / 28 modèles
- PC avec Ryzen AI Max+ 395 et 128 Go unifiés — 96,00 Gio pour le modèle, 24 / 28 modèles
- Mac Studio avec M5 Max et 128 Go unifiés — 125,00 Gio pour le modèle, 24 / 28 modèles
- PC avec Ryzen AI Max+ PRO 495 et 192 Go unifiés — 160,00 Gio pour le modèle, 25 / 28 modèles
Prix et disponibilité
Ce que coûte une machine pèse autant que ce qui y tient : le prix a donc sa place sur cette page. Ci-dessous, uniquement ce que publie le fabricant, avec le marché concerné et le jour de la lecture.
À partir de 22.299 $ (États-Unis), publié le 2026-10-29 (Source). Déclaré par le fabricant
C’est le prix de la configuration 512 Go la moins chère : Apple ne la vend qu’avec la version du M5 Ultra à 36 cœurs CPU et 80 cœurs GPU, et au minimum avec 1 To de stockage. Les 5 499 $ de départ du Mac Studio avec M5 Ultra sont ceux de la base de 96 Go, à 30 cœurs CPU et 64 cœurs GPU ; les 512 Go sur lesquels cette fiche est calculée coûtent donc 16 800 $ de plus, et 22 799 $ avec 2 To de stockage. Apple ne publie pas de prix en euros : ce chiffre est en dollars des États-Unis.
Ce que nous gagnons sur cette page
Rien, aujourd’hui. Cette page ne contient aucun lien d’affiliation, et aucun accord commercial ne se cache derrière ses chiffres. Si un lien d’achat y apparaît un jour, il sera signalé comme tel et la commission sera déclarée dans ce même bloc. Deux règles ne changeront pas ce jour-là : le classement de ce site est calculé avant toute disponibilité commerciale, et « meilleur » ne veut jamais dire « paie le plus ».