Startseite›Rechner›Mac Studio mit M5 Ultra und 512 GB Unified Memory
Mac Studio mit M5 Ultra und 512 GB Unified Memory
Apple-Chip512 GiB1.200 GB/s36,8 TFLOPS
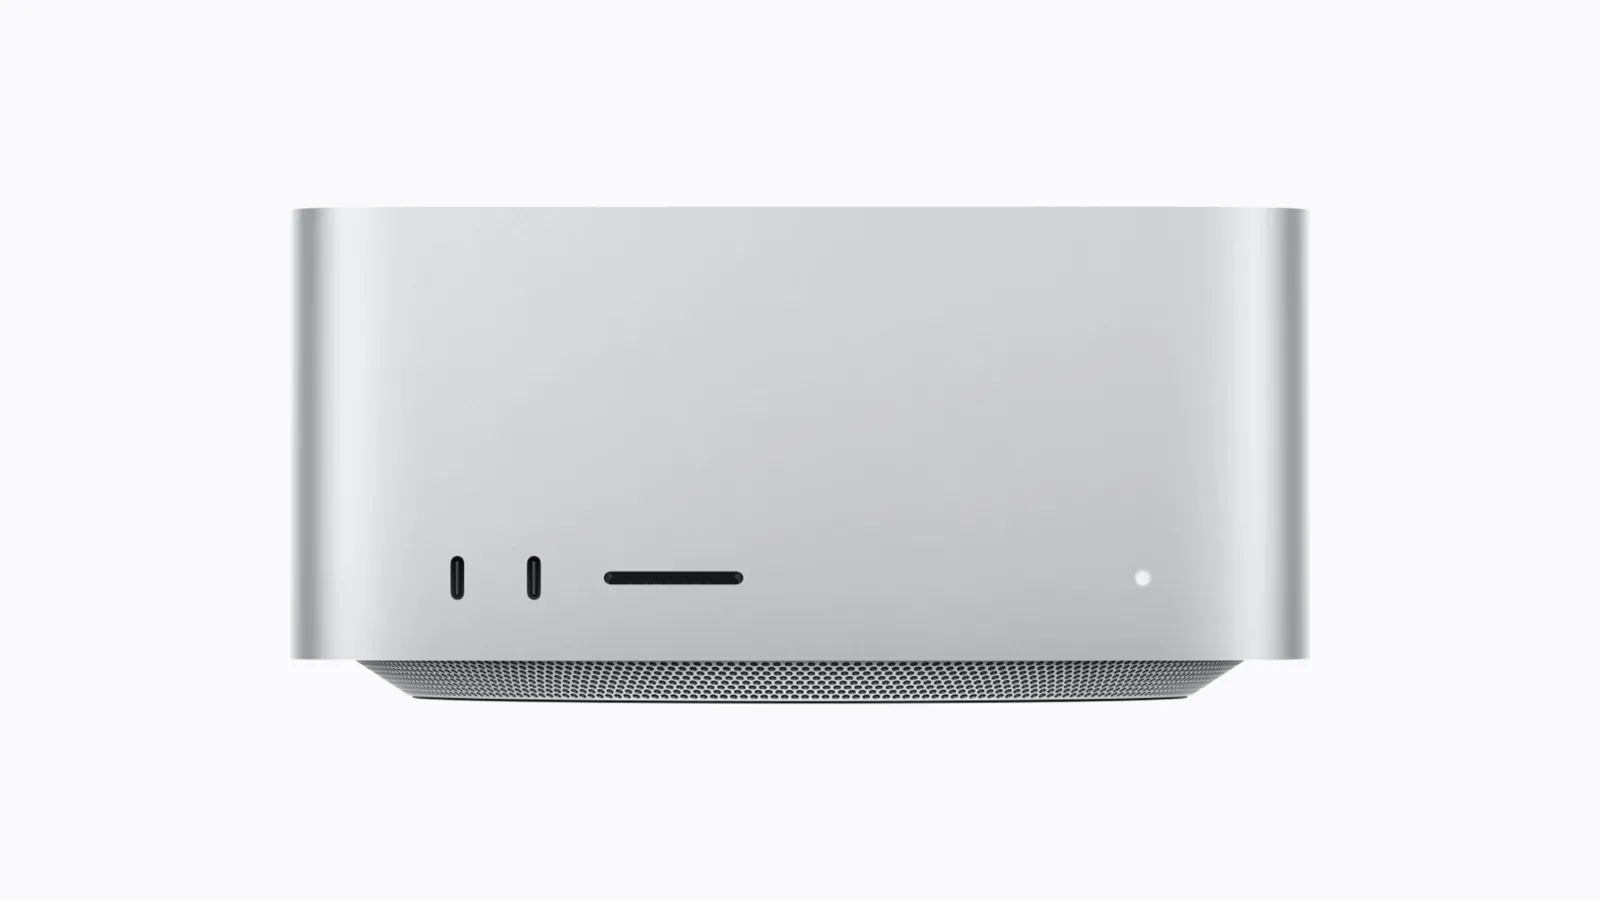
Sobald das System seinen Anteil genommen hat, bleiben diesem Rechner 509,00 GiB für das Modell: Platz für 27 der 28 Modelle, die wir bei der Referenzkompression messen, und das schwerste, das hineinpasst, ist glm-5.2. Und wie schnell antwortet er? Das entscheidet nicht der Chip, sondern seine 1.200 GB/s Speicherbandbreite.
Bleibt für das Modell
Eigene Schätzung
Speicherbandbreite
Herstellerangabe
Modelle, die passen
Von Local AI Scope gemessen
Videos: Mac Studio mit M5 Ultra und 512 GB Unified Memory 4
Die besten Vorführungen, die wir gefunden haben. Drücken Sie auf Play, und es läuft direkt hier.
Die Videos liegen bei YouTube, und von dort wird nichts geladen, bevor Sie auf Play drücken (Modus ohne Cookies). Das Vorschaubild kommt von uns.
Der Speicher, den Sie wirklich nutzen können
Der vereinheitlichte Speicher wird mit dem Betriebssystem und allem Geöffneten geteilt. Die Reserve hier ist bewusst vorsichtig angesetzt; im Werkzeug können Sie sie ändern.
| Speicher | GiB |
|---|---|
| Speicher des Rechners | 512 |
| Für das System reserviert | −3,00 |
| Bleibt für das Modell | 509,00 |
512 GB ist die Obergrenze, nicht das, was der Einstiegspreis bringt. Es ist die größte Konfiguration, die Apple anbietet, eine Sonderkonfiguration, die es nur mit der Chipversion mit 36 CPU- und 80 GPU-Kernen gibt, und die letzte, die in den Verkauf kam — Ende Oktober 2026. Alles auf dieser Seite ist auf 512 gerechnet: Wer eine kleinere Konfiguration kauft, für den gilt die Tabelle unten nicht. Es ist außerdem der erste Rechner dieses Katalogs, in den alle gemessenen Modelle passen, auch glm-5.2 mit 433,83 GiB, das kein anderer Rechner hier aufnimmt.
Speicherbandbreite
Es sind zwei verschiedene Grenzen, und man verwechselt sie leicht. Während das Modell die Antwort schreibt, bestimmt die Bandbreite: Für jeden Token müssen die Gewichte, die es nutzt, erneut gelesen werden (bei einem dichten Modell alle, bei einem Mixture-of-Experts-Modell die gemeinsamen Schichten und nur die aktiven Experten), Tokens pro Sekunde sind also ungefähr Bandbreite geteilt durch diese Menge. Während das Modell Ihr Dokument liest, bestimmt die Rechenleistung: Die Eingabe wird auf einmal verarbeitet. Darum kann ein Notebook ohne GPU Minuten bis zum ersten Wort brauchen und danach in erträglichem Tempo schreiben.
1.200 GB/s — Herstellerangabe · gegen die Herstellerseite geprüft am 2026-08-31 (Quelle).
Die 1,2 TB/s gehören zum M5 Ultra. Apple hat am selben Tag zwei Mac Studio vorgestellt: Das andere trägt den M5 Max, einen anderen Chip, der bei 614 GB/s und 128 GB endet, ab 2.499 Dollar. Die Bandbreite des Ultra auf den Max zu übertragen, läge um das Doppelte daneben. Und Apple veröffentlicht für keinen M-Chip TFLOPS — nur Kernzahlen und Vergleiche mit der eigenen Vorgängergeneration —, die Rechenzeile unten ist daher unsere eigene Untergrenze, keine Herstellerangabe.
Rechenleistung: 36,8 TFLOPS (Schätzung für diese Geräteklasse) — Geschätzt · der Hersteller veröffentlicht diese Zahl überhaupt nicht; unsere ist eine vorsichtige Schätzung, keine Spezifikation. Die Zahlen dieser Zeile stammen je nach Rechner nicht aus derselben Messgröße, weil jeder Hersteller eine andere veröffentlicht. Vergleichen Sie sie zwischen Rechnern nur mit diesem Wissen.
Welche Modelle hier hineinpassen und welche nicht
Passen heißt, dass drei Dinge gleichzeitig in den übrigen Speicher passen: die Modelldatei, ihr Kontextspeicher und die Arbeitsreserve der Laufzeitumgebung. Der Kontextspeicher wird aus dem von jedem Modell angegebenen Aufmerksamkeitsmuster Schicht für Schicht berechnet, nicht aus der generischen Formel — deshalb passen hier Modelle, die diese Formel für unmöglich erklären würde.
| Modell | Gezeigte Kompression | Modellgröße | 8k | 32k | 128k | Größter Kontext, der passt |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | ja | ja | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | ja | ja | ja | 256k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | ja | ja | ja | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | ja | ja | ja | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | ja | ja | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | ja | ja | ja | 128k |
| qwen3.5-9b | Q4_K_M |
5,29 GiB | ja | ja | ja | 256k |
| gemma4-12b | Q4_K_M |
6,63 GiB | ja | ja | ja | 256k |
| phi-4 | Q4_K_M |
8,43 GiB | ja | — | — | 16k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | ja | ja | ja | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | ja | ja | ja | 128k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | ja | ja | ja | 256k |
| muse-glimmer-30b | Q4_K_M |
15,61 GiB | ja | ja | ja | 128k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | ja | ja | ja | 256k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | ja | ja | ja | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | ja | ja | ja | 256k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | ja | ja | ja | 256k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | ja | ja | ja | 256k |
| flint-40b | Q4_K_M |
23,61 GiB | ja | ja | ja | 256k |
| nemotron-3.5-lightning-30b | Q4_K_M |
23,73 GiB | ja | ja | ja | 256k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | ja | ja | ja | 128k |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | ja | ja | ja | 1024k |
| nemotron-3.5-super-120b | Q4_K_M |
65,29 GiB | ja | ja | ja | 1024k |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | ja | ja | ja | 256k |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | ja | ja | ja | 1024k |
| glm-5.3-flash | Q4_K_M |
187,04 GiB | ja | ja | ja | 1024k |
| glm-5.2 | Q4_K_M |
433,83 GiB | ja | ja | ja | 256k |
| mistral-large-4 | Q4_K_M |
591,21 GiB | nein | nein | nein | — |
Die Größen sind die der tatsächlich veröffentlichten Dateien in der Referenzkompression, eine Stufe je Zeile: Q4_K_M, wo der Autor sie veröffentlicht, sonst die nächstgelegene. Jede Zeile nennt, welche sie zeigt. Q4_K_M ist unsere Qualitätsuntergrenze: darunter ist der Verlust in den Antworten hörbar. Ein Modell, das hier nur mit stärkerer Kompression passen würde, gilt bewusst als nicht passend. Ein Gedankenstrich in einer Kontextspalte heißt, dass das Modell diesen Kontext gar nicht anbietet, es gibt also nichts einzupassen.
Was sich zwischen Q8_0, Q4_K_M und Q3_K_M ändert (Größe, Tempo und Qualität), haben wir selbst in unserem Leitfaden zur GGUF-Quantisierung gemessen.
Modelle, die passen — 27 von den 28 gemessenen Modellen
- qwen3-1.7b
Q4_K_M— Kontext 32k Tokens - qwen3-4b-2507
Q4_K_M— Kontext 256k Tokens - gemma4-e2b
Q4_K_M— Kontext 128k Tokens - gemma4-e4b
Q4_K_M— Kontext 128k Tokens - qwen3-8b
Q4_K_M— Kontext 32k Tokens - granite-4.2-8b
Q4_K_M— Kontext 128k Tokens - qwen3.5-9b
Q4_K_M— Kontext 256k Tokens - gemma4-12b
Q4_K_M— Kontext 256k Tokens - phi-4
Q4_K_M— Kontext 16k Tokens - gpt-oss-20b
Q4_K_M— Kontext 128k Tokens - mistral-small-24b
Q4_K_M— Kontext 128k Tokens - qwen3.8-27b
Q4_K_M— Kontext 256k Tokens - muse-glimmer-30b
Q4_K_M— Kontext 128k Tokens - qwen3.6-27b
Q4_K_M— Kontext 256k Tokens - gemma4-26b-a4b
Q4_K_M— Kontext 256k Tokens - gemma4-31b
Q4_K_M— Kontext 256k Tokens - qwen3-coder-30b
Q4_K_M— Kontext 256k Tokens - qwen3.6-35b-a3b
Q4_K_M— Kontext 256k Tokens - flint-40b
Q4_K_M— Kontext 256k Tokens - nemotron-3.5-lightning-30b
Q4_K_M— Kontext 256k Tokens - gpt-oss-120b
Q4_K_M— Kontext 128k Tokens - llama4-scout-17b
Q4_K_M— Kontext 1024k Tokens - nemotron-3.5-super-120b
Q4_K_M— Kontext 1024k Tokens - qwen3.8-flash-next
IQ4_XS— Kontext 256k Tokens - deepseek-v4-flash
IQ4_XS— Kontext 1024k Tokens - glm-5.3-flash
Q4_K_M— Kontext 1024k Tokens - glm-5.2
Q4_K_M— Kontext 256k Tokens
Modelle, die nicht passen — 1 von den 28 gemessenen Modellen
- mistral-large-4
Q4_K_M— es fehlen 83,37 GiB
Die Rechner daneben
- Xiaomi AI Cube, 80 GB — Technikprototyp — 77,00 GiB für das Modell, 23 / 28 Modelle
- PC mit Ryzen AI Max+ 395 und 128 GB Unified Memory — 96,00 GiB für das Modell, 24 / 28 Modelle
- Mac Studio mit M5 Max und 128 GB Unified Memory — 125,00 GiB für das Modell, 24 / 28 Modelle
- PC mit Ryzen AI Max+ PRO 495 und 192 GB Unified Memory — 160,00 GiB für das Modell, 25 / 28 Modelle
Preis und Verfügbarkeit
Was ein Rechner kostet, entscheidet genauso viel wie das, was hineinpasst — der Preis gehört also auf diese Seite. Unten steht nur, was der Hersteller veröffentlicht, mit dem betroffenen Markt und dem Tag der Abfrage.
Ab 22.299 $ (USA), veröffentlicht am 2026-10-29 (Quelle). Herstellerangabe
Das ist der Preis der günstigsten Konfiguration mit 512 GB: Apple verkauft sie nur mit der Version des M5 Ultra mit 36 CPU- und 80 GPU-Kernen und mindestens mit 1 TB SSD. Die 5.499 $ Einstiegspreis des Mac Studio mit M5 Ultra gelten für die 96-GB-Basis mit 30 CPU- und 64 GPU-Kernen; die 512 GB, mit denen dieses Datenblatt gerechnet ist, kosten also 16.800 $ mehr, mit 2 TB SSD 22.799 $. Apple nennt keinen Preis in Euro: Die Zahl ist in US-Dollar.
Was wir an dieser Seite verdienen
Heute nichts. Auf dieser Seite steht kein Affiliate-Link, und hinter keiner ihrer Zahlen steht eine Handelsvereinbarung. Sollte hier je ein Kauflink erscheinen, wird er als solcher gekennzeichnet und die Provision in diesem Block angegeben. Zwei Regeln ändern sich an dem Tag nicht: Die Rangfolge dieser Seite wird vor der Anwendung kommerzieller Verfügbarkeit berechnet, und „am besten“ heißt nie „zahlt am meisten“.