Startseite›Rechner›Xiaomi AI Cube, 80 GB — Technikprototyp
Xiaomi AI Cube, 80 GB — Technikprototyp
Mini-PC mit NPU80 GiB341 GB/s40,0 TFLOPS
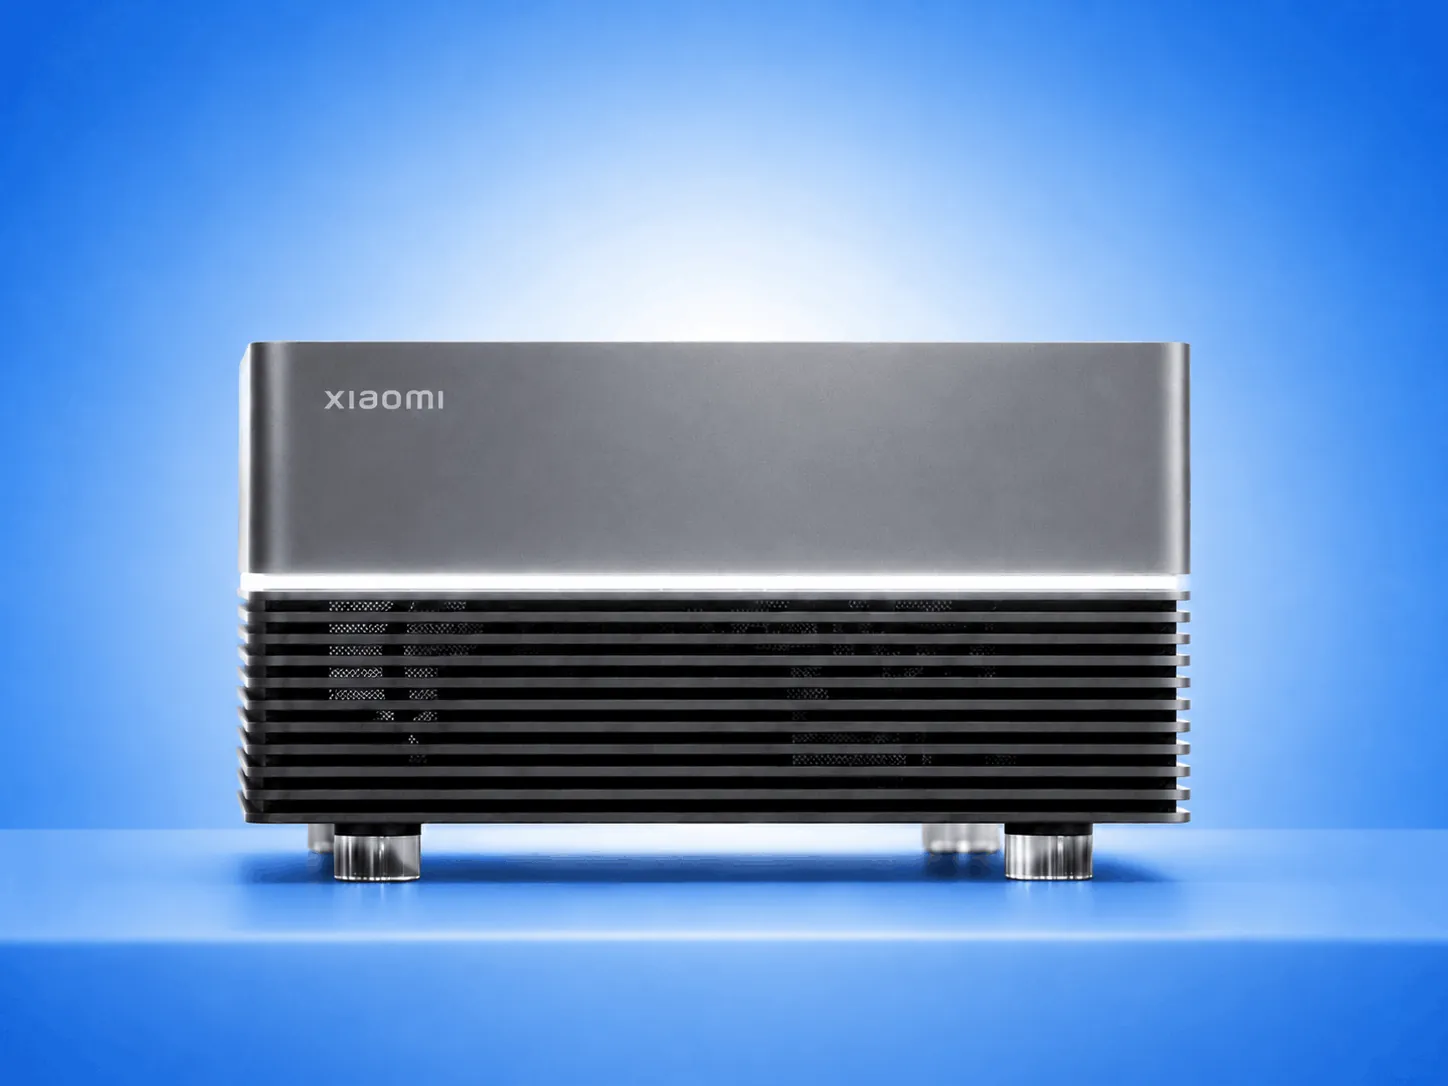
Diesen Rechner kann man nicht kaufen. Alles andere in diesem Bereich ist im Handel erhältlich; dies ist ein Technikprototyp ohne Preis und ohne Termin. Wir vermessen ihn trotzdem, weil wir wissen wollten, was er ausführen würde, falls er je in den Laden kommt — und herausfinden lässt sich das mit derselben Rechnung wie bei allen anderen Rechnern hier. Kleiner Spoiler: ziemlich viel.
Sobald das System seinen Anteil genommen hat, bleiben diesem Rechner 77,00 GiB für das Modell: Platz für 22 der 26 Modelle, die wir bei der Referenzkompression messen, und das schwerste, das hineinpasst, ist nemotron-3.5-super-120b. Und wie schnell antwortet er? Das entscheidet nicht der Chip, sondern seine 341 GB/s Speicherbandbreite (unsere Schätzung: der Hersteller veröffentlicht sie nicht).
Bleibt für das Modell
Eigene Schätzung
Speicherbandbreite
Eigene Schätzung
Modelle, die passen
Von Local AI Scope gemessen
Videos: Xiaomi AI Cube, 80 GB — Technikprototyp 5
Die besten Vorführungen, die wir gefunden haben. Drücken Sie auf Play, und es läuft direkt hier.
Die Videos liegen bei YouTube, und von dort wird nichts geladen, bevor Sie auf Play drücken (Modus ohne Cookies). Das Vorschaubild kommt von uns.
Der Speicher, den Sie wirklich nutzen können
Der vereinheitlichte Speicher wird mit dem Betriebssystem und allem Geöffneten geteilt. Die Reserve hier ist bewusst vorsichtig angesetzt; im Werkzeug können Sie sie ändern.
| Speicher | GiB |
|---|---|
| Speicher des Rechners | 80 |
| Für das System reserviert | −3,00 |
| Bleibt für das Modell | 77,00 |
160 GB unterstützt der Chip D100 – so viel hat dieser Rechner aber nicht. Das von Xiaomi gezeigte Gerät trägt 80 GB, und aus 80 stammt jede Zahl dieser Seite. Der Unterschied ist nicht kosmetisch: Mit 160 GB nähme dieser Rechner 24 der 26 Modelle statt 22 auf, und das größte wäre deepseek-v4-flash mit 127,28 GiB statt nemotron-3.5-super-120b mit 65,29 GiB.
Speicherbandbreite
Es sind zwei verschiedene Grenzen, und man verwechselt sie leicht. Während das Modell die Antwort schreibt, bestimmt die Bandbreite: Für jeden Token müssen die Gewichte, die es nutzt, erneut gelesen werden (bei einem dichten Modell alle, bei einem Mixture-of-Experts-Modell die gemeinsamen Schichten und nur die aktiven Experten), Tokens pro Sekunde sind also ungefähr Bandbreite geteilt durch diese Menge. Während das Modell Ihr Dokument liest, bestimmt die Rechenleistung: Die Eingabe wird auf einmal verarbeitet. Darum kann ein Notebook ohne GPU Minuten bis zum ersten Wort brauchen und danach in erträglichem Tempo schreiben.
341 GB/s — Geschätzt · der Hersteller veröffentlicht diese Zahl überhaupt nicht; unsere ist eine vorsichtige Schätzung, keine Spezifikation.
Die 1,22 TB/s sind eine echte Xiaomi-Zahl, nur nicht für diesen Speicher. Es ist die Nahspeicher-Bandbreite, die Xiaomi dem Beschleuniger O100 zuschreibt, über DRAM, das direkt auf dem Rechen-Die gestapelt ist: ein kleiner, sehr schneller Pool, nicht die 80 GB, in denen ein 120B-Modell tatsächlich liegt. Die Bandbreite dieser 80 GB hat Xiaomi nicht veröffentlicht; die Zahl auf dieser Seite ist daher unsere eigene Annahme und ist so gekennzeichnet. Dasselbe gilt für die 200 TOPS: Sie gehören zur NPU des O3 und zählen 8-Bit-Ganzzahl-Operationen (andere Einheit, anderer Chip), deshalb lassen wir sie in der Rechenzeile oben außen vor. Verlockend, schon klar.
Rechenleistung: 40,0 TFLOPS (Schätzung für diese Geräteklasse) — Geschätzt · der Hersteller veröffentlicht diese Zahl überhaupt nicht; unsere ist eine vorsichtige Schätzung, keine Spezifikation. Die Zahlen dieser Zeile stammen je nach Rechner nicht aus derselben Messgröße, weil jeder Hersteller eine andere veröffentlicht. Vergleichen Sie sie zwischen Rechnern nur mit diesem Wissen.
Welche Modelle hier hineinpassen und welche nicht
Passen heißt, dass drei Dinge gleichzeitig in den übrigen Speicher passen: die Modelldatei, ihr Kontextspeicher und die Arbeitsreserve der Laufzeitumgebung. Der Kontextspeicher wird aus dem von jedem Modell angegebenen Aufmerksamkeitsmuster Schicht für Schicht berechnet, nicht aus der generischen Formel — deshalb passen hier Modelle, die diese Formel für unmöglich erklären würde.
| Modell | Gezeigte Kompression | Modellgröße | 8k | 32k | 128k | Größter Kontext, der passt |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | ja | ja | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | ja | ja | ja | 256k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | ja | ja | ja | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | ja | ja | ja | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | ja | ja | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | ja | ja | ja | 128k |
| qwen3.5-9b | Q4_K_M |
5,29 GiB | ja | ja | ja | 256k |
| gemma4-12b | Q4_K_M |
6,63 GiB | ja | ja | ja | 256k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | ja | ja | ja | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | ja | ja | ja | 128k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | ja | ja | ja | 256k |
| muse-glimmer-30b | Q4_K_M |
15,61 GiB | ja | ja | ja | 128k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | ja | ja | ja | 256k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | ja | ja | ja | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | ja | ja | ja | 256k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | ja | ja | ja | 256k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | ja | ja | ja | 256k |
| flint-40b | Q4_K_M |
23,61 GiB | ja | ja | ja | 256k |
| nemotron-3.5-lightning-30b | Q4_K_M |
23,73 GiB | ja | ja | ja | 256k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | ja | ja | ja | 128k |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | ja | ja | ja | 128k |
| nemotron-3.5-super-120b | Q4_K_M |
65,29 GiB | ja | ja | ja | 256k |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | nein | nein | nein | — |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | nein | nein | nein | — |
| glm-5.3-flash | Q4_K_M |
187,04 GiB | nein | nein | nein | — |
| glm-5.2 | Q4_K_M |
433,83 GiB | nein | nein | nein | — |
Die Größen sind die der tatsächlich veröffentlichten Dateien in der Referenzkompression, eine Stufe je Zeile: Q4_K_M, wo der Autor sie veröffentlicht, sonst die nächstgelegene. Jede Zeile nennt, welche sie zeigt. Q4_K_M ist unsere Qualitätsuntergrenze: darunter ist der Verlust in den Antworten hörbar. Ein Modell, das hier nur mit stärkerer Kompression passen würde, gilt bewusst als nicht passend. Ein Gedankenstrich in einer Kontextspalte heißt, dass das Modell diesen Kontext gar nicht anbietet, es gibt also nichts einzupassen.
Modelle, die passen — 22 von den 26 gemessenen Modellen
- qwen3-1.7b
Q4_K_M— Kontext 32k Tokens - qwen3-4b-2507
Q4_K_M— Kontext 256k Tokens - gemma4-e2b
Q4_K_M— Kontext 128k Tokens - gemma4-e4b
Q4_K_M— Kontext 128k Tokens - qwen3-8b
Q4_K_M— Kontext 32k Tokens - granite-4.2-8b
Q4_K_M— Kontext 128k Tokens - qwen3.5-9b
Q4_K_M— Kontext 256k Tokens - gemma4-12b
Q4_K_M— Kontext 256k Tokens - gpt-oss-20b
Q4_K_M— Kontext 128k Tokens - mistral-small-24b
Q4_K_M— Kontext 128k Tokens - qwen3.8-27b
Q4_K_M— Kontext 256k Tokens - muse-glimmer-30b
Q4_K_M— Kontext 128k Tokens - qwen3.6-27b
Q4_K_M— Kontext 256k Tokens - gemma4-26b-a4b
Q4_K_M— Kontext 256k Tokens - gemma4-31b
Q4_K_M— Kontext 256k Tokens - qwen3-coder-30b
Q4_K_M— Kontext 256k Tokens - qwen3.6-35b-a3b
Q4_K_M— Kontext 256k Tokens - flint-40b
Q4_K_M— Kontext 256k Tokens - nemotron-3.5-lightning-30b
Q4_K_M— Kontext 256k Tokens - gpt-oss-120b
Q4_K_M— Kontext 128k Tokens - llama4-scout-17b
Q4_K_M— Kontext 128k Tokens - nemotron-3.5-super-120b
Q4_K_M— Kontext 256k Tokens
Modelle, die nicht passen — 4 von den 26 gemessenen Modellen
- qwen3.8-flash-next
IQ4_XS— es fehlen 11,02 GiB · mitllama.cppv0.5.0 oder neuer, das seine N-Gramm-Tabelle auf der Platte lässt, passt es doch, bis 256k - deepseek-v4-flash
IQ4_XS— es fehlen 51,29 GiB - glm-5.3-flash
Q4_K_M— es fehlen 110,80 GiB - glm-5.2
Q4_K_M— es fehlen 358,12 GiB
Die Rechner daneben
- Mac mit M4 Max und 64 GB — 61,00 GiB für das Modell, 20 / 26 Modelle
- Mac mini mit M5 Pro und 64 GB Unified Memory — 61,00 GiB für das Modell, 20 / 26 Modelle
- PC mit Ryzen AI Max+ 395 und 128 GB Unified Memory — 96,00 GiB für das Modell, 23 / 26 Modelle
- Mac Studio mit M5 Max und 128 GB Unified Memory — 125,00 GiB für das Modell, 23 / 26 Modelle
Preis und Verfügbarkeit
Was ein Rechner kostet, entscheidet genauso viel wie das, was hineinpasst — der Preis gehört also auf diese Seite. Unten steht nur, was der Hersteller veröffentlicht, mit dem betroffenen Markt und dem Tag der Abfrage.
Kein Preis: Dies ist ein Technikprototyp, kein verkäufliches Produkt.
Falls Sie wegen des Preises hier sind: Was man heute stattdessen mit 64 bis 192 GB kaufen kann und welche Modelle auf jedem dieser Rechner laufen, steht in Alternativen zum Xiaomi AI Cube.
Was wir an dieser Seite verdienen
Heute nichts. Auf dieser Seite steht kein Affiliate-Link, und hinter keiner ihrer Zahlen steht eine Handelsvereinbarung. Sollte hier je ein Kauflink erscheinen, wird er als solcher gekennzeichnet und die Provision in diesem Block angegeben. Zwei Regeln ändern sich an dem Tag nicht: Die Rangfolge dieser Seite wird vor der Anwendung kommerzieller Verfügbarkeit berechnet, und „am besten“ heißt nie „zahlt am meisten“.