Startseite›Rechner›PC mit Ryzen AI Max+ 395 und 128 GB Unified Memory
PC mit Ryzen AI Max+ 395 und 128 GB Unified Memory
AMD-Chip mit Unified Memory128 GiB256 GB/s14,8 TFLOPS
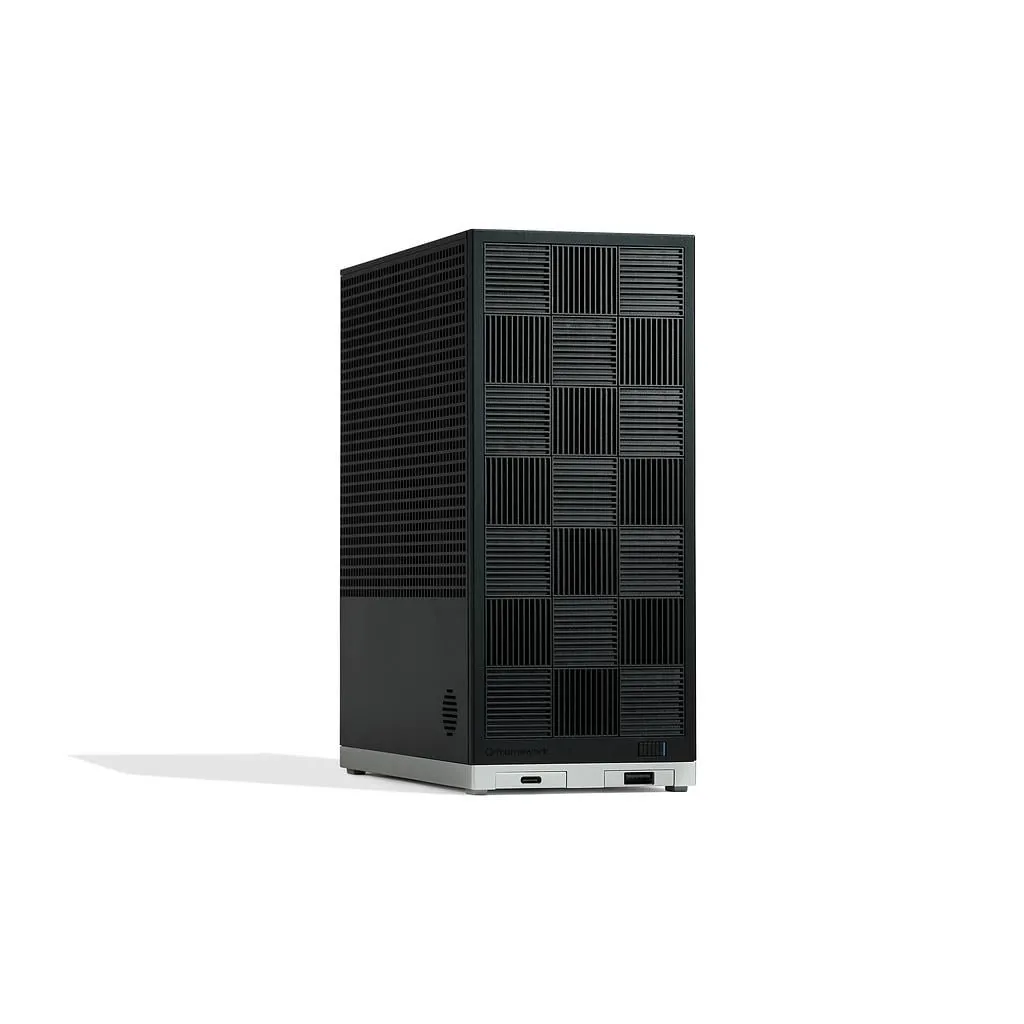
Dieser Rechner lässt dem Modell 96,00 GiB, nachdem das System seinen Anteil genommen hat, und er nimmt 18 der 20 Modelle auf, die wir bei der Referenzkompression messen. Über das Tempo der Antwort entscheidet nicht der Chip, sondern die 256 GB/s Speicherbandbreite.
Bleibt für das Modell
Eigene Schätzung
Speicherbandbreite
Eigene Schätzung
Modelle, die passen
Von Local AI Scope gemessen
Videos: PC mit Ryzen AI Max+ 395 und 128 GB Unified Memory 2
Offizielles Material und die besten Vorführungen, die wir gefunden haben. Drücken Sie auf Play, und es läuft direkt hier.
Die Videos liegen bei YouTube, und von dort wird nichts geladen, bevor Sie auf Play drücken (Modus ohne Cookies). Das Vorschaubild kommt von uns.
Der Speicher, den Sie wirklich nutzen können
Der vereinheitlichte Speicher wird mit dem Betriebssystem und allem Geöffneten geteilt. Die Reserve hier ist bewusst vorsichtig angesetzt; im Werkzeug können Sie sie ändern.
| Speicher | GiB |
|---|---|
| Speicher des Rechners | 128 |
| Für das System reserviert | −3,00 |
| Über der Grenze, die der Hersteller der GPU setzt | −29,00 |
| Bleibt für das Modell | 96,00 |
128 GB im Gehäuse, 96 für das Modell. Laut AMD sind bei dieser Generation bis zu 96 der 128 GB für den Grafikprozessor reserviert, und der Grafikprozessor ist es, der das Modell ausführt. Deshalb rechnet diese Seite überall mit 96 und nicht mit den 125, die nach Abzug unserer Systemreserve übrig blieben. Unter Linux ist diese Grenze eine Treibereinstellung, die AMD als anpassbar dokumentiert, ohne einen Höchstwert zu nennen: Wir bleiben bei der Zahl, die AMD veröffentlicht.
Speicherbandbreite
Es sind zwei verschiedene Grenzen, und sie werden ständig verwechselt. Während das Modell die Antwort schreibt, bestimmt die Bandbreite: Für jeden einzelnen Token müssen die Gewichte erneut gelesen werden, Tokens pro Sekunde sind also ungefähr Bandbreite geteilt durch Modellgröße. Während das Modell Ihr Dokument liest, bestimmt die Rechenleistung: Die Eingabe wird auf einmal verarbeitet. Darum kann ein Notebook ohne GPU Minuten bis zum ersten Wort brauchen und danach in erträglichem Tempo schreiben.
256 GB/s — Abgeleitet, nicht vom Hersteller veröffentlicht · der Hersteller veröffentlicht die Busbreite, aber weder die Speichergeschwindigkeit noch die Bandbreite. Diese Zahl ist die übliche rechnerische Ableitung (), an der Quelle konnten wir sie nicht bestätigen (Quelle).
Rechenleistung: 14,8 TFLOPS (Schätzung für diese Geräteklasse) — Geschätzt · der Hersteller veröffentlicht diese Zahl überhaupt nicht; unsere ist eine vorsichtige Schätzung, keine Spezifikation. Die Zahlen dieser Zeile stammen je nach Rechner nicht aus derselben Messgröße, weil jeder Hersteller eine andere veröffentlicht. Vergleichen Sie sie zwischen Rechnern nur mit diesem Wissen.
Welche Modelle hier hineinpassen und welche nicht
Passen heißt, dass drei Dinge gleichzeitig in den übrigen Speicher passen: die Modelldatei, ihr Kontextspeicher und die Arbeitsreserve der Laufzeitumgebung. Der Kontextspeicher wird aus dem von jedem Modell angegebenen Aufmerksamkeitsmuster Schicht für Schicht berechnet, nicht aus der generischen Formel — deshalb passen hier Modelle, die andere Rechner für unmöglich erklären.
| Modell | Gezeigte Kompression | Modellgröße | 8k | 32k | 128k | Größter Kontext, der passt |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | ja | ja | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | ja | ja | ja | 256k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | ja | ja | ja | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | ja | ja | ja | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | ja | ja | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | ja | ja | ja | 128k |
| gemma4-12b | Q4_K_M |
6,63 GiB | ja | ja | ja | 256k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | ja | ja | ja | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | ja | ja | ja | 128k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | ja | ja | ja | 256k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | ja | ja | ja | 256k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | ja | ja | ja | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | ja | ja | ja | 256k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | ja | ja | ja | 256k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | ja | ja | ja | 256k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | ja | ja | ja | 128k |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | ja | ja | ja | 128k |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | ja | ja | ja | 128k |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | nein | nein | nein | — |
| glm-5.2 | Q4_K_M |
433,83 GiB | nein | nein | nein | — |
Die Größen sind die der tatsächlich veröffentlichten Dateien in der Referenzkompression, eine Stufe je Zeile: Q4_K_M, wo der Autor sie veröffentlicht, sonst die nächstgelegene. Jede Zeile nennt, welche sie zeigt. Q4_K_M ist unsere Qualitätsuntergrenze: darunter ist der Verlust in den Antworten hörbar. Ein Modell, das hier nur mit stärkerer Kompression passen würde, gilt bewusst als nicht passend. Ein Gedankenstrich in einer Kontextspalte heißt, dass das Modell diesen Kontext gar nicht anbietet, es gibt also nichts einzupassen.
Modelle, die passen — 18 von den 20 gemessenen Modellen
- qwen3-1.7b
Q4_K_M— Kontext 32k Tokens - qwen3-4b-2507
Q4_K_M— Kontext 256k Tokens - gemma4-e2b
Q4_K_M— Kontext 128k Tokens - gemma4-e4b
Q4_K_M— Kontext 128k Tokens - qwen3-8b
Q4_K_M— Kontext 32k Tokens - granite-4.2-8b
Q4_K_M— Kontext 128k Tokens - gemma4-12b
Q4_K_M— Kontext 256k Tokens - gpt-oss-20b
Q4_K_M— Kontext 128k Tokens - mistral-small-24b
Q4_K_M— Kontext 128k Tokens - qwen3.8-27b
Q4_K_M— Kontext 256k Tokens - qwen3.6-27b
Q4_K_M— Kontext 256k Tokens - gemma4-26b-a4b
Q4_K_M— Kontext 256k Tokens - gemma4-31b
Q4_K_M— Kontext 256k Tokens - qwen3-coder-30b
Q4_K_M— Kontext 256k Tokens - qwen3.6-35b-a3b
Q4_K_M— Kontext 256k Tokens - gpt-oss-120b
Q4_K_M— Kontext 128k Tokens - llama4-scout-17b
Q4_K_M— Kontext 128k Tokens - qwen3.8-flash-next
IQ4_XS— Kontext 128k Tokens
Modelle, die nicht passen — 2 von den 20 gemessenen Modellen
- deepseek-v4-flash
IQ4_XS— es fehlen 32,29 GiB - glm-5.2
Q4_K_M— es fehlen 353,13 GiB
Die Rechner daneben
- Mac mini mit M5 Pro und 64 GB Unified Memory — 61,00 GiB für das Modell, 16 / 20 Modelle
- Xiaomi AI Cube, 80 GB — Technikprototyp — 77,00 GiB für das Modell, 17 / 20 Modelle
- Mac Studio mit M5 Max und 128 GB Unified Memory — 125,00 GiB für das Modell, 18 / 20 Modelle
- PC mit Ryzen AI Max+ PRO 495 und 192 GB Unified Memory — 160,00 GiB für das Modell, 19 / 20 Modelle
Preis und Verfügbarkeit
Was ein Rechner kostet, entscheidet genauso viel wie das, was hineinpasst — der Preis gehört also auf diese Seite. Unten steht nur, was der Hersteller veröffentlicht, mit dem betroffenen Markt und dem Tag der Abfrage.
Ab 3.449 $ (USA), veröffentlicht am 2026-10-01 (Quelle). Herstellerangabe
Was wir an dieser Seite verdienen
Heute nichts. Auf dieser Seite steht kein Affiliate-Link, und hinter keiner ihrer Zahlen steht eine Handelsvereinbarung. Sollte hier je ein Kauflink erscheinen, wird er als solcher gekennzeichnet und die Provision in diesem Block angegeben. Zwei Regeln ändern sich an dem Tag nicht: Die Rangfolge dieser Seite wird vor der Anwendung kommerzieller Verfügbarkeit berechnet, und „am besten“ heißt nie „zahlt am meisten“.