GGUF ist das Modellformat in einer Datei, das llama.cpp, Ollama und LM Studio lesen. Das Q4_K_M, Q5_K_M oder Q8_0 im Namen ist die Quantisierung: wie viele Bits jedes Gewicht behält. Q4_K_M ist die übliche Wahl: In unserem Test wog es 59 % von Q8_0 und wählte auf unserem Testtext in 89 % der Fälle dasselbe nächste Token wie das Original.
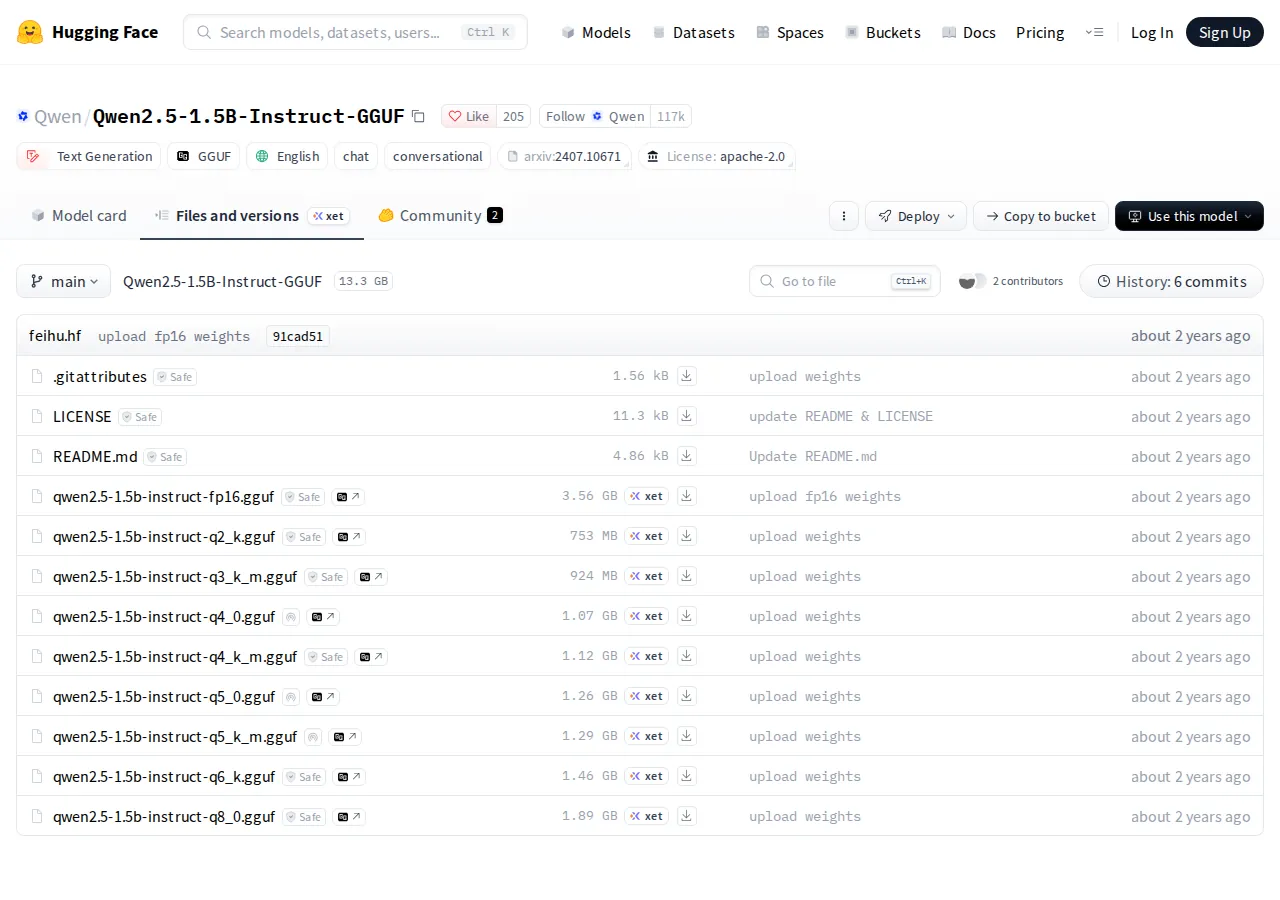
Am 18. November 2026 haben wir die offiziellen GGUF-Dateien von Qwen2.5 1.5B Instruct in 6 Versionen (von F16 bis Q3_K_M) heruntergeladen und mit llama.cpp (Build b12500) auf einem Linux-Server ohne Grafikkarte laufen lassen, mit einem AMD Ryzen 7 7730U und 8 Threads. Gemessen haben wir, wie viel jede Datei wiegt, wie schnell sie schreibt und wie oft ihre Wahl des nächsten Tokens von der des nicht quantisierten Modells abweicht. Danach haben wir die 28 Modelle unseres Modellfinders durch dieselbe Rechnung geschickt, die das Werkzeug verwendet, um zu sehen, was auf jeder Stufe in 8, 12, 16, 24 und 32 GB passt. Bei allem Folgenden steht dabei, woher die Zahl stammt.
Was GGUF ist und was Q4_K_M im Dateinamen bedeutet
Eine GGUF-Datei enthält alles, was ein Modell zum Laufen braucht, in einem Stück: die Gewichte, den Tokenizer, die Architektur und meist auch die Chatvorlage. Deshalb können Sie eine einzige Datei herunterladen und sie direkt in llama.cpp, LM Studio oder Ollama öffnen. Das Format stammt aus dem Projekt llama.cpp, und diese 3 Programme lesen es, weil sie auf llama.cpp und seiner Bibliothek ggml aufbauen.
 llama.cppProgramm-Datenblatt
Quantisierung ist die Kompression. Ein nicht quantisiertes Modell speichert jedes Gewicht mit 16 oder 32 Bit; eine quantisierte Datei speichert es mit weniger, in Blöcken, die sich einen Skalierungsfaktor teilen. Der Name verrät, wie:
- Die Zahl (Q3, Q4, Q5, Q6, Q8) steht für die Basis-Bits pro Gewicht.
- Das K kennzeichnet die Familie der „K-Quants“, die in Blöcken arbeitet, die zu Superblöcken zusammengefasst sind. Q8_0 und Q4_0 gehören zur älteren, einfacheren Familie.
- Das _S, _M oder _L ist die Mischung: klein, mittel oder groß. Es geht nicht um die Größe des Modells, sondern darum, wie viele Tensoren mit höherer Genauigkeit erhalten bleiben.
Den letzten Punkt haben wir geprüft, indem wir die Dateien geöffnet haben. Unser Q4_K_M hat 169 Tensoren mit 4 Bit (q4_K) und 29 mit 6 Bit (q6_K); Q5_K_M hat dieselbe Aufteilung 169/29 mit 5 Bit als Basis; Q6_K und Q8_0 verwenden für alle 198 quantisierten Tensoren einen einzigen Typ. Wer Q4_K_M wählt, wählt also nicht „alles in 4 Bit“, sondern 4 Bit mit geschützten empfindlichen Teilen. Deshalb meldet llama.cpp für dieses Q4_K_M auch 5,00 Bit pro Gewicht und nicht 4.
Wenn Sie zwischen GGUF und den originalen Safetensors-Dateien schwanken, die vLLM und transformers laden: Dieser Vergleich steht in unserem Ratgeber vLLM vs. Ollama, und für den Mac in MLX vs. GGUF.
GGUF-Quantisierungsstufen: wie viel jede wiegt
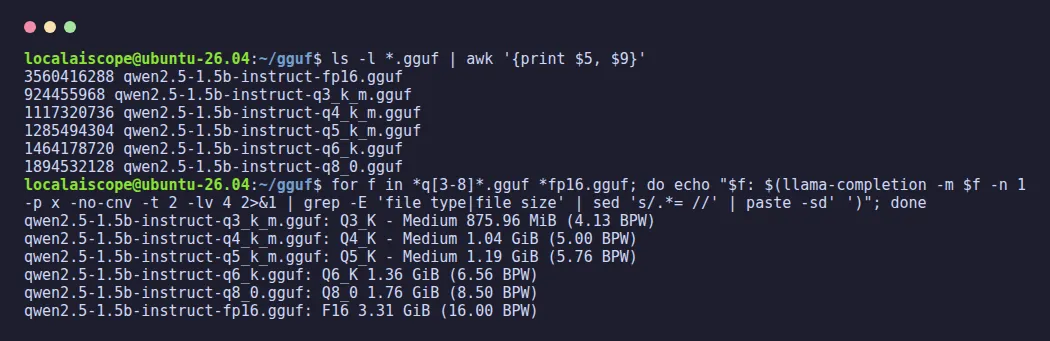
Die Faustregel stimmt: weniger Bits, kleinere Datei. Sie sinkt aber nicht linear, wegen der geschützten Tensoren und der Teile, die nie komprimiert werden. Das sind die 6 Dateien, die wir gemessen haben, alle aus dem offiziellen Repository von Qwen:
| Stufe | Datei (MB) |
Bit pro Gewicht |
vs. Q8_0 |
|---|---|---|---|
| F16 | 3.560 | 16,00 | 188 % |
| Q8_0 | 1.895 | 8,50 | 100 % |
| Q6_K | 1.464 | 6,56 | 77 % |
| Q5_K_M | 1.285 | 5,76 | 68 % |
| Q4_K_M | 1.117 | 5,00 | 59 % |
| Q3_K_M | 924 | 4,13 | 49 % |
Dieses Modell ist klein, und allein sein Vokabular hat 151.936 Tokens: Das erklärt vermutlich, warum seine Stufen so nah beieinanderliegen. Bei größeren Modellen öffnet sich die Leiter: Unter den Modellen unseres Katalogs, die beide Dateien anbieten, wiegt Q4_K_M im Schnitt 62 % von Q8_0, Q5_K_M 72 % und Q6_K 82 %. Bei Qwen3 8B sind das 8,11 GiB in Q8_0, 6,26 in Q6_K, 5,45 in Q5_K_M, 4,68 in Q4_K_M und 3,84 in Q3_K_M.
Q4_K_M vs. Q5_K_M vs. Q8_0: wie viel Qualität Sie verlieren
Wie misst man, was eine komprimierte Datei verliert? Mit der Methode, die llama.cpp mitbringt. Zuerst hat das F16-Modell 10.240 Tokens Text aus der englischen Wikipedia gelesen (den Testsatz wikitext-2, 20 Blöcke mit je 512 Tokens), und wir haben an jeder Stelle gespeichert, wie wahrscheinlich es jedes mögliche nächste Token fand. Danach hat jede quantisierte Datei genau denselben Text gelesen, und llama-perplexity hat verglichen. Zwei Zahlen zählen: wie oft das Lieblings-Token des quantisierten Modells mit dem des Originals übereinstimmt und wie stark seine Perplexität (PPL) steigt (wie sehr es vom echten Text überrascht wird; niedriger ist besser).
| Stufe | Gleiche erste Wahl (%) |
PPL vs. F16 (%) |
KLD (Mittel) |
|---|---|---|---|
| Q8_0 | 97,7 | +0,3 | 0,0015 |
| Q6_K | 93,6 | +1,2 | 0,011 |
| Q5_K_M | 91,8 | +1,2 | 0,017 |
| Q4_K_M | 89,0 | +5,6 | 0,042 |
| Q3_K_M | 82,2 | +13,4 | 0,117 |
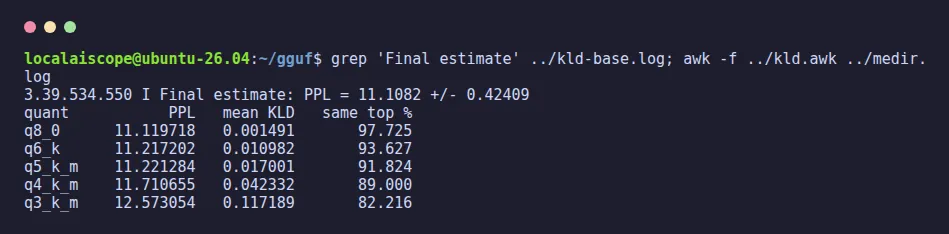
Q8_0 ist vom Original praktisch nicht zu unterscheiden: dieselbe erste Wahl bei 97,7 % der Tokens und 0,3 % mehr Perplexität. Q6_K und Q5_K_M kosten bei der Perplexität gleich viel (+1,2 %), wobei Q5_K_M bei der ersten Wahl etwas öfter abweicht. Q4_K_M ist die erste echte Stufe: +5,6 % Perplexität und eine andere erste Wahl bei etwa 1 von 9 Tokens. Das heißt nicht, dass jedes neunte Wort falsch ist: Eine andere erste Wahl ist nicht automatisch eine falsche. Bei Q3_K_M fängt es an wehzutun: mehr als doppelt so viel Perplexitätsverlust wie Q4_K_M und fast die dreifache Abweichung (die Spalte KLD).
Eine ehrliche Grenze: Das ist 1 Modell mit 1,5 Milliarden Parametern, gemessen an 1 englischen Text. Größere Modelle haben wir so nicht gemessen, deshalb nennen wir für sie keine Zahl.
Geschwindigkeit: Die kleinere Datei schreibt auch schneller
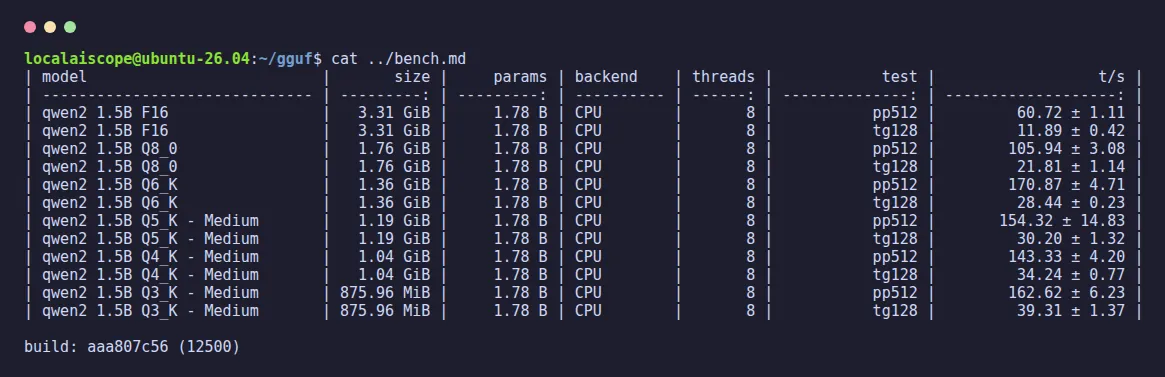
Auf einem Rechner ohne Grafikkarte muss für jedes geschriebene Token das ganze Modell aus dem Speicher gelesen werden; eine kleinere Datei bedeutet also mehr Tokens pro Sekunde. Unser Test mit llama-bench (128 geschriebene Tokens und ein gelesener Prompt mit 512 Tokens, 3 Wiederholungen, 8 Threads) bestätigt das. Ausnahmsweise macht eine Diät hier schneller:
| CPU 18.11.2026 |
Schreibt (tok/s) |
Liest (tok/s) |
|---|---|---|
| F16 | 11,9 | 61 |
| Q8_0 | 21,8 | 106 |
| Q6_K | 28,4 | 171 |
| Q5_K_M | 30,2 | 154 |
| Q4_K_M | 34,2 | 143 |
| Q3_K_M | 39,3 | 163 |
Das Schreibtempo steigt sauber in der Reihenfolge, in der die Datei schrumpft: Q4_K_M schreibt auf demselben Prozessor 57 % schneller als Q8_0. Das Lesen des Prompts folgt dieser Reihenfolge nicht: Dort ist vor allem Rechenarbeit gefragt und nicht Speicher, es hängt also davon ab, wie schnell sich jedes Format auf dieser CPU entpacken lässt. Eine Einschränkung: Auf dem Server liefen gleichzeitig andere Aufgaben, kleine Abstände wie Q6_K gegen Q5_K_M liegen deshalb im Rauschen. Auf einer Grafikkarte haben wir nicht gemessen.
Was in 8, 12, 16, 24 und 32 GB mit jeder Quantisierung passt
Hier verdient sich die Quantisierung ihr Geld. Wir haben mit derselben Rechnung, die unser Modellfinder verwendet (Gewichte + der echte KV-Cache des Modells + ein Puffer für das Programm, bei 8.192 Tokens Kontext), gezählt, wie viele unserer 28 Modelle je nach heruntergeladener Stufe in welchen Speicher passen:
| Speicher | Q8_0 | Q5_K |
Q4_K |
Q3_K |
|---|---|---|---|---|
| 8 GB | 3 | 5 | 7 | 8 |
| 12 GB | 7 | 8 | 9 | 9 |
| 16 GB | 9 | 10 | 10 | 12 |
| 24 GB | 10 | 16 | 18 | 18 |
| 32 GB | 14 | 18 | 20 | 18 |
Die Geräte stammen aus unserem Katalog: ein PC mit RTX 4060 (8 GB), einer mit RTX 3060 (12 GB), ein Mac mit M4 (16 GB), eine Workstation mit RTX 4090 (24 GB) und ein Mac mini mit M6 (32 GB). Q6_K, aus Platzgründen nicht in der Tabelle, liegt dazwischen: 3, 8, 9, 14 und 17 Modelle. So lesen Sie die Tabelle: Mit 8 GB VRAM bringt Sie der Schritt von Q8_0 auf Q4_K_M von 3 auf 7 Modelle. Mit 24 GB von 10 auf 18. Die Spalte Q3_K_M wächst nicht immer, weil nicht jedes Modell diese Stufe anbietet: 23 unserer 28 haben sie, gegenüber 26 mit Q4_K_M. Gezählt wird der Speicher, der für das Modell übrig bleibt: auf einer Grafikkarte 0,8 GiB weniger für den Desktop, auf einem Mac oder im Arbeitsspeicher 3 GiB weniger für das System. Noch ein Detail: Die Spalte Q3_K_M zählt, was passt, der Modellfinder zeigt aber alles unterhalb von Q4_K_M getrennt an, statt es mitzuzählen.
Ein konkretes Beispiel: Qwen3 8B braucht mit diesem Kontext in Q8_0 9,99 GiB, die auf der RTX 4060 (7,2 GiB verfügbar) keinen Platz finden, und in Q4_K_M 6,56 GiB, die passen. Auch der Kontext kostet Speicher; wenn es knapp wird, zeigt unser Ratgeber zur Kontextlänge, was jede Stufe kostet.
Eine bestimmte Quantisierung herunterladen
Auf Hugging Face haben die offiziellen Repositorys meist eine Datei pro Stufe, und die 3 großen Programme lassen Sie wählen:
- llama.cpp: Die Stufe steht nach einem Doppelpunkt.
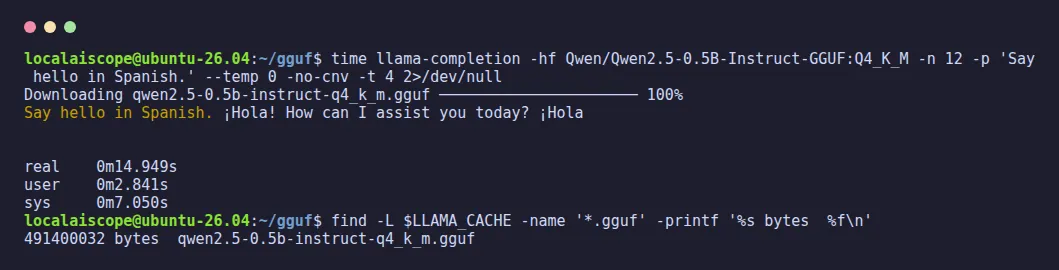
llama-completion -hf Qwen/Qwen2.5-0.5B-Instruct-GGUF:Q4_K_Mhat in unserem Test die Datei mit 491.400.032 Byte geladen und nach 14,9 Sekunden samt Download geantwortet, obwohl der Dateiname kleingeschrieben ist. Auf Englisch gebeten, auf Spanisch zu grüßen, antwortete es „¡Hola!“ und wechselte dann ungefragt ins Englische, um Hilfe anzubieten: zweisprachig ja, folgsam eher nicht. llama-server nimmt dieselbe Option-hfan. - Ollama: Bei einem Modell von Hugging Face gilt dasselbe Muster:
ollama run hf.co/nutzer/repository:Q4_K_M(diesen Weg haben wir diesmal nicht getestet). Um ein GGUF zu laden, das schon auf der Platte liegt, schreiben SieFROM ./modell.ggufin ein Modelfile, wie in unserem Ratgeber zu den Ollama-Befehlen beschrieben. - LM Studio: Beim Herunterladen zeigt es die Dateien des Repositorys mit ihrer Größe, und Sie wählen eine aus (das haben wir diesmal nicht getestet). Meldet es „no LM runtime found for model format ‘gguf’“, steht die Lösung in LM Studio funktioniert nicht.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken.
Ein englischsprachiges Video von 12 Minuten über die Leiter Q8, Q6, Q5 und Q4, veröffentlicht im Oktober 2025.
Welche GGUF-Quantisierung Sie herunterladen sollten
- Das Modell passt mit viel Luft: Q5_K_M oder Q6_K. Gegenüber Q8_0 verlieren Sie fast nichts, und es bleibt Speicher für den Kontext.
- Der Normalfall: Q4_K_M. Diese Stufe nimmt unser Modellfinder als Referenz, sie macht auf einer 8-GB-Karte aus 3 Modellen 7, und in unserer Messung traf sie bei 89 % der Tokens dieselbe erste Wahl wie das Original.
- Speicher im Überfluss, oder Sie messen: Q8_0, praktisch das Originalmodell bei halber Größe von F16.
- Es passt nicht in Q4_K_M: Bevor Sie auf Q3_K_M gehen, probieren Sie ein kleineres Modell derselben Familie in Q4_K_M oder höher. Unterhalb von Q4_K_M zeigt Ihnen unser Modellfinder das Modell getrennt an, statt es als passend zu zählen.
Wenn Sie nicht selbst rechnen möchten: Der Modellfinder erledigt das für Ihr Gerät, Modell für Modell, mit denselben Zahlen wie diese Seite.