Die Ollama-Befehle für jeden Tag sind ollama pull (Modell herunterladen), ollama list (vorhandene Modelle anzeigen), ollama run (chatten), ollama ps und ollama stop (was im Speicher liegt), ollama rm (löschen), ollama cp und ollama create (Kopien und eigene Modelle per Modelfile). Hier jeder Befehl mit seiner echten Ausgabe.
Wir haben jeden Befehl dieses Spickzettels am 14. November 2026 mit Ollama 0.40.16 ausgeführt, der an diesem Tag neuesten stabilen Version, in Docker mit dem offiziellen Image ollama/ollama:0.40.16, auf einem Server ohne Grafikkarte (Prozessor AMD Ryzen 7 7730U). Als Versuchskaninchen diente eines der kleinsten Modelle im Katalog, smollm2:135m, damit jeder Befehl in Sekunden antwortet. Die Ausgaben sind unverändert aus unserem Terminal kopiert, Fehlermeldungen eingeschlossen: Wenn eine davon bei Ihnen auftaucht, wissen Sie genau, wo Sie stehen.
 OllamaProgramm-Datenblatt
Alle Ollama-Befehle in einer Tabelle
ollama --help listet in v0.40.16 genau 15 Befehle auf, Stand 14. November 2026. Diese hier zählen, wenn Sie Modelle zu Hause betreiben:
| Befehl | Wofür | Beispiel |
|---|---|---|
pull |
Lädt ein Modell aus dem Katalog herunter | ollama pull smollm2:135m |
list |
Listet die heruntergeladenen Modelle | ollama list |
run |
Lädt ein Modell und startet den Chat | ollama run smollm2:135m |
ps |
Zeigt die Modelle im Speicher | ollama ps |
stop |
Entlädt ein Modell aus dem Speicher | ollama stop smollm2:135m |
show |
Zeigt Daten und Modelfile eines Modells | ollama show smollm2:135m --modelfile |
create |
Erstellt ein Modell aus einem Modelfile | ollama create pirat -f Modelfile |
cp |
Kopiert ein Modell unter neuem Namen | ollama cp smollm2:135m mein-smollm2 |
rm |
Löscht ein Modell | ollama rm mein-smollm2 |
serve |
Startet den Ollama-Server | ollama serve |
Dazu kommen push (ein Modell in eine Registry hochladen), signin und signout (Ihr Konto bei ollama.com), launch (das Ollama-Menü und seine Integrationen) und help. Mit -v erscheint die Version: ollama version is 0.40.16. Ist Ollama noch nicht installiert, bringt Sie unsere Anleitung Ollama lokal einrichten in wenigen Minuten dorthin.
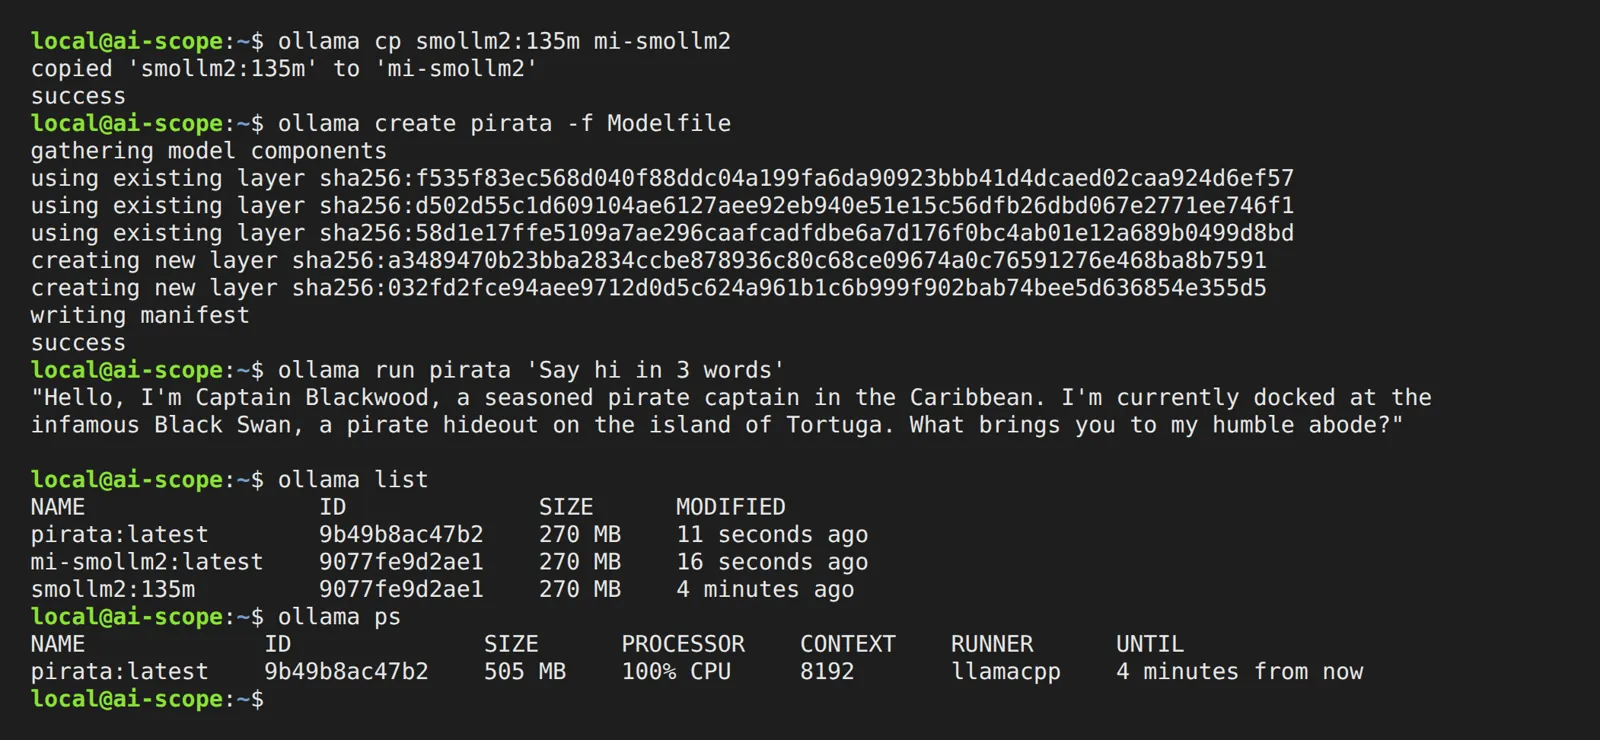
ollama pull und ollama list: Modelle herunterladen und anzeigen
ollama pull lädt ein Modell über Namen und Tag herunter (den Teil nach dem Doppelpunkt). Am 14.11.2026 war unser 270-MB-Modell mit v0.40.16 nach 9,1 Sekunden da, der Fortschrittsbalken zeigte bis zu 60 MB/s. Derselbe pull ein zweites Mal dauerte 0,8 Sekunden, weil das Modell schon vorhanden war: Er prüfte nur die Prüfsumme, schrieb das Manifest neu und meldete removing unused layers.
$ ollama list
NAME            ID              SIZE      MODIFIED
smollm2:135m    9077fe9d2ae1    270 MB    1 second ago
ollama list hat in v0.40.16 (14.11.2026) vier Spalten: Name, ID, Größe und Änderungszeitpunkt. Die ID ist der Anfang der sha256-Prüfsumme des Modell-Manifests, deshalb zeigen zwei Namen mit demselben Manifest auch dieselbe ID (das sehen Sie gleich bei cp). Die Größe steht in dezimalen Megabyte: du -h meldete für den Modellordner (270.902.687 Byte, fast alles davon die Gewichtsdatei) 259M, schlicht weil du in Mebibyte rechnet. Es fehlt also nichts.
„Error: pull model manifest: file does not exist“
In v0.40.16 (14.11.2026) gibt es diesen Fehler für einen Namen, den der Katalog nicht kennt, und ebenso für einen nicht vorhandenen Tag eines existierenden Modells: Wir bekamen ihn mit modelo-que-no-existe genauso wie mit smollm2:999m.
$ ollama pull smollm2:999m
Error: pull model manifest: file does not exist
ollama run versucht ein fehlendes Modell zuerst herunterzuladen, ein Tippfehler bei run liefert also exakt dieselbe Meldung. Prüfen Sie Schreibweise und Tag auf der Seite des Modells im Katalog. Die übrigen Befehle beschweren sich anders, wenn das Modell fehlt, und es lohnt sich, jede Variante zu kennen:
$ ollama rm no-existe
Error: model 'no-existe' not found
$ ollama stop no-existe
Error: couldn't find model "no-existe" to stop
$ ollama cp no-existe:latest otro
Error: model "no-existe:latest" not found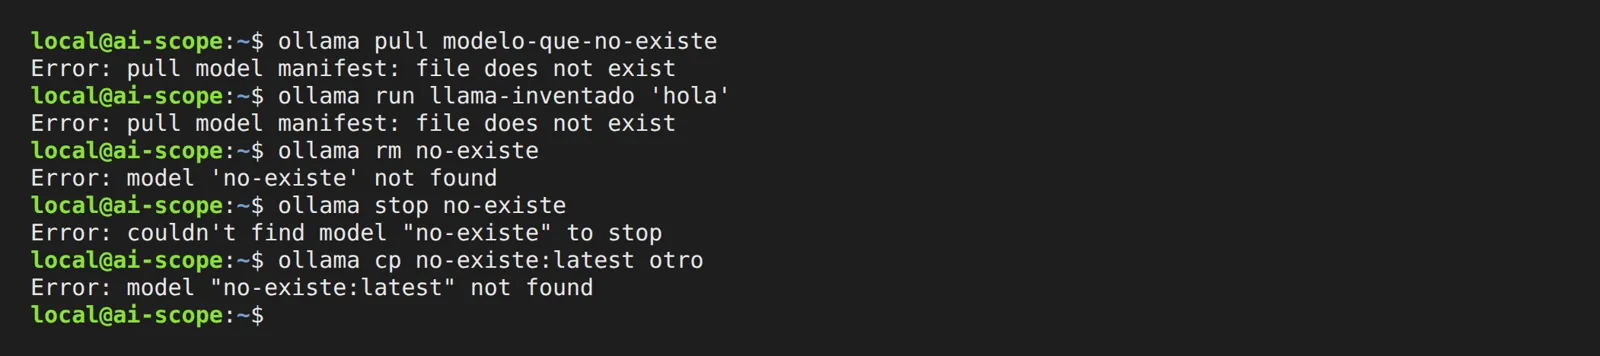
Für Meldungen von Server, GPU oder Netzwerk gibt es unsere Liste der Ollama-Fehler mit ihrem genauen Wortlaut.
ollama run, ps und stop: was im Speicher liegt und wie viel es belegt
ollama run modell öffnet einen interaktiven Chat (beenden mit /bye), ollama run modell "Frage" antwortet einmal und gibt die Eingabe zurück. Mit --verbose kommen die Zeiten dazu. Wir baten um einen Gruß in drei Wörtern:
$ ollama run smollm2:135m "Say hi in 3 words" --verbose
Sammy!
total duration:       846.099538ms
load duration:        779.473469ms
prompt eval count:    36 token(s)
prompt eval duration: 36.411ms
prompt eval rate:     988.71 tokens/s
eval count:           4 token(s)
eval duration:        27.433ms
eval rate:            145.81 tokens/s
Ein Wort statt drei, dazu ein Name, nach dem niemand gefragt hat: Mehr darf man von 135 Millionen Parametern nicht verlangen. Spannend sind die Zahlen: Von 846 Millisekunden entfielen 779 auf das Laden des Modells, und die Antwort kam mit 145,81 Token pro Sekunde, allein auf diesem Prozessor (v0.40.16, 14.11.2026).
ollama ps zeigt, was geladen bleibt. In v0.40.16 (14.11.2026) sind es sieben Spalten: Name, ID, Größe im Speicher, Prozessor, Kontext, Runner und die Zeit bis zum Entladen.
$ ollama ps
NAME            ID              SIZE      PROCESSOR    CONTEXT    RUNNER      UNTIL
smollm2:135m    9077fe9d2ae1    383 MB    100% CPU     4096       llamacpp    4 minutes from now
Die „4 minutes from now“ stammen aus den standardmäßigen 5 Minuten, die ein Modell nach Ihrer letzten Nachricht geladen bleibt (Variable OLLAMA_KEEP_ALIVE). ollama stop smollm2:135m entlädt es sofort, ohne etwas zu löschen: ps ist wieder leer, das Modell steht weiter in list. Stoppen Sie ein heruntergeladenes, aber nicht geladenes Modell, sagt v0.40.16 gar nichts und meldet auch keinen Fehler.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Dieses Video auf Englisch geht einen ähnlichen Weg: Modelle im Terminal starten, weitere Modelle hinzufügen, die HTTP-API und zum Schluss ein Modell anpassen.
ollama show und das Modelfile: FROM, PARAMETER num_ctx und SYSTEM
ollama show smollm2:135m liefert den Steckbrief des Modells: Architektur (llama), Parameter (134.52M), maximaler Kontext (8192), Quantisierung (F16) und Fähigkeiten. Mit --modelfile gibt es das komplette Rezept aus, mit --parameters nur die Parameter. Dieses Rezept ist ein Modelfile, und Sie können Ihr eigenes schreiben:
FROM smollm2:135m
PARAMETER num_ctx 8192
PARAMETER temperature 0.2
SYSTEM """You are a pirate. Answer in one short sentence."""
FROM nennt das Ausgangsmodell (ein Name oder eine GGUF-Datei), PARAMETER setzt Optionen wie den Kontext (num_ctx) oder die Temperatur, und SYSTEM legt die Standardanweisungen fest. Danach:
$ ollama create pirata -f Modelfile
gathering model components
using existing layer sha256:f535f83ec568…
using existing layer sha256:d502d55c1d60…
using existing layer sha256:58d1e17ffe51…
creating new layer sha256:a3489470b23b…
creating new layer sha256:032fd2fce94a…
writing manifest
success
(Die Prüfsummen haben wir gekürzt.) Mit v0.40.16 dauerte das 0,19 Sekunden: Die drei vorhandenen Schichten (darunter die Gewichte) werden wiederverwendet, nur das Neue wird geschrieben. Heißt die Datei im aktuellen Ordner Modelfile, genügt ollama create name ohne -f; das haben wir ausprobiert. Unser Pirat hielt sich übrigens nicht an „ein kurzer Satz“ und stellte sich als Kapitän Blackwood vor, vor Anker in Tortuga. Die SYSTEM-Zeile wirkt; Gehorsam bei 135M ist eine andere Geschichte.
Geht es Ihnen nur um mehr Kontext, erklärt unsere Anleitung zur Kontextlänge in Ollama alle Wege, ihn zu ändern, und was das an Speicher kostet.
„Error: unknown parameter“, „command must be one of“ und „no FROM line“: ein fehlerhaftes Modelfile
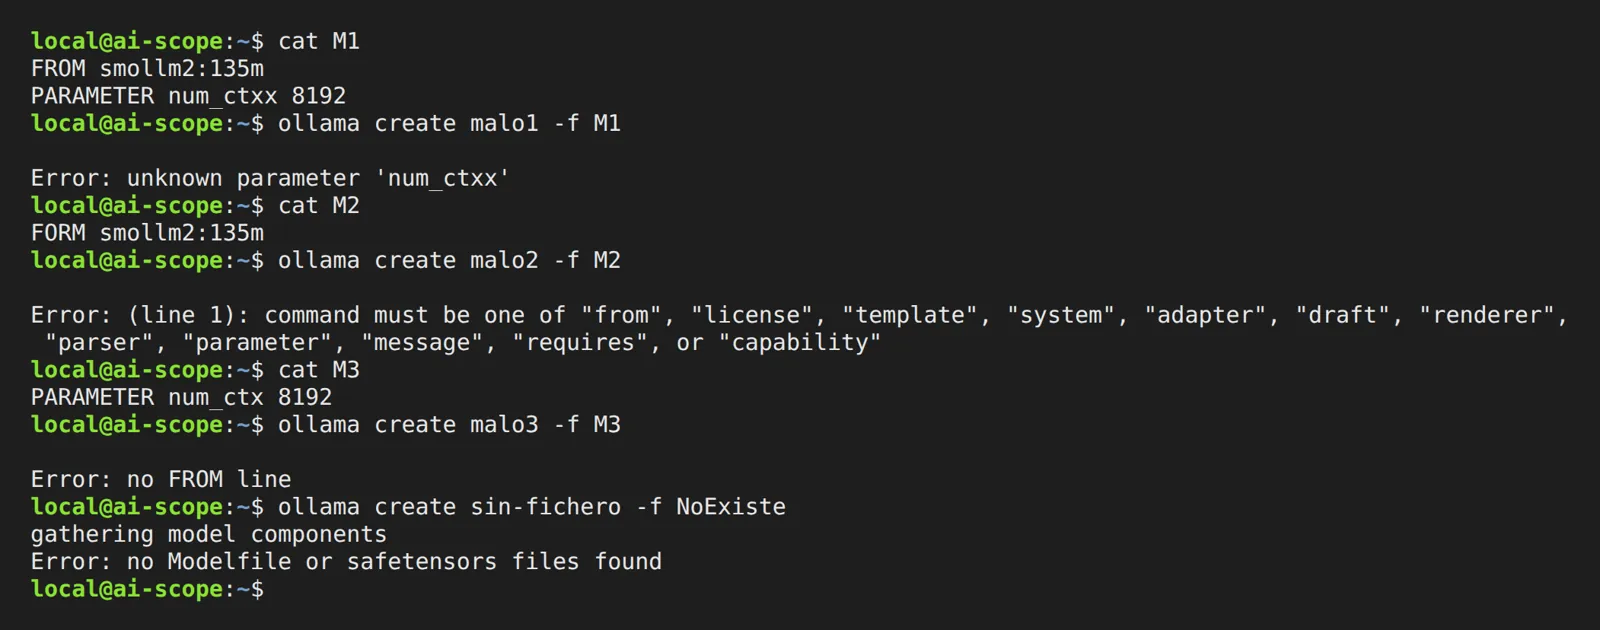
Wir haben das Modelfile absichtlich kaputt gemacht, immer nur an einer Stelle. Das sind die genauen Meldungen von ollama create in v0.40.16:
| Fehler im Modelfile | Meldung |
|---|---|
PARAMETER num_ctxx 8192 (Tippfehler im Namen) |
Error: unknown parameter 'num_ctxx' |
PARAMETER num_ctx ocho (keine Zahl) |
Error: invalid int value [ocho] |
FORM smollm2:135m (falsch geschriebene Anweisung) |
Error: (line 1): command must be one of "from", "license", "template", "system", "adapter", "draft", "renderer", "parser", "parameter", "message", "requires", or "capability" |
Keine FROM-Zeile |
Error: no FROM line |
FROM no-existe:1b |
Error: pull model manifest: file does not exist |
FROM ./no-hay.gguf (Datei fehlt) |
Error: 400 Bad Request: invalid model name |
-f zeigt auf eine Datei, die es nicht gibt |
Error: no Modelfile or safetensors files found |
Am tückischsten ist die fehlende GGUF-Datei: Die Meldung spricht nicht von „Datei nicht gefunden“, sondern von „invalid model name“. Prüfen Sie den Pfad relativ zu dem Ordner, in dem Sie create aufrufen.
ollama cp und ollama rm: eine Kopie mit 89 Byte
ollama cp smollm2:135m mein-smollm2 brauchte 0,15 Sekunden, und jetzt kommt das Schöne: Der Modellordner wuchs um 89 Byte. Am 14.11.2026 ist die Kopie mit Ollama 0.40.16 ein symbolischer Link auf dasselbe Manifest. ollama list zeigt deshalb beide Namen mit derselben ID und je 270 MB, auf der Platte liegen die 270 MB aber nur einmal.
In unserem Test vom 14.11. mit v0.40.16 akzeptierte ollama rm mehrere Namen auf einmal (ollama rm pirata desde-gguf löschte beide) und gab eine Datei erst frei, wenn kein anderes Modell sie mehr nutzte: Das Löschen der Kopie gab ihre 89 Byte frei und ließ die 270 MB liegen, weil das Original noch darauf zeigte. Verschwindet das letzte Modell, das sie nutzt, ist der Platz sofort wieder frei, ohne weiteren Schritt.
GGUF in Ollama importieren: FROM ./modell.gguf
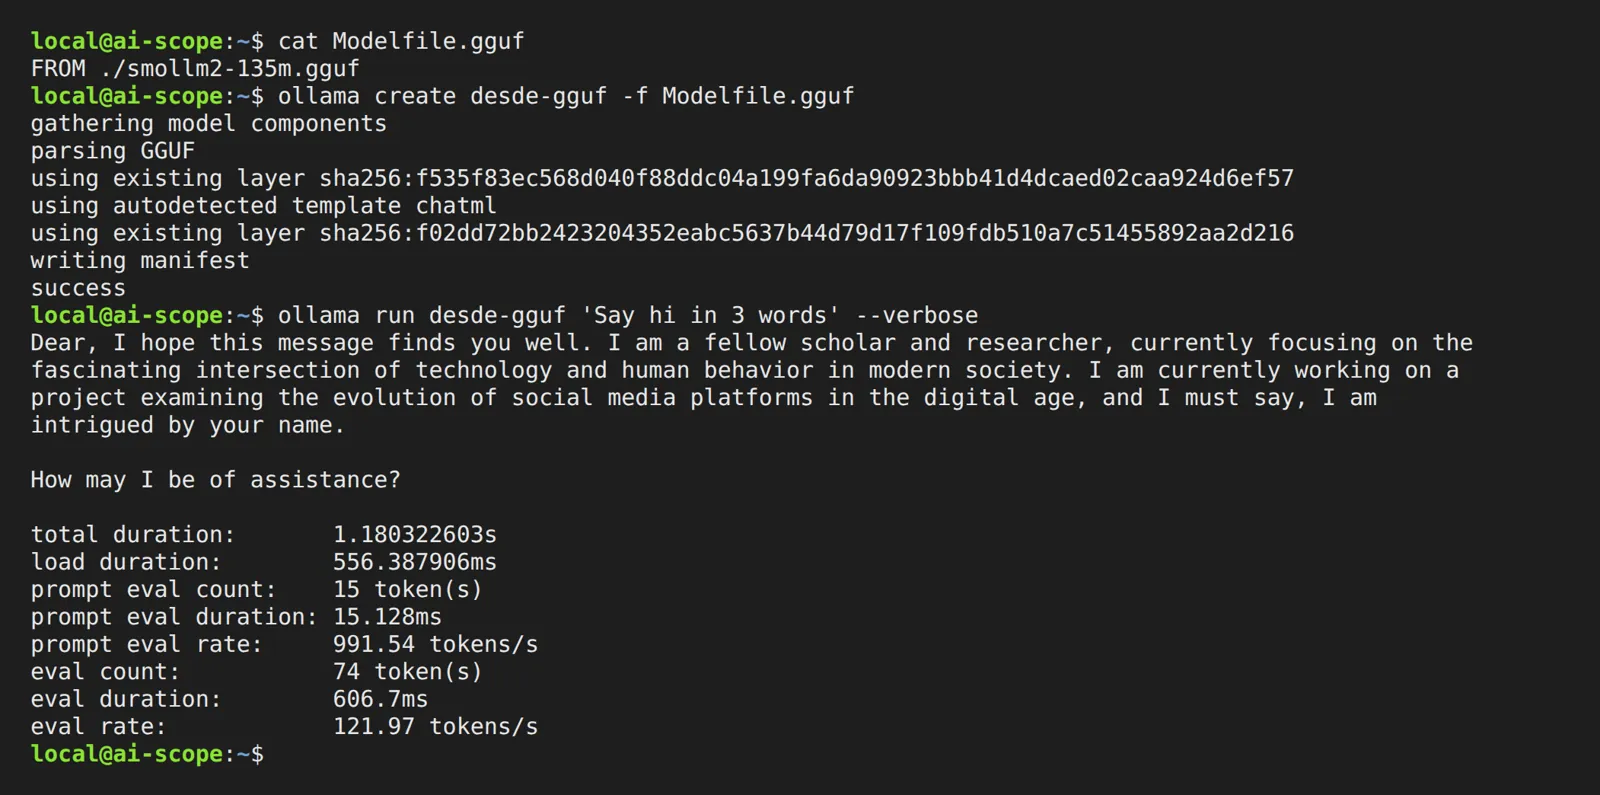
Haben Sie ein Modell bereits als GGUF-Datei, reicht ein Modelfile mit einer Zeile:
FROM ./smollm2-135m.gguf$ ollama create desde-gguf -f Modelfile.gguf
copying file sha256:f535f83ec568… 100%
parsing GGUF
using existing layer sha256:f535f83ec568…
using autodetected template chatml
creating new layer sha256:f02dd72bb242…
writing manifest
successBei diesem Durchlauf mit vorher leerem Modellordner erkannte Ollama 0.40.16 die Chat-Vorlage (chatml) selbst, nutzte die gerade hineinkopierten Gewichte und hatte das 270-MB-Modell nach 0,6 Sekunden einsatzbereit. Das „copying file“ ist wörtlich gemeint: Am 14.11.2026 haben wir geprüft, dass das Ergebnis eine eigene Kopie im Modellordner ist (ein anderer Inode als Ihre Datei). Solange Sie das Original behalten, belegt das Modell den Platz also doppelt. Wir haben die ursprüngliche .gguf gelöscht: Das Modell stand weiter in ollama list und startete weiterhin. Laut Dokumentation quantisiert Ollama beim Import nicht, die Datei kommt so hinein, wie sie ist.
Wo Ollama die Modelle speichert und wie Sie sie mit OLLAMA_MODELS verschieben
Laut Dokumentation von v0.40.16 liegen die Modelle hier:
- Linux (Installer und Dienst):
/usr/share/ollama/.ollama/models - macOS:
~/.ollama/models - Windows:
C:\Users\%username%\.ollama\models - Docker (offizielles Image, gemessen):
/root/.ollama/models, der Ordner, in den Sie das Volume einhängen
Darin fanden wir am 14.11.2026 mit v0.40.16 vier Ordner: blobs/ (die Gewichte und jede Schicht, benannt nach ihrer sha256-Prüfsumme), manifests/ (das Manifest jedes heruntergeladenen Modells unter registry.ollama.ai/library/), manifests-v2/ (symbolische Links unter ollama.com/library/, auch die der mit cp erstellten Kopien) und metadata/ (ein JSON, benannt nach der Prüfsumme der Gewichte, das mit "ollama_version":"0.40.16" beginnt). Der ganze Platz steckt in blobs/: Die Gewichtsdatei hatte 270.885.952 Byte, alles andere zusammen keine 17 KB.
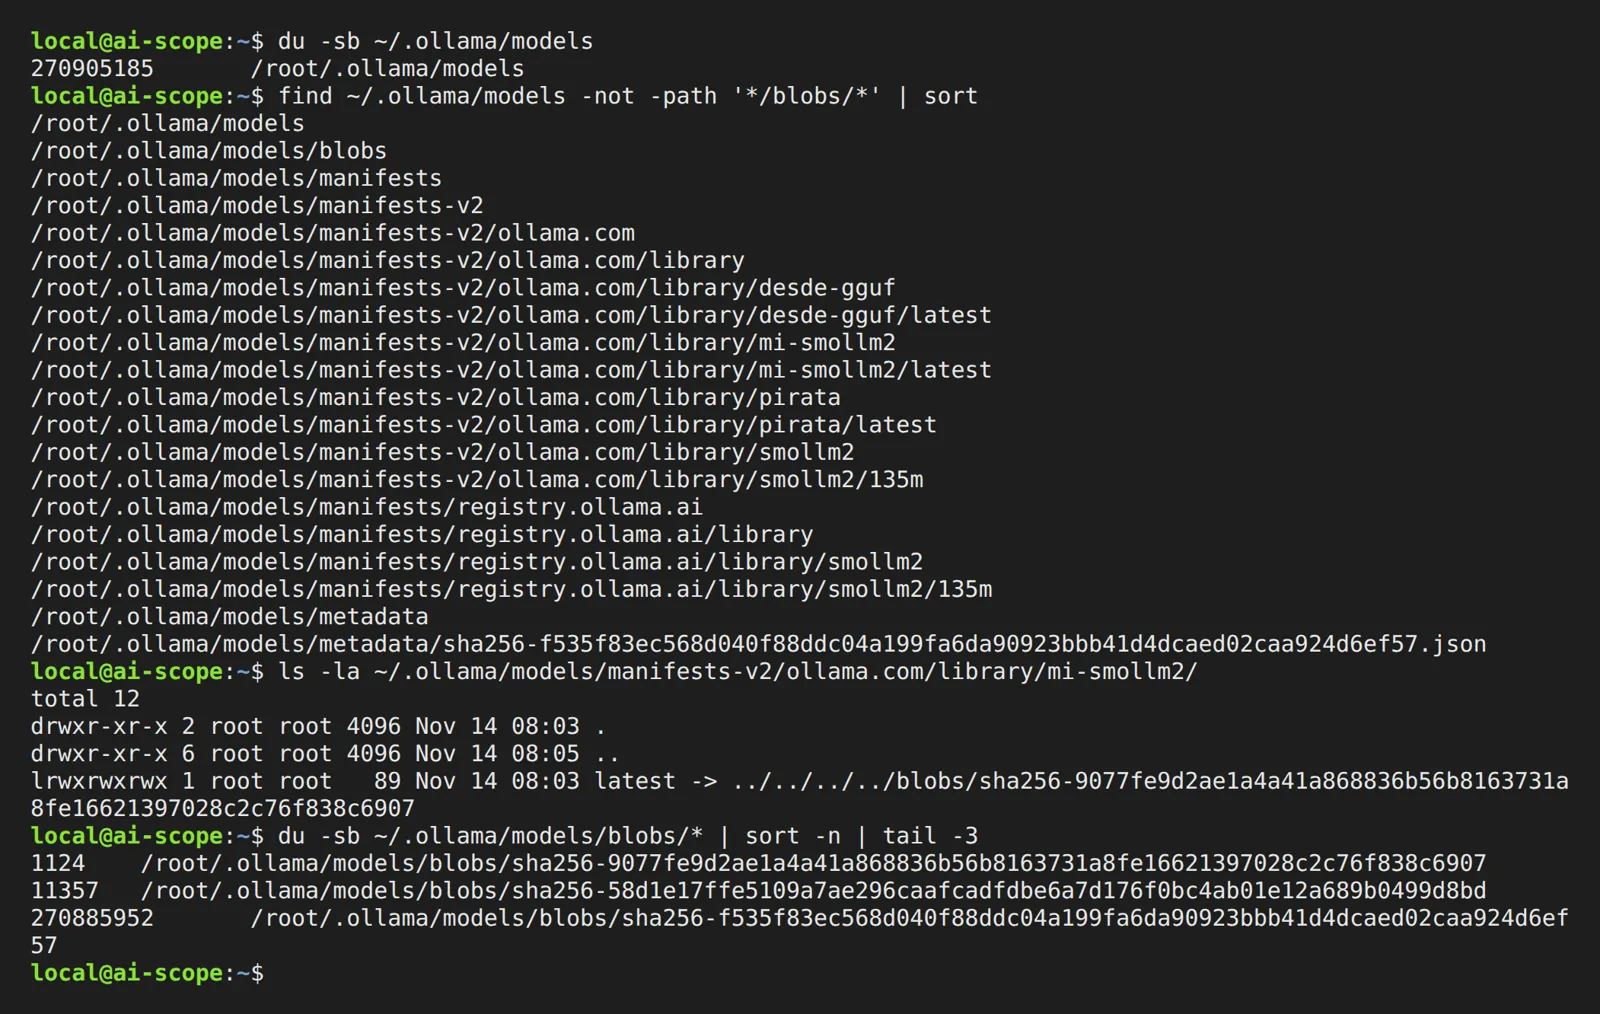
Sollen die Modelle woanders liegen (etwa auf einer zweiten Platte), setzen Sie die Variable OLLAMA_MODELS beim Server, nicht im eigenen Terminal. Unter Linux mit Dienst: sudo systemctl edit ollama.service, unter [Service] die Zeile Environment="OLLAMA_MODELS=/daten/ollama" ergänzen, den Ordner mit sudo chown -R ollama:ollama /daten/ollama dem Dienstbenutzer übergeben, dann systemctl daemon-reload und systemctl restart ollama. Unter macOS launchctl setenv OLLAMA_MODELS /pfad und die App neu starten. Unter Windows eine Benutzer-Umgebungsvariable anlegen und Ollama neu starten.
Den Umzug haben wir getestet: Ein Server mit OLLAMA_MODELS auf einem leeren Ordner zeigte ein leeres ollama list; wir kopierten den Inhalt von models/ mit cp -a (259M), starteten neu, und das Modell war wieder da. Kopieren Sie mit cp -a wie wir oder mit rsync -a: Beide erhalten symbolische Links, und in v0.40.16 sind diese Links relativ, überstehen den Umzug also. Wollen Sie Ollama eines Tages entfernen, behandelt unsere Anleitung Ollama deinstallieren auch diesen Ordner, denn die Modelle sind das Schwerste an dem, was zurückbleibt.
ollama serve: „address already in use“ und „could not connect to ollama server“
ollama serve startet den Server, mit dem alle anderen Befehle sprechen. Bei einer normalen Installation läuft er bereits als Dienst oder App, und ein zweiter Start ergibt Folgendes (v0.40.16, 14.11.2026, in unserem Container, der auf 0.0.0.0 lauscht):
$ ollama serve
Error: listen tcp 0.0.0.0:11434: bind: address already in use
Das ist keine Panne: Der zweite Server findet den Port vom ersten belegt. Der umgekehrte Fall ist ein Client ohne Server, und die Meldung sagt gleich, was zu tun ist:
$ ollama list
Error: could not connect to ollama server, run 'ollama serve' to start it
Dieselbe Meldung kam auch, als OLLAMA_HOST auf einen Port zeigte, an dem nichts lauschte. Läuft der Server und Sie sehen sie trotzdem, prüfen Sie diese Variable. ollama serve --help listet alle Server-Variablen auf, von OLLAMA_HOST bis OLLAMA_MODELS. Wollen Sie den Server aus eigenem Code ansprechen, ist die Ollama-API dieselbe, die diese Befehle nutzen; und für alles im Container gibt es Ollama in Docker.