Docker Model Runner ist Dockers eigener Weg, KI-Modelle auf Ihrem Rechner auszuführen: ein Plugin docker model und ein Container, der die Modelle mit llama.cpp ausführt und auf Port 12434 eine OpenAI- und Ollama-kompatible API bereitstellt. Unter Linux installieren Sie es mit apt-get install docker-model-plugin, auf Mac und Windows schalten Sie es in Docker Desktop ein.
Wir haben Version 1.2.9 am 17. November 2026 auf einem Linux-Server mit Docker Engine 29.9.3, Ubuntu 26.04 und ohne Grafikkarte installiert (ein AMD Ryzen 7 7730U mit 16 Threads) und alles gemessen, was ging: wie lange es dauert, wie viel Platte und Arbeitsspeicher es belegt, auf welchen Adressen es lauscht, was es ins Netz schickt und wie es mit demselben Modell gegen Ollama abschneidet. Außerdem haben wir es absichtlich kaputt gemacht, denn bei Fehlermeldungen geht die meiste Zeit verloren. Alles in diesem Ratgeber bezieht sich auf diese Version und dieses Datum.
Was Docker Model Runner ist (und was nicht)
Es ist keine neue Inferenz-Engine. In Version 1.2.9 zeigt docker model status auf unserem Rechner llama.cpp als einzige laufende Engine, alle anderen als nicht installiert: diffusers, vllm („binary not found“), sglang und mlx („only supported on Apple Silicon“).
 llama.cppProgramm-Datenblatt
Was Docker beisteuert, ist die Verpackung. Modelle werden wie Images heruntergeladen, aus dem Bereich ai/ auf Docker Hub oder direkt von Hugging Face mit hf.co/…, und mit Befehlen verwaltet, die Ihnen bekannt vorkommen, wenn Sie Docker schon nutzen: pull, run, list, ps, rm. Unter Linux mit Docker Engine lebt das alles in einem Container namens docker-model-runner mit einem Volume namens docker-model-runner-models. Wenn Sie lieber direkt mit llama.cpp arbeiten, beschreibt unser Ratgeber llama.cpp lokal ausführen diesen Weg.
Docker Model Runner unter Linux installieren (docker-model-plugin)
Unter Linux kommt das Plugin aus Dockers eigenem Repository, demselben, aus dem auch Docker Engine stammt. Vor der Installation scheitert jeder docker model-Befehl mit dieser Meldung:
$ docker model version
docker: unknown command: docker model
Die Installation ist ein einziges Paket:
sudo apt-get update
sudo apt-get install docker-model-plugin
Unter Fedora und anderen RPM-Distributionen lautet der Befehl sudo dnf install docker-model-plugin. Auf unserem Server dauerte apt-get install 4,53 Sekunden und hinterließ eine einzige 28-MB-Datei in /usr/libexec/docker/cli-plugins/docker-model. Docker wurde nicht neu gestartet, und keiner der laufenden Container hat etwas davon bemerkt.
Die eigentliche Installation passiert bei der ersten Nutzung. Unser erstes docker model run ai/smollm2 "…" dauerte insgesamt 20,53 Sekunden. In dieser Zeit lud es das Image docker/model-runner:latest (356 MB komprimiert, 1,37 GB auf der Platte), legte das Modell-Volume an, startete den Container, lud das 270,60 MB große Modell und beantwortete die Frage. Danach kam eine Frage an das bereits geladene Modell in 0,35 Sekunden zurück.
Auf Mac und Windows einschalten (Docker Desktop)
In Docker Desktop gibt es nichts zu installieren: Öffnen Sie Settings → AI und setzen Sie den Haken bei Enable Docker Model Runner. Unter Windows mit einer NVIDIA-Karte erscheint ein zweites Kästchen, Enable GPU-backed inference. Wenn Sie die API vom Rechner selbst aus aufrufen wollen (etwa aus einem Skript oder einem Editor), aktivieren Sie zusätzlich Enable host-side TCP support oder führen Sie docker desktop enable model-runner --tcp 12434 aus.
Die Voraussetzungen laut Docker, die wir gelesen, hier aber nicht testen konnten: ein Mac mit Apple Silicon; unter Windows x64 NVIDIA-Treiber ab 576.57; unter Windows auf Arm eine Adreno-GPU ab 6xx. Unter Linux mit Docker Engine läuft es auf CPU, NVIDIA (CUDA, Treiber ab 575.57.08), AMD (ROCm) und Vulkan. Auf Mac und Windows läuft die Engine nicht wie unter Linux in einem Container, sondern in einer abgeschotteten Umgebung des Systems selbst.
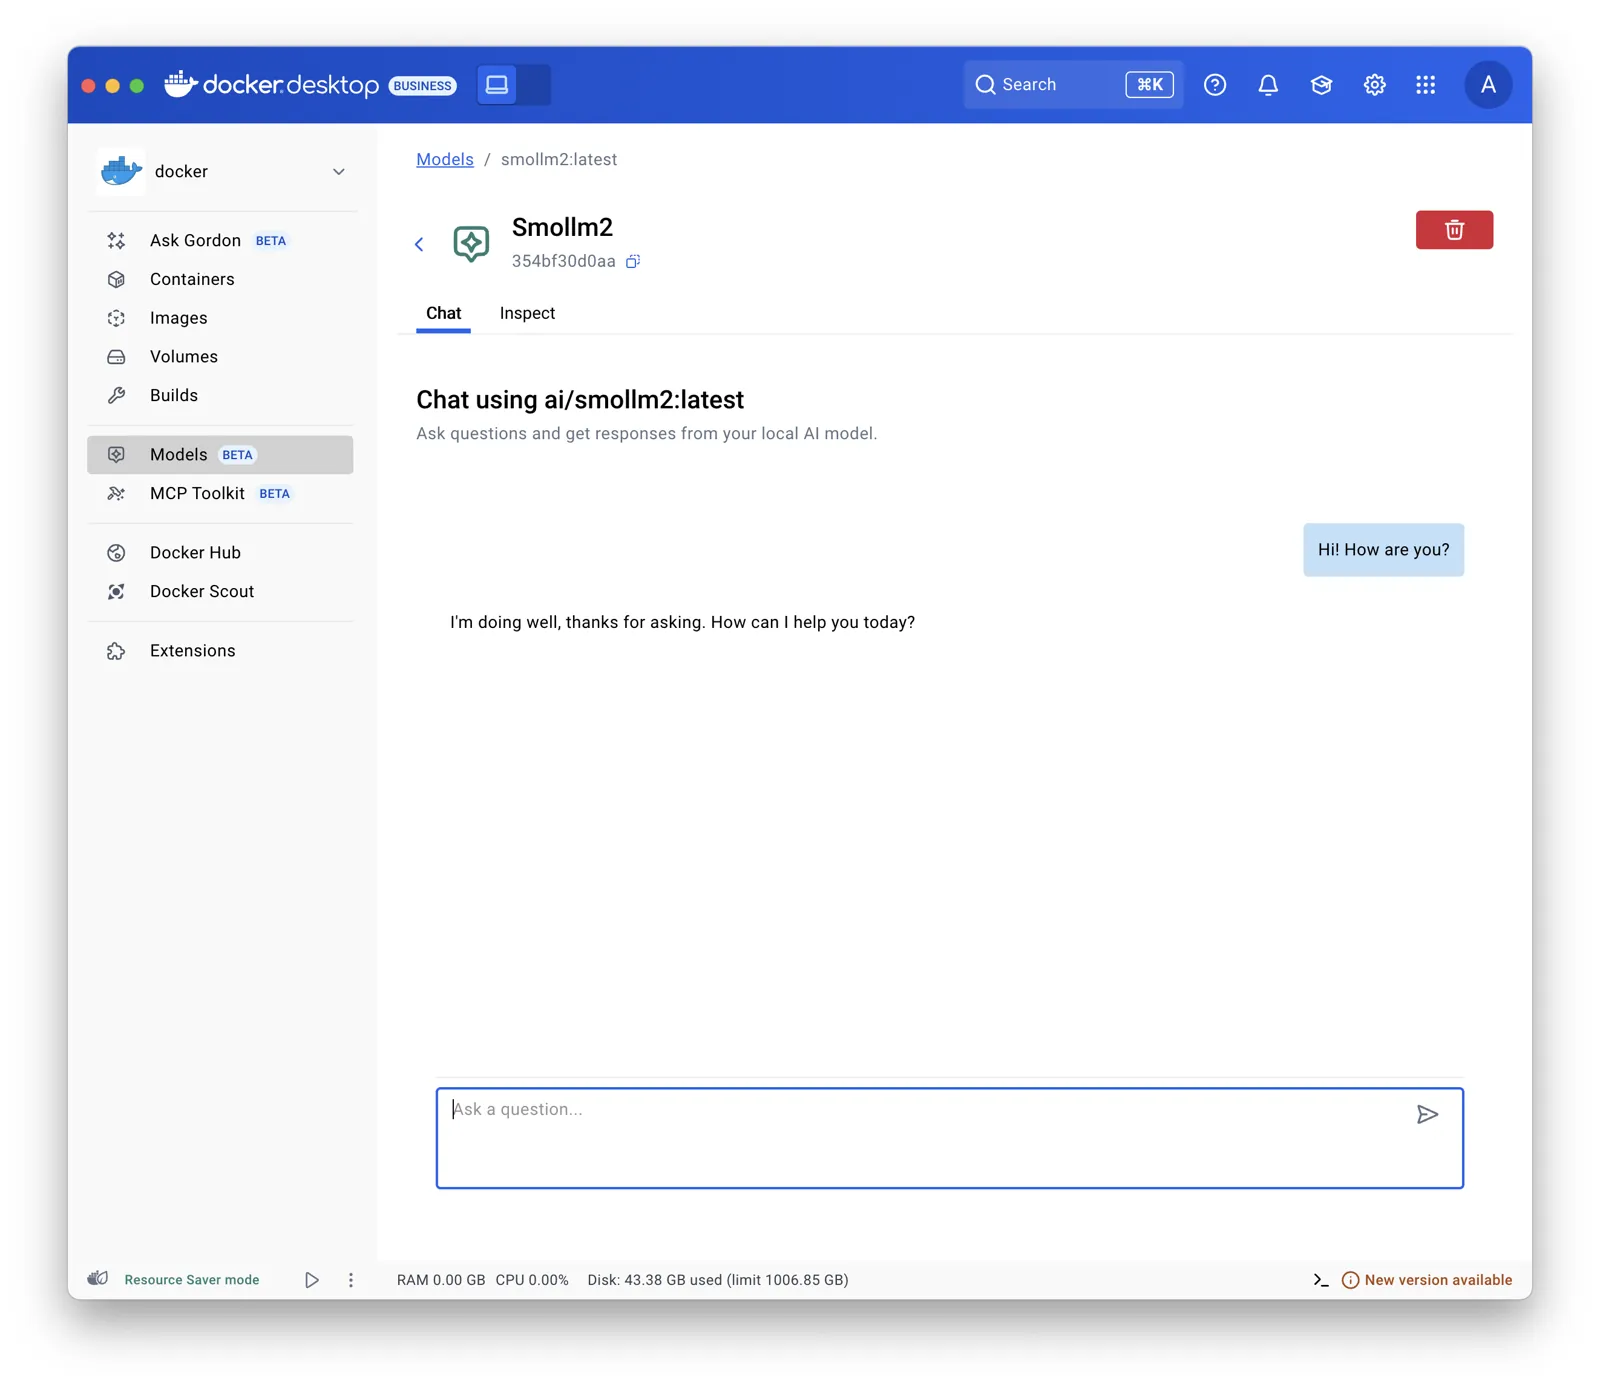
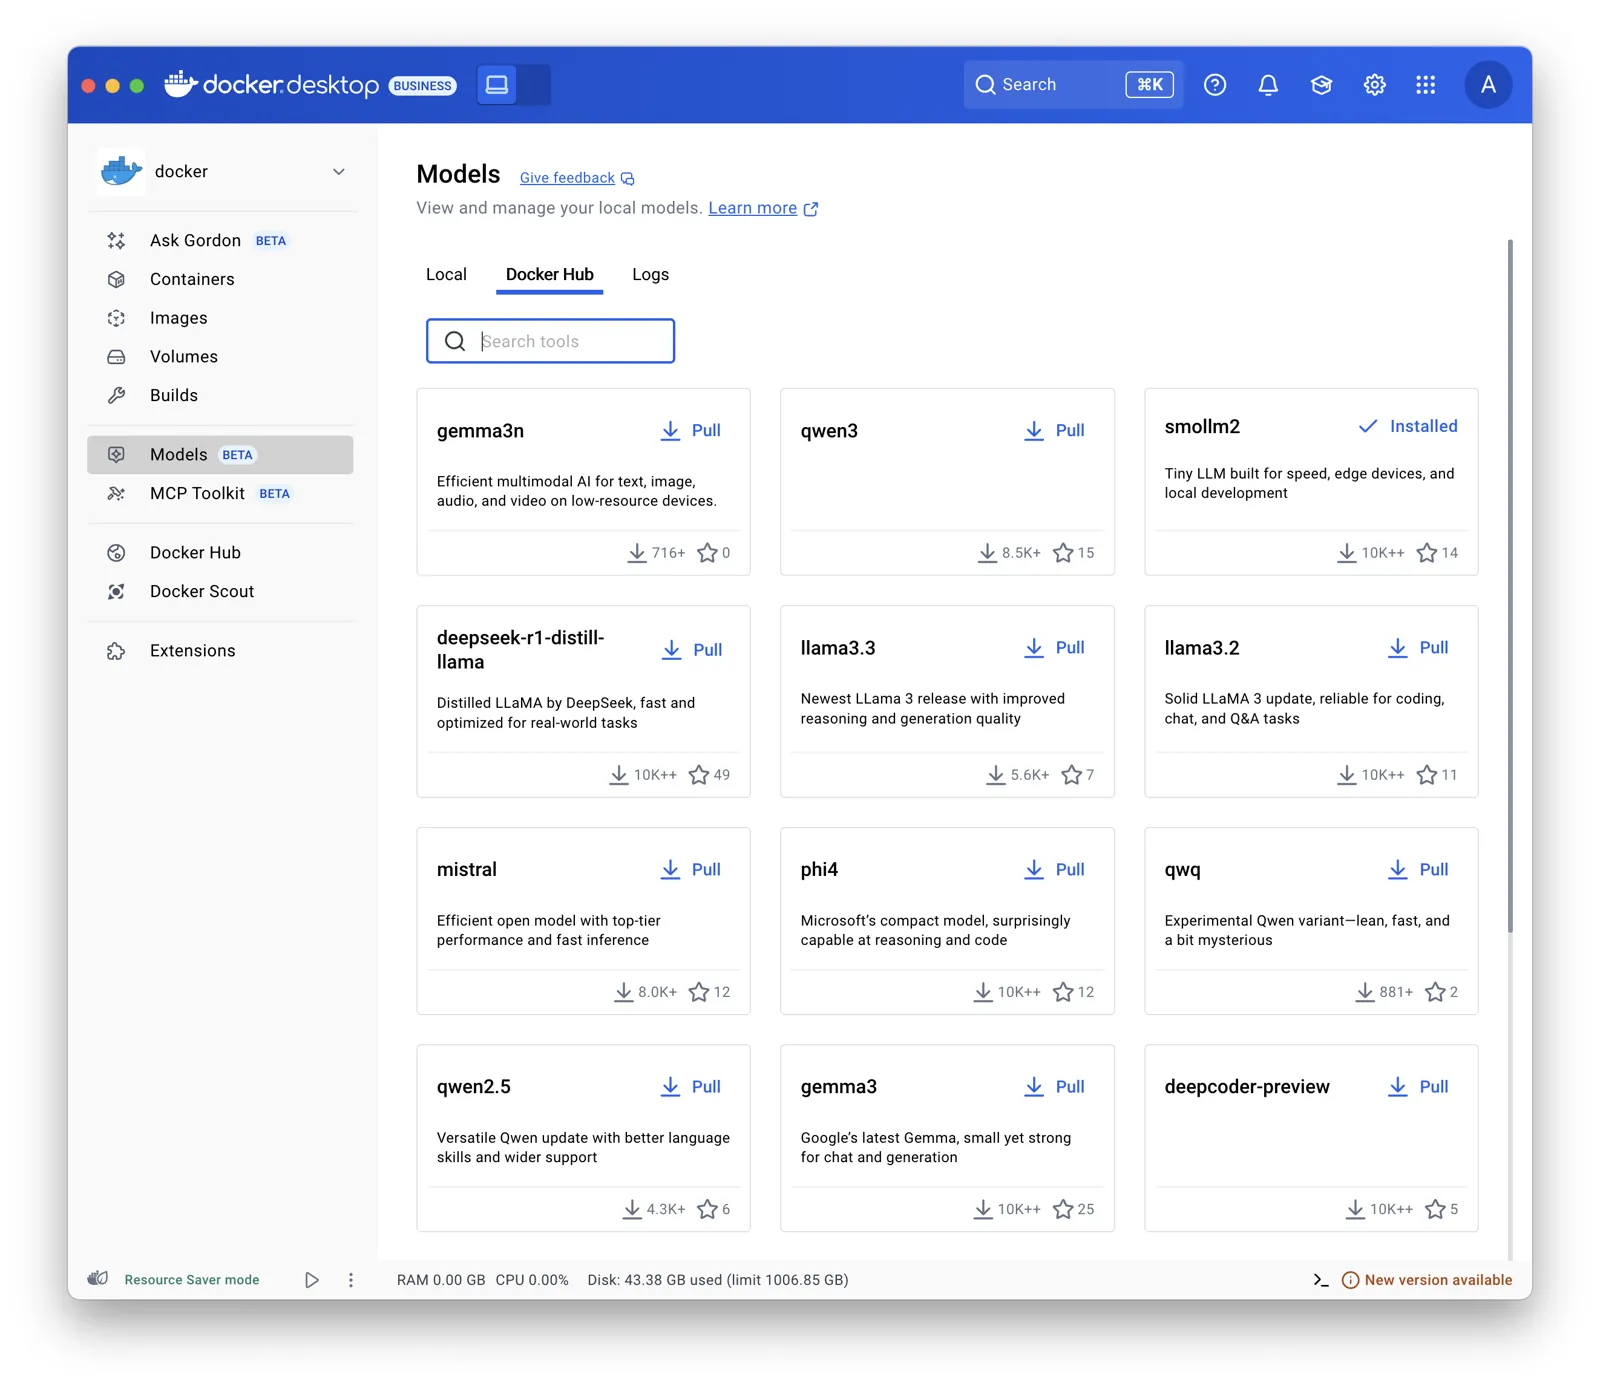
Desktop bringt außerdem einen Bereich Models mit dem Katalog und einem Chat mit, in dem Sie jedes Modell ohne Terminal ausprobieren können.
Ihr erstes Modell: docker model run ai/smollm2
docker model run funktioniert auf zwei Arten: Mit einer Frage in Anführungszeichen antwortet es einmal und gibt Ihnen die Eingabezeile zurück; ohne Frage öffnet es einen interaktiven Chat (verlassen mit /bye, laut seinem Code). Fehlt das Modell, lädt es dieses zuerst herunter. Wir haben ai/smollm2 gewählt (361,82 Millionen Parameter, quantisiert in Q4_K_M), weil es winzig ist und allein mit dem Prozessor in unter einer Sekunde antwortet. Dafür hat es seine Eigenheiten: Wir baten es, bis drei zu zählen, und es antwortete „Three, four, five.“. Kleines Modell, großer Eifer.
$ docker model list
MODEL NAME  PARAMETERS  QUANTIZATION    ARCHITECTURE  MODEL ID      CREATED        CONTEXT  SIZE
smollm2     361.82 M    IQ2_XXS/Q4_K_M  llama         354bf30d0aa3  20 months ago           256.35 MiB
docker model ps zeigt, was im Arbeitsspeicher geladen ist und bis wann: Nach jeder Nutzung stand bei unserem Modell „4 minutes from now“ in der Spalte UNTIL. Wir haben es in Ruhe gelassen, um zu sehen, was passiert: 5 Minuten nach der letzten Frage entlud es sich von selbst, der Engine-Prozess verschwand und der Container fiel auf 8,7 MiB Arbeitsspeicher. docker model unload ai/smollm2 entlädt es sofort, ohne etwas zu löschen („Unloaded 1 model(s).“), und die nächste Frage, bei der das Modell neu geladen wurde, dauerte 0,77 Sekunden. Zum Löschen von der Platte dient docker model rm ai/smollm2.
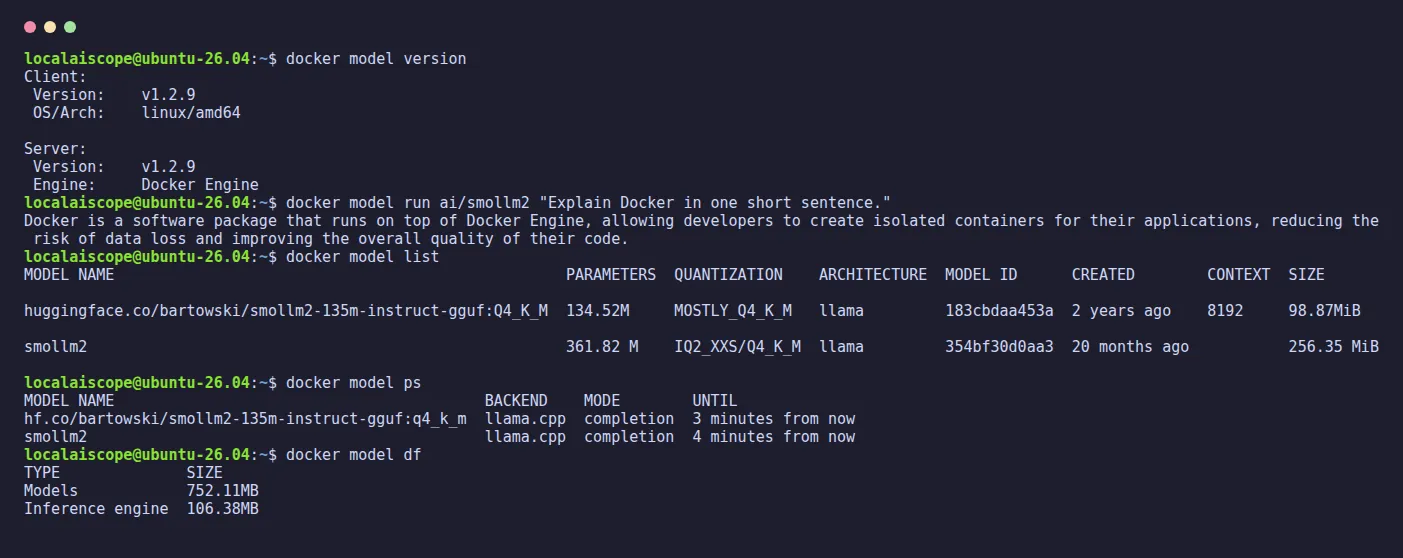
Modelle von Hugging Face kommen mit dem Präfix hf.co/ und der Quantisierung als Tag. docker model pull hf.co/bartowski/SmolLM2-135M-Instruct-GGUF:Q4_K_M brauchte 3,26 Sekunden für 105,45 MB, auch wenn der Fortschrittszähler bis „Downloaded 210.92MB of 105.45MB“ kam: das Doppelte dessen herunterzuladen, was eine Datei wiegt, ist auch eine Leistung. In list erscheint es danach als huggingface.co/bartowski/smollm2-135m-instruct-gguf:Q4_K_M.
Die API von Docker Model Runner auf Port 12434
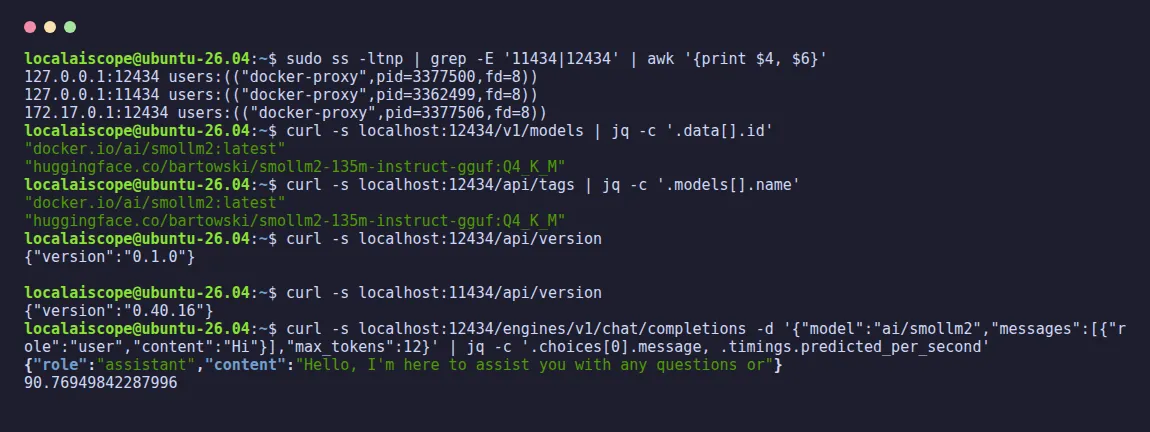
Mit Docker Engine lauscht der Runner auf 127.0.0.1:12434 und auf 172.17.0.1:12434 (die Adresse des Rechners im Standardnetz von Docker). Er lauscht nur auf diesen zwei Adressen: Vom Server selbst aus, über seine Adresse im lokalen Netz, schlug die Verbindung fehl. Laut Docker hat die API keine Authentifizierung; verlangt ein Client einen Schlüssel, genügt ein beliebiger Text.
Derselbe Port bedient drei Gruppen von Pfaden, und alle antworteten in unserem Test mit 200:
| Pfad | Kompatibel mit |
Was wir geprüft haben |
|---|---|---|
/engines/v1/models, /engines/v1/chat/completions |
OpenAI | Modellliste und Chat, mit usage und Zeiten |
/v1/models, /v1/chat/completions |
OpenAI (Alias) | Dieselbe Antwort wie /engines/v1 |
/api/tags, /api/ps, /api/chat, /api/generate, /api/version |
Ollama | Listet, chattet und generiert; Version 0.1.0 |
Eine erste Anfrage mit curl, die Ihnen nebenbei die Geschwindigkeit verrät (timings.predicted_per_second):
curl http://localhost:12434/engines/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"ai/smollm2","messages":[{"role":"user","content":"Hallo"}]}'
Weil er seinen eigenen Port nutzt, verträgt er sich problemlos mit Ollama: Wir hatten Ollama auf 11434 und Docker Model Runner auf 12434 gleichzeitig laufen, und jeder antwortete mit seiner Version. Wenn Sie von Ollama kommen: Unser Ratgeber zur Ollama-API nutzt dieselben /api/…-Pfade, hier ändert sich nur der Port.
Aus anderen Containern und mit Open WebUI nutzen
Aus einem Container im Standardnetz von Docker lautet die Adresse http://172.17.0.1:12434. Mit Compose können Sie ihr mit extra_hosts: ["model-runner.docker.internal:host-gateway"] einen Namen geben, denselben, den Docker Desktop verwendet. Ohne diese Zeile gibt es den Namen nicht: wget: bad address 'model-runner.docker.internal:12434'.
Auf unserem Server scheiterte der erste Versuch allerdings mit wget: can't connect to remote host (172.17.0.1): Operation timed out. Schuld war ufw mit seiner Standardregel, eingehende Verbindungen abzulehnen: Für die Firewall ist ein Container, der mit dem Rechner spricht, eingehender Verkehr. Eine Regel, die auf Dockers Schnittstelle und diesen Port beschränkt ist, löste das Problem, sowohl über 172.17.0.1 als auch über model-runner.docker.internal (mit der Zeile host-gateway):
sudo ufw allow in on docker0 to 172.17.0.1 port 12434 proto tcpNach der API, die wir getestet haben, würde sich Open WebUI über die Ollama-kompatible Schicht verbinden, mit OLLAMA_BASE_URL=http://172.17.0.1:12434 oder über die OpenAI-Schicht mit OPENAI_API_BASE_URL=http://172.17.0.1:12434/engines/v1. Diesmal haben wir Open WebUI nicht an Docker Model Runner angeschlossen; den Rest des Aufbaus (Volume, erster Benutzer, Port) finden Sie in unserem Ratgeber Open WebUI mit Ollama.
Was Docker Model Runner an Docker Hub schickt (und wie Sie es abschalten)
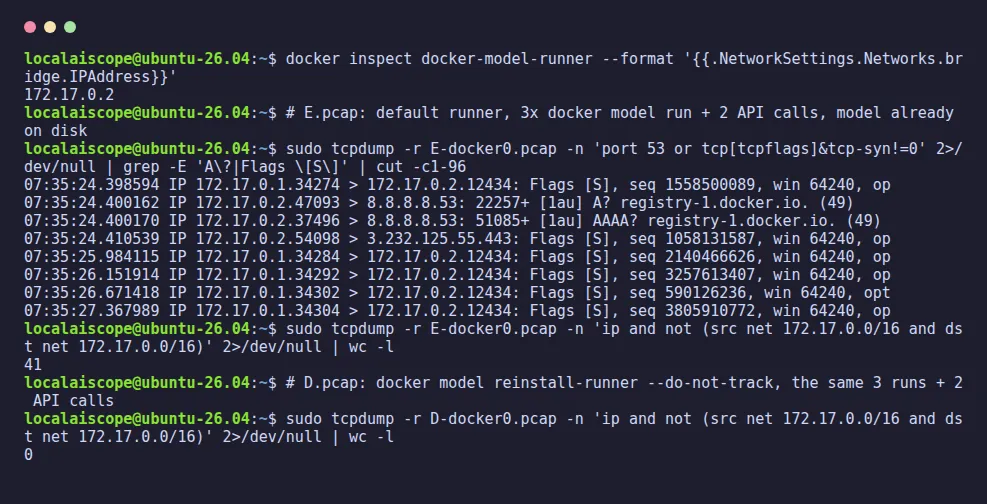
Auf diesen Test waren wir am meisten gespannt. Wir haben den Verkehr des Runner-Containers mit tcpdump auf docker0 mitgeschnitten, dem Standardnetz von Docker, an dem auf unserem Server nur dieser Container hing. Mit dem Modell bereits auf der Platte und den Standardeinstellungen bedeutete jede Nutzung eine Anfrage an registry-1.docker.io: Im Kontrolltest ergaben 3 docker model run und 2 API-Aufrufe eine DNS-Abfrage, eine verschlüsselte Verbindung zu Docker Hub und 5 Anfragen, nach der Größe der gesendeten Daten eine pro Nutzung, mit insgesamt 41 Paketen, die den Rechner verließen. Im Code von Version 1.2.9 ist diese Anfrage ein HEAD auf das Manifest des Modells, mit dem gezählt wird, welche Modelle genutzt werden.
Danach haben wir den Runner mit der Opt-out-Option neu installiert:
docker model reinstall-runner --do-not-trackDer Container startet dann mit DO_NOT_TRACK=1, und bei genau denselben 3 Ausführungen und 2 API-Aufrufen verließen 0 IPv4-Pakete den Rechner. Die Modelle bleiben, wo sie waren: Die Neuinstallation des Runners lässt das Volume unberührt.
--do-not-track Screenshot: unser Terminal, Docker Model Runner 1.2.9, 17.11.2026Docker Model Runner vs. Ollama: unsere Messung
Dasselbe Modell (SmolLM2 360M, quantisiert in Q4_K_M), derselbe Prompt (eine Geschichte von etwa 200 Wörtern, 256 Tokens, Temperatur 0), derselbe Prozessor, beide gleichzeitig am selben Tag. Ollama ist Version 0.40.16 im offiziellen Docker-Image; darunter nutzen beide llama.cpp. Achten Sie auf ein Detail: Ollamas Tag smollm2:360m ist die F16-Version (725 MB). Für einen fairen Vergleich haben wir daher smollm2:360m-instruct-q4_K_M genommen, das genauso viel wiegt wie das von Docker. In der Tabelle steht DMR für Docker Model Runner.
| 17.11.2026 | DMR 1.2.9 |
Ollama 0.40.16 |
|---|---|---|
| Tempo (tok/s) | 78–82 | 83–89 |
| Modell auf der Platte (MB) | 270,6 | 270,6 |
| Image auf der Platte (GB) | 1,37 | 8,52 |
| Engine-Prozess, RSS (MiB) | 224 | 484 |
| Container, docker stats (MiB) | 95 | 878 |
| Kontext im Test | 8.192 | 4.096 |
| Port | 12434 | 11434 |
Wenn Sie stattdessen Ollama in einem Container erwägen, erklärt unser Ratgeber Ollama in Docker Volume und Port; und um viele Nutzer mit einer NVIDIA-Grafikkarte zu bedienen, ist der Vergleich vLLM vs. Ollama der nächste Schritt.
GPU und vLLM: was wir testen konnten und was nicht
Unter Linux wählt der Runner laut dem Code von Version 1.2.9 sein Image nach der erkannten Grafikkarte: latest-cuda für NVIDIA, latest-rocm für AMD und das CPU-Image, wenn keine da ist. Sie können die Wahl mit --gpu cuda erzwingen und die Engine mit --backend vllm festlegen, was CUDA voraussetzt. Auf unserem Server ohne NVIDIA-Karte scheiterten beide Optionen, und das sollten Sie vor dem Ausprobieren wissen: --gpu cuda lud das CUDA-Image herunter (5,66 GB auf der Platte) und gab erst danach auf, nach 52,87 Sekunden. GPU-Geschwindigkeiten konnten wir nicht messen; sobald es geht, stehen sie hier mit Datum.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken.
Ein deutschsprachiges Video vom April 2025: Manche Bildschirme und Optionen können von Version 1.2.9 abweichen, die wir getestet haben.
Fehler von Docker Model Runner, mit ihrer genauen Meldung
Diese Meldungen haben wir am 17. November 2026 mit Version 1.2.9 erhalten, und das bedeuten sie:
| Meldung | Ursache | Was tun |
|---|---|---|
docker: unknown command: docker model |
Das Plugin ist nicht installiert | sudo apt-get install docker-model-plugin |
pull access denied, repository does not exist or may require authorization (status 500) |
Den Modellnamen gibt es nicht | Namen im Katalog ai/ prüfen |
failed with status 404 Not Found: Model not found |
Das Modell gibt es, diesen Tag nicht | Tag prüfen (der Teil nach dem Doppelpunkt) |
Failed to remove model: no such model |
rm eines Modells, das nicht vorhanden ist |
docker model list für den genauen Namen |
failed to bind host port 127.0.0.1:12434/tcp: address already in use |
Ein anderes Programm belegt Port 12434 | Port freigeben oder mit --port installieren |
--backend vllm requires CUDA GPU support |
vLLM ohne NVIDIA-GPU | Zur Standard-Engine (llama.cpp) zurückkehren |
failed to discover GPU vendor from CDI: no known GPU vendor found |
--gpu cuda ohne NVIDIA-GPU |
Ohne --gpu installieren |
dial tcp 127.0.0.1:12434: connect: connection refused |
Die CLI sucht den Runner auf 12434, er läuft aber woanders | MODEL_RUNNER_ auf den richtigen Port setzen |
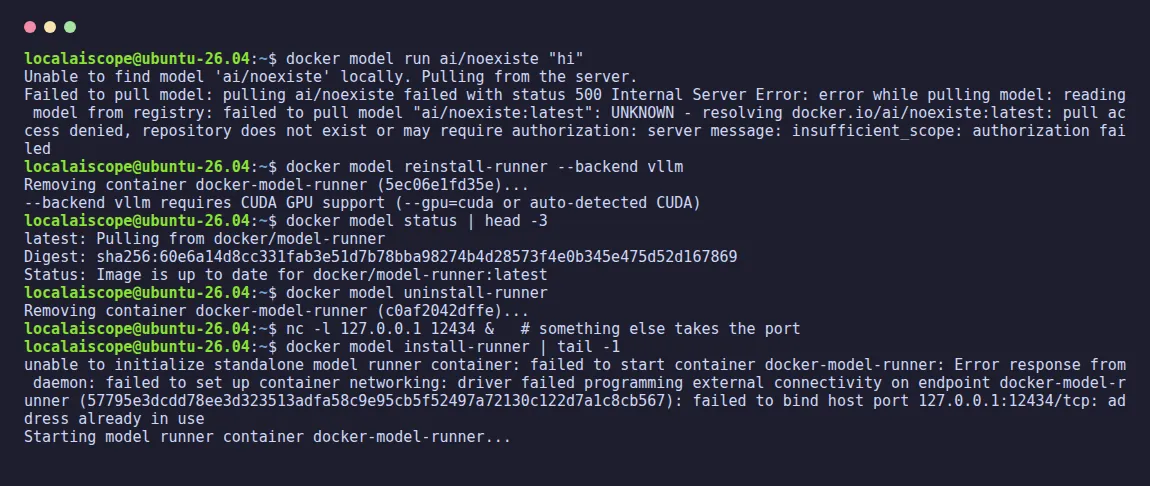
Zwei davon verdienen eine Anmerkung. docker model reinstall-runner --backend vllm entfernt zuerst den Container und scheitert dann: Sie stehen ohne Runner da, bis zum nächsten docker model-Befehl, der ihn von selbst mit dem CPU-Image neu anlegt. Und wenn Sie mit --port 12435 installieren, weil 12434 belegt ist, meldet der Befehl „standalone model runner took too long to initialize“, obwohl der Runner auf 12435 einwandfrei läuft; verirrt hat sich die CLI, die weiter nach 12434 sucht.