Docker Model Runner es la forma que tiene Docker de correr modelos de IA en tu ordenador: un plugin docker model y un contenedor que los ejecuta con llama.cpp y sirve una API compatible con OpenAI y con Ollama en el puerto 12434. En Linux se instala con apt-get install docker-model-plugin; en Mac y Windows se activa en Docker Desktop.
Lo instalamos el 17 de noviembre de 2026, en su versión 1.2.9, en un servidor Linux con Docker Engine 29.9.3, Ubuntu 26.04 y sin tarjeta gráfica (un procesador AMD Ryzen 7 7730U de 16 hilos), y medimos todo lo que pudimos: cuánto tarda, cuánto disco y memoria ocupa, en qué direcciones escucha, qué manda por la red y cómo queda frente a Ollama con el mismo modelo. También lo rompimos a propósito, porque en los mensajes de error es donde más tiempo se pierde. Todo lo que verás aquí se refiere a esa versión y a esa fecha.
Qué es Docker Model Runner (y qué no es)
No es un motor de inferencia nuevo. En la versión 1.2.9, docker model status muestra llama.cpp como único motor en marcha en nuestra máquina, y el resto como no instalados: diffusers, vllm («binary not found»), sglang y mlx («only supported on Apple Silicon»).
 llama.cppFicha del programa
Lo que pone Docker es el envoltorio. Los modelos se bajan como si fueran imágenes, del espacio ai/ de Docker Hub o directamente de Hugging Face con hf.co/…, y se manejan con órdenes que te sonarán si ya usas Docker: pull, run, list, ps, rm. En Linux con Docker Engine, todo eso vive en un contenedor llamado docker-model-runner con un volumen llamado docker-model-runner-models. Si prefieres trabajar con llama.cpp a pelo, nuestra guía para usar llama.cpp en local cuenta ese camino.
Instalar Docker Model Runner en Linux (docker-model-plugin)
En Linux, el plugin sale del repositorio de Docker, el mismo del que viene Docker Engine. Antes de instalarlo, cualquier orden docker model falla con este mensaje:
$ docker model version
docker: unknown command: docker model
La instalación es un solo paquete:
sudo apt-get update
sudo apt-get install docker-model-plugin
En Fedora y el resto de distribuciones RPM es sudo dnf install docker-model-plugin. En nuestro servidor, el apt-get install tardó 4,53 segundos y dejó un único binario de 28 MB en /usr/libexec/docker/cli-plugins/docker-model. Docker no se reinició y ninguno de los contenedores que ya estaban en marcha se enteró.
La instalación de verdad llega la primera vez que lo usas. Nuestro primer docker model run ai/smollm2 "…" tardó 20,53 segundos en total, y en ese tiempo bajó la imagen docker/model-runner:latest (356 MB comprimida, 1,37 GB en disco), creó el volumen de modelos, arrancó el contenedor, bajó el modelo de 270,60 MB y contestó a la pregunta. A partir de ahí, una pregunta con el modelo ya cargado volvía en 0,35 segundos.
Activarlo en Mac y Windows (Docker Desktop)
En Docker Desktop no hay nada que instalar: entra en Settings → AI y marca Enable Docker Model Runner. En Windows con una tarjeta NVIDIA aparece una segunda casilla, Enable GPU-backed inference. Si quieres llamar a la API desde el propio equipo (desde un script o un editor, por ejemplo), marca también Enable host-side TCP support, o lanza docker desktop enable model-runner --tcp 12434.
Los requisitos que pide Docker, que leímos pero aquí no pudimos probar: un Mac con Apple Silicon; en Windows x64, controladores NVIDIA 576.57 o posteriores; en Windows sobre Arm, una gráfica Adreno 6xx o más nueva. En Linux con Docker Engine funciona con CPU, NVIDIA (CUDA, controlador 575.57.08 o posterior), AMD (ROCm) y Vulkan. En Mac y Windows el motor no va en un contenedor como en Linux, sino en un entorno aislado del propio sistema.
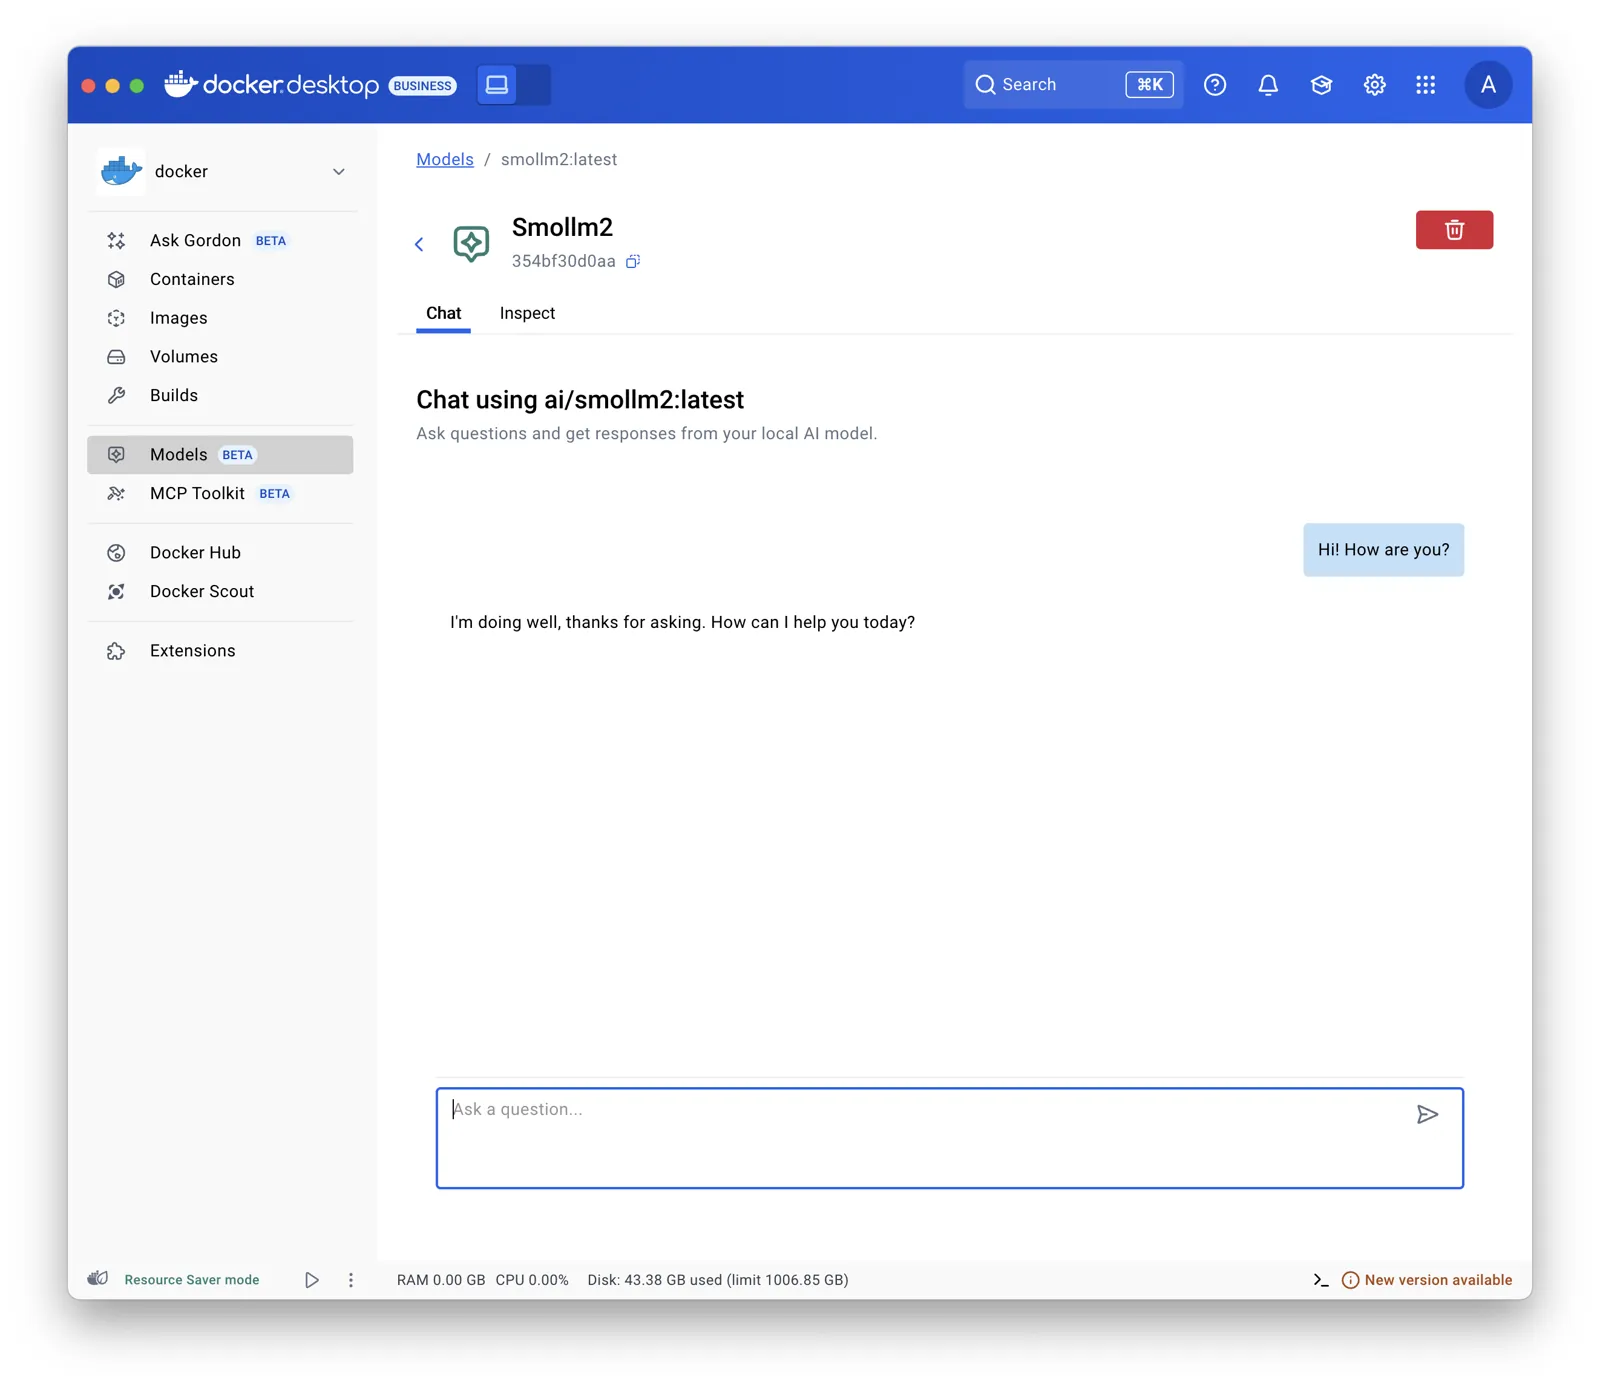
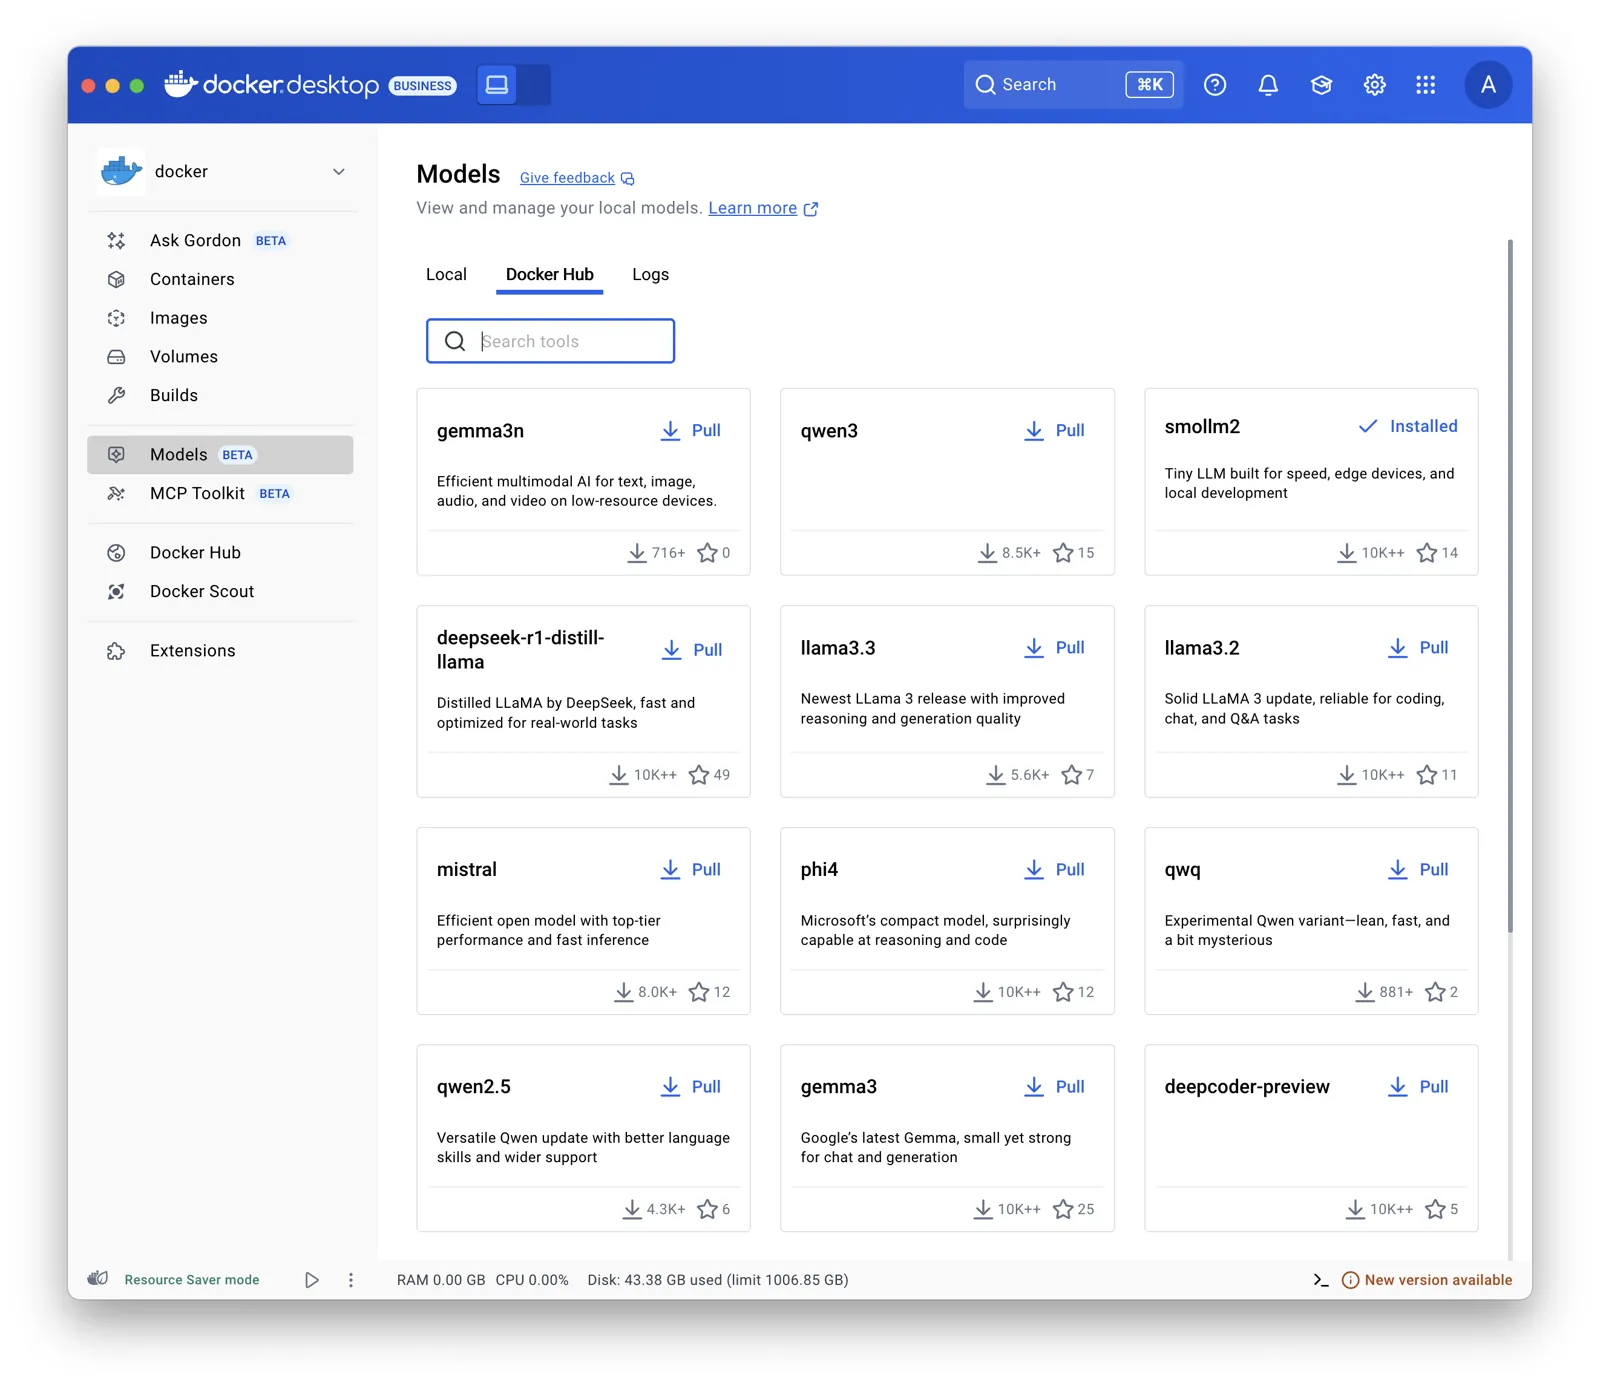
Desktop añade además un apartado Models con el catálogo y un chat para probar cada modelo sin abrir la terminal.
Tu primer modelo: docker model run ai/smollm2
docker model run funciona de dos maneras: con una pregunta entre comillas contesta una vez y te devuelve al prompt; sin ella, abre un chat interactivo (se sale con /bye, según su código). Si el modelo no está, primero lo baja. Elegimos ai/smollm2 (361,82 millones de parámetros, cuantizado en Q4_K_M) porque es diminuto y contesta en menos de un segundo solo con el procesador. A cambio, tiene sus cosas: le pedimos que contara hasta tres y respondió «Three, four, five.». Modelos pequeños, entusiasmo grande.
$ docker model list
MODEL NAME  PARAMETERS  QUANTIZATION    ARCHITECTURE  MODEL ID      CREATED        CONTEXT  SIZE
smollm2     361.82 M    IQ2_XXS/Q4_K_M  llama         354bf30d0aa3  20 months ago           256.35 MiB
docker model ps enseña lo que hay cargado en memoria y hasta cuándo: tras cada uso, nuestro modelo marcaba «4 minutes from now» en la columna UNTIL. Lo dejamos quieto para ver qué pasaba: 5 minutos después de la última pregunta se descargó solo, el proceso del motor desapareció y el contenedor bajó a 8,7 MiB de memoria. docker model unload ai/smollm2 lo descarga al momento sin borrar nada («Unloaded 1 model(s).»), y la siguiente pregunta, con el modelo cargándose desde cero, tardó 0,77 segundos. Para borrarlo del disco, docker model rm ai/smollm2.
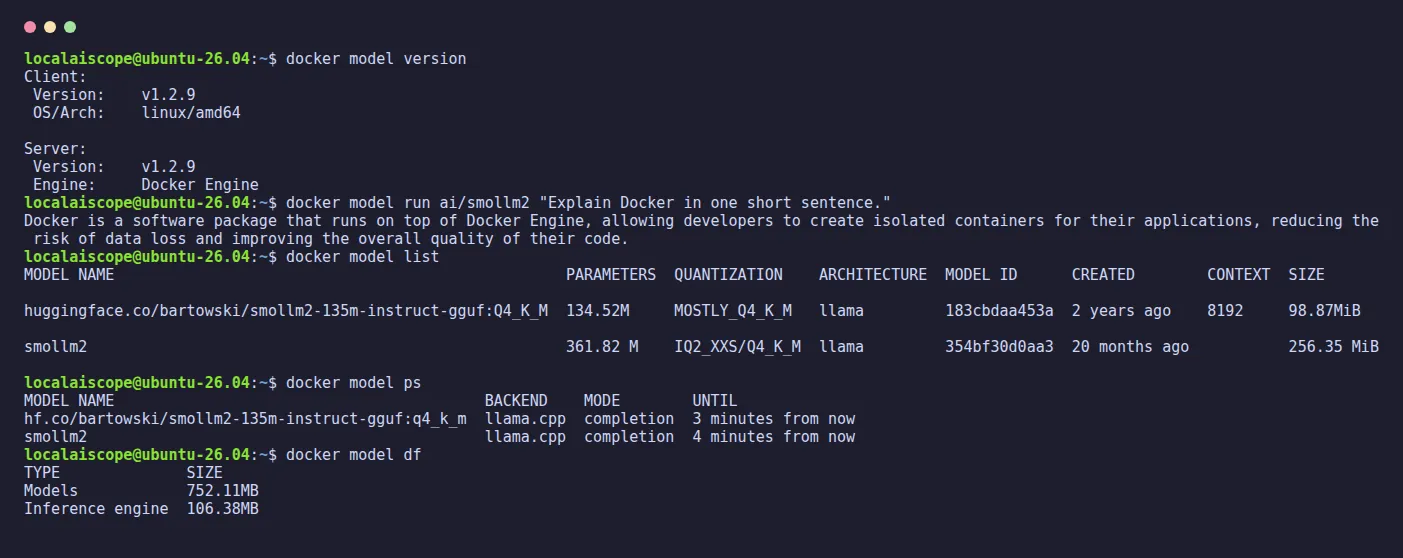
Los modelos de Hugging Face entran con el prefijo hf.co/ y la cuantización como etiqueta. docker model pull hf.co/bartowski/SmolLM2-135M-Instruct-GGUF:Q4_K_M tardó 3,26 segundos para 105,45 MB, aunque el contador de progreso llegó a «Downloaded 210.92MB of 105.45MB»: bajar el doble de lo que pesa un fichero tiene su mérito. Luego, en list, aparece como huggingface.co/bartowski/smollm2-135m-instruct-gguf:Q4_K_M.
La API de Docker Model Runner en el puerto 12434
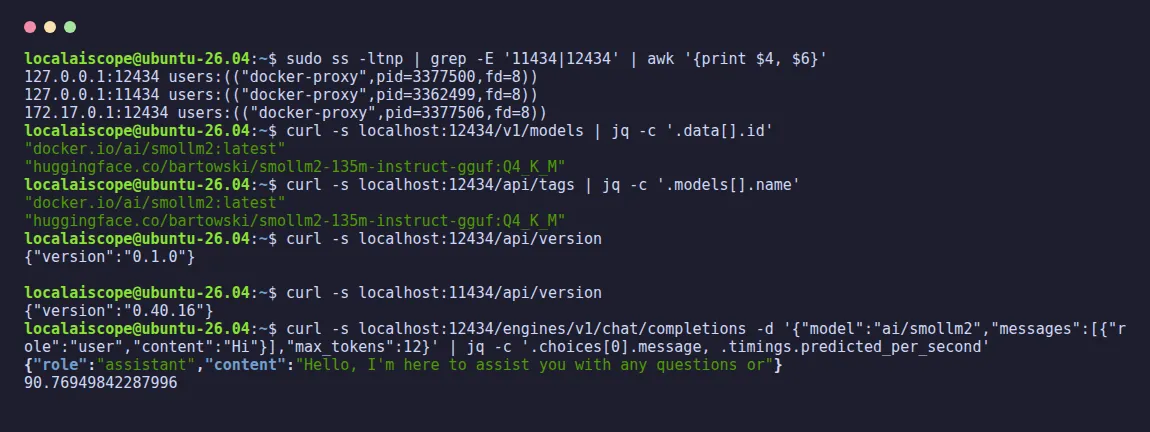
Con Docker Engine, el runner escucha en 127.0.0.1:12434 y en 172.17.0.1:12434 (la dirección del equipo en la red por defecto de Docker). Escucha solo en esas dos direcciones: desde el propio servidor, llamando a su dirección de la red local, la conexión falló. Según Docker, la API no tiene autenticación, así que si un cliente te pide una clave, vale cualquier texto.
El mismo puerto sirve tres familias de rutas, y todas respondieron 200 en nuestra prueba:
| Ruta | Compatible con |
Qué comprobamos |
|---|---|---|
/engines/v1/models, /engines/v1/chat/completions |
OpenAI | Lista de modelos y chat, con usage y tiempos |
/v1/models, /v1/chat/completions |
OpenAI (alias) | La misma respuesta que /engines/v1 |
/api/tags, /api/ps, /api/chat, /api/generate, /api/version |
Ollama | Lista, chatea y genera; versión 0.1.0 |
Una primera petición con curl, que además te dice la velocidad (timings.predicted_per_second):
curl http://localhost:12434/engines/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"ai/smollm2","messages":[{"role":"user","content":"Hola"}]}'
Como usa su propio puerto, convive con Ollama sin ningún choque: tuvimos Ollama en el 11434 y Docker Model Runner en el 12434 a la vez, cada uno respondiendo con su versión. Si vienes de Ollama, nuestra guía de la API de Ollama usa las mismas rutas /api/…, que aquí solo cambian de puerto.
Usarlo desde otros contenedores y con Open WebUI
Desde un contenedor en la red por defecto de Docker, la dirección es http://172.17.0.1:12434. Con Compose puedes darle nombre con extra_hosts: ["model-runner.docker.internal:host-gateway"], que es el nombre que usa Docker Desktop. Sin esa línea, el nombre no existe: wget: bad address 'model-runner.docker.internal:12434'.
En nuestro servidor, eso sí, el primer intento falló con wget: can't connect to remote host (172.17.0.1): Operation timed out. El culpable era ufw, con su regla por defecto de denegar lo entrante: para el cortafuegos, un contenedor que habla con el equipo es tráfico de entrada. Una regla limitada a la interfaz de Docker y a ese puerto lo arregló, tanto por 172.17.0.1 como por model-runner.docker.internal (con la línea host-gateway):
sudo ufw allow in on docker0 to 172.17.0.1 port 12434 proto tcpA juzgar por la API que probamos, Open WebUI se conectaría por la capa compatible con Ollama con OLLAMA_BASE_URL=http://172.17.0.1:12434, o por la de OpenAI con OPENAI_API_BASE_URL=http://172.17.0.1:12434/engines/v1. Esta vez no montamos Open WebUI contra Docker Model Runner; el resto del montaje (volumen, primer usuario, puerto) está en nuestra guía de Open WebUI con Ollama.
Qué manda Docker Model Runner a Docker Hub (y cómo apagarlo)
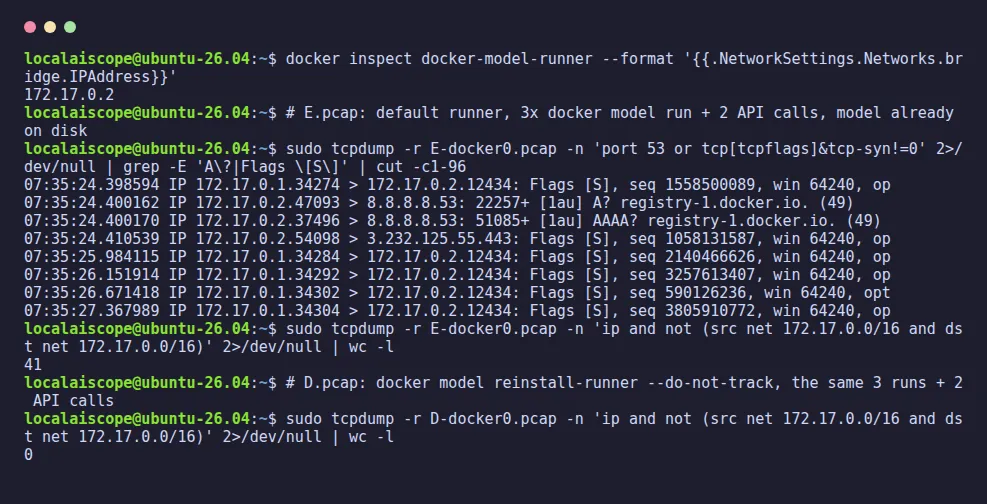
Esta era la prueba que más curiosidad nos daba. Grabamos con tcpdump el tráfico del contenedor del runner en docker0, la red por defecto de Docker, donde en nuestro servidor solo estaba conectado ese contenedor. Con el modelo ya en disco y los ajustes de serie, cada uso del modelo suponía una petición a registry-1.docker.io: en la prueba de control, 3 docker model run y 2 llamadas a la API dieron una consulta DNS, una conexión cifrada con Docker Hub y 5 peticiones, una por uso a juzgar por el tamaño de lo enviado, con 41 paquetes saliendo del ordenador en total. En el código de la versión 1.2.9, esa petición es un HEAD al manifiesto del modelo, que sirve para contar qué modelos se usan.
Después reinstalamos el runner con la opción para no participar:
docker model reinstall-runner --do-not-trackEl contenedor arranca entonces con DO_NOT_TRACK=1 y, con exactamente las mismas 3 ejecuciones y 2 llamadas a la API, salieron del ordenador 0 paquetes IPv4. Los modelos siguen donde estaban: reinstalar el runner no toca el volumen.
--do-not-track Captura: nuestra terminal, Docker Model Runner 1.2.9, 17-11-2026Docker Model Runner vs Ollama: nuestra medición
Mismo modelo (SmolLM2 360M cuantizado en Q4_K_M), mismo prompt (un cuento de unas 200 palabras, 256 tokens, temperatura 0), mismo procesador, los dos en marcha a la vez y el mismo día. Ollama es la versión 0.40.16 en su imagen oficial de Docker; por debajo, los dos usan llama.cpp. Ojo con un detalle: la etiqueta smollm2:360m de Ollama es la versión F16 (725 MB), así que para comparar en igualdad usamos smollm2:360m-instruct-q4_K_M, que pesa lo mismo que la de Docker. En la tabla, DMR es Docker Model Runner.
| 17-11-2026 | DMR 1.2.9 |
Ollama 0.40.16 |
|---|---|---|
| Velocidad (tok/s) | 78-82 | 83-89 |
| Modelo en disco (MB) | 270,6 | 270,6 |
| Imagen en disco (GB) | 1,37 | 8,52 |
| Proceso del motor, RSS (MiB) | 224 | 484 |
| Contenedor, docker stats (MiB) | 95 | 878 |
| Contexto en la prueba | 8.192 | 4.096 |
| Puerto | 12434 | 11434 |
Si lo que estás valorando es Ollama dentro de un contenedor, nuestra guía de Ollama en Docker explica el volumen y el puerto, y para dar servicio a muchos usuarios con una gráfica NVIDIA, la comparativa vLLM vs Ollama es el siguiente paso.
GPU y vLLM: lo que pudimos probar y lo que no
En Linux, según el código de la versión 1.2.9, el runner elige su imagen según la gráfica que detecta: latest-cuda para NVIDIA, latest-rocm para AMD, y la imagen de CPU si no hay ninguna. Puedes forzarlo con --gpu cuda y elegir el motor con --backend vllm, que exige CUDA. En nuestro servidor, que no tiene gráfica NVIDIA, las dos opciones fallaron, y conviene saberlo antes de probar: --gpu cuda bajó la imagen de CUDA (5,66 GB en disco) y solo entonces se rindió, a los 52,87 segundos. No pudimos medir velocidades con GPU; cuando podamos, irán aquí con su fecha.
Se abre en YouTube (sin cookies) solo si pulsas.
Un vídeo en español de mayo de 2025: algunas pantallas y opciones pueden no coincidir con la versión 1.2.9 que probamos nosotros.
Errores de Docker Model Runner, con su mensaje literal
Estos son los mensajes que nos salieron el 17 de noviembre de 2026 con la versión 1.2.9, y qué significa cada uno:
| Mensaje | Causa | Qué hacer |
|---|---|---|
docker: unknown command: docker model |
El plugin no está instalado | sudo apt-get install docker-model-plugin |
pull access denied, repository does not exist or may require authorization (status 500) |
El nombre del modelo no existe | Revisa el nombre en el catálogo ai/ |
failed with status 404 Not Found: Model not found |
El modelo existe, pero esa etiqueta no | Revisa la etiqueta (lo que va tras los dos puntos) |
Failed to remove model: no such model |
rm de un modelo que no tienes |
docker model list para ver el nombre exacto |
failed to bind host port 127.0.0.1:12434/tcp: address already in use |
Otro programa usa el puerto 12434 | Libéralo, o instala con --port |
--backend vllm requires CUDA GPU support |
vLLM sin gráfica NVIDIA | Vuelve al motor por defecto (llama.cpp) |
failed to discover GPU vendor from CDI: no known GPU vendor found |
--gpu cuda sin gráfica NVIDIA |
Instala sin --gpu |
dial tcp 127.0.0.1:12434: connect: connection refused |
El CLI busca el runner en el 12434 y está en otro puerto | Apunta MODEL_RUNNER_HOST al puerto correcto |
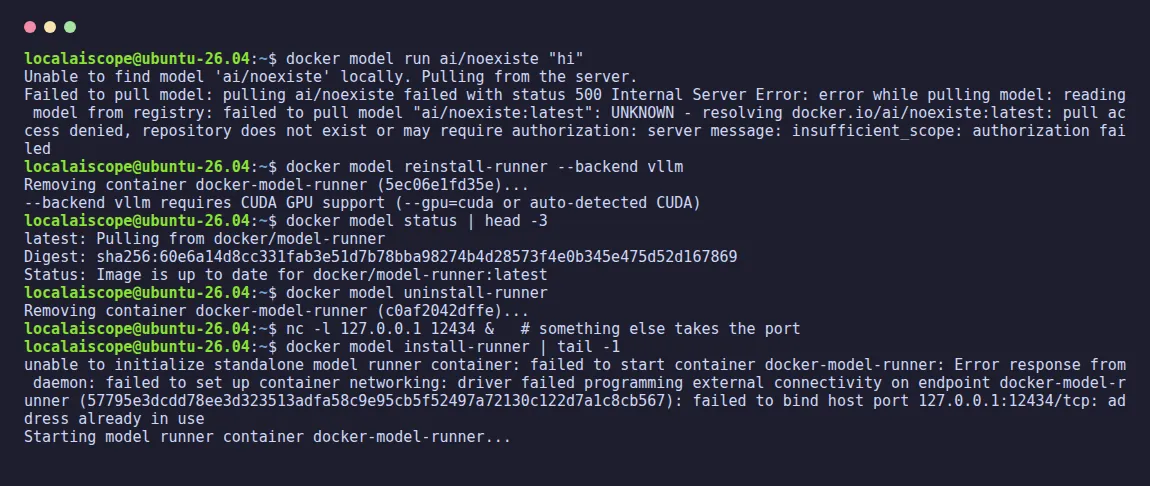
Dos de ellos merecen una nota. docker model reinstall-runner --backend vllm primero borra el contenedor y después falla: te quedas sin runner hasta la siguiente orden docker model, que lo vuelve a crear sola con la imagen de CPU. Y si instalas con --port 12435 porque el 12434 está ocupado, la orden escribe «standalone model runner took too long to initialize», pero el runner funciona bien en el 12435; el que se pierde es el CLI, que sigue buscando el 12434.