Les commandes Ollama du quotidien sont ollama pull (télécharger un modèle), ollama list (voir ceux que vous avez), ollama run (discuter), ollama ps et ollama stop (ce qui est en mémoire), ollama rm (supprimer), ollama cp et ollama create (copies et modèles maison via un Modelfile). Les voici avec leur sortie réelle.
Nous avons lancé chaque commande de cet aide-mémoire le 14 novembre 2026 avec Ollama 0.40.16, la dernière version stable à cette date, dans Docker avec l’image officielle ollama/ollama:0.40.16, sur un serveur sans carte graphique (un processeur AMD Ryzen 7 7730U). Comme cobaye, nous avons pris l’un des plus petits modèles du catalogue, smollm2:135m, pour que tout réponde en quelques secondes. Les blocs de sortie sont copiés tels quels depuis notre terminal, erreurs comprises : quand l’un de ces messages s’affichera chez vous, vous saurez exactement où vous en êtes.
 OllamaFiche logiciel
Toutes les commandes Ollama dans un tableau
ollama --help dans la v0.40.16 liste 15 commandes, au 14 novembre 2026. Voici celles qui comptent pour faire tourner des modèles chez soi :
| Commande | À quoi elle sert | Exemple |
|---|---|---|
pull |
Télécharge un modèle du catalogue | ollama pull smollm2:135m |
list |
Liste les modèles téléchargés | ollama list |
run |
Charge un modèle et discute avec lui | ollama run smollm2:135m |
ps |
Affiche les modèles chargés en mémoire | ollama ps |
stop |
Décharge un modèle de la mémoire | ollama stop smollm2:135m |
show |
Montre la fiche et le Modelfile d’un modèle | ollama show smollm2:135m --modelfile |
create |
Crée un modèle à partir d’un Modelfile | ollama create pirate -f Modelfile |
cp |
Copie un modèle sous un autre nom | ollama cp smollm2:135m mon-smollm2 |
rm |
Supprime un modèle | ollama rm mon-smollm2 |
serve |
Démarre le serveur Ollama | ollama serve |
Le reste : push (envoyer un modèle vers un registre), signin et signout (votre compte ollama.com), launch (le menu d’Ollama et ses intégrations) et help. Avec -v, vous obtenez la version : ollama version is 0.40.16. Et si Ollama n’est pas encore installé, notre guide pour démarrer Ollama en local vous y amène en quelques minutes.
ollama pull et ollama list : télécharger des modèles et voir ce que vous avez
ollama pull télécharge un modèle par son nom et son étiquette (ce qui suit les deux-points). Le 14/11/2026, avec la v0.40.16, notre modèle de 270 Mo est arrivé en 9,1 secondes, la barre de progression montant jusqu’à 60 Mo/s. Relancer le même pull a pris 0,8 seconde, puisque le modèle était déjà là : il a seulement vérifié l’empreinte, réécrit le manifeste et affiché removing unused layers.
$ ollama list
NAME            ID              SIZE      MODIFIED
smollm2:135m    9077fe9d2ae1    270 MB    1 second ago
ollama list compte quatre colonnes dans la v0.40.16 (14/11/2026) : nom, ID, taille et date de modification. L’ID correspond au début de l’empreinte sha256 du manifeste du modèle, d’où le même ID pour deux noms qui partagent un manifeste (vous le verrez avec cp). La taille est en mégaoctets décimaux : du -h nous a donné 259M pour le dossier des modèles (270 902 687 octets, presque tout dans le fichier de poids), tout simplement parce que du compte en mébioctets. Rien ne manque.
« Error: pull model manifest: file does not exist »
Dans la v0.40.16 (14/11/2026), c’est l’erreur d’un nom absent du catalogue, mais aussi d’une étiquette inexistante pour un modèle qui, lui, existe : nous l’avons obtenue avec modelo-que-no-existe comme avec smollm2:999m.
$ ollama pull smollm2:999m
Error: pull model manifest: file does not exist
ollama run sur un modèle absent tente d’abord de le télécharger : une faute de frappe dans run vous vaut donc exactement le même message. Vérifiez l’orthographe et l’étiquette sur la page du modèle dans le catalogue. Les autres commandes se plaignent autrement quand le modèle manque, et mieux vaut reconnaître chaque formule :
$ ollama rm no-existe
Error: model 'no-existe' not found
$ ollama stop no-existe
Error: couldn't find model "no-existe" to stop
$ ollama cp no-existe:latest otro
Error: model "no-existe:latest" not found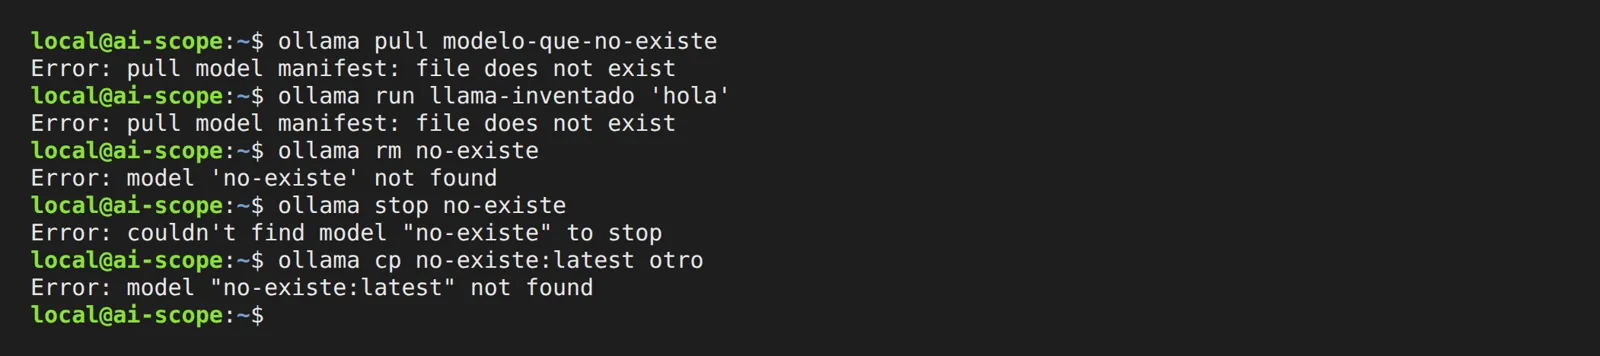
Pour les messages du serveur, du GPU ou du réseau, notre liste des erreurs d’Ollama avec leur texte exact prend le relais.
ollama run, ps et stop : ce qui est en mémoire et combien cela pèse
ollama run modèle ouvre une discussion interactive (on en sort avec /bye), et ollama run modèle "question" répond une fois puis vous rend la main. Ajoutez --verbose pour voir les temps. Nous lui avons demandé de dire bonjour en trois mots :
$ ollama run smollm2:135m "Say hi in 3 words" --verbose
Sammy!
total duration:       846.099538ms
load duration:        779.473469ms
prompt eval count:    36 token(s)
prompt eval duration: 36.411ms
prompt eval rate:     988.71 tokens/s
eval count:           4 token(s)
eval duration:        27.433ms
eval rate:            145.81 tokens/s
Un mot au lieu de trois, et un prénom que personne n’avait demandé : 135 millions de paramètres, on ne peut pas tout exiger. L’intérêt est dans les chiffres : sur les 846 millisecondes, 779 ont servi à charger le modèle, et la réponse est sortie à 145,81 tokens par seconde avec ce seul processeur (v0.40.16, 14/11/2026).
ollama ps montre ce qui reste chargé. Dans la v0.40.16 (14/11/2026), il affiche sept colonnes : nom, ID, taille en mémoire, processeur, contexte, moteur et délai avant déchargement.
$ ollama ps
NAME            ID              SIZE      PROCESSOR    CONTEXT    RUNNER      UNTIL
smollm2:135m    9077fe9d2ae1    383 MB    100% CPU     4096       llamacpp    4 minutes from now
Ces « 4 minutes from now » viennent des 5 minutes pendant lesquelles le modèle reste chargé par défaut après votre dernier message (la variable OLLAMA_KEEP_ALIVE). ollama stop smollm2:135m le décharge immédiatement, sans rien supprimer : ps revient vide et le modèle reste dans list. Si vous arrêtez un modèle téléchargé mais pas chargé, la v0.40.16 ne dit rien et ne renvoie aucune erreur.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Cette vidéo, en anglais, suit un parcours proche : lancer des modèles depuis le terminal, en ajouter d’autres, l’API HTTP et, pour finir, personnaliser un modèle.
ollama show et le Modelfile : FROM, PARAMETER num_ctx et SYSTEM
ollama show smollm2:135m affiche la fiche du modèle : architecture (llama), paramètres (134.52M), contexte maximal (8192), quantification (F16) et capacités. Avec --modelfile, il imprime la recette complète, et avec --parameters, seulement les paramètres. Cette recette est un Modelfile, et vous pouvez écrire la vôtre :
FROM smollm2:135m
PARAMETER num_ctx 8192
PARAMETER temperature 0.2
SYSTEM """You are a pirate. Answer in one short sentence."""
FROM indique le modèle de départ (un nom ou un fichier GGUF), PARAMETER fixe des options comme le contexte (num_ctx) ou la température, et SYSTEM définit les instructions par défaut. Ensuite :
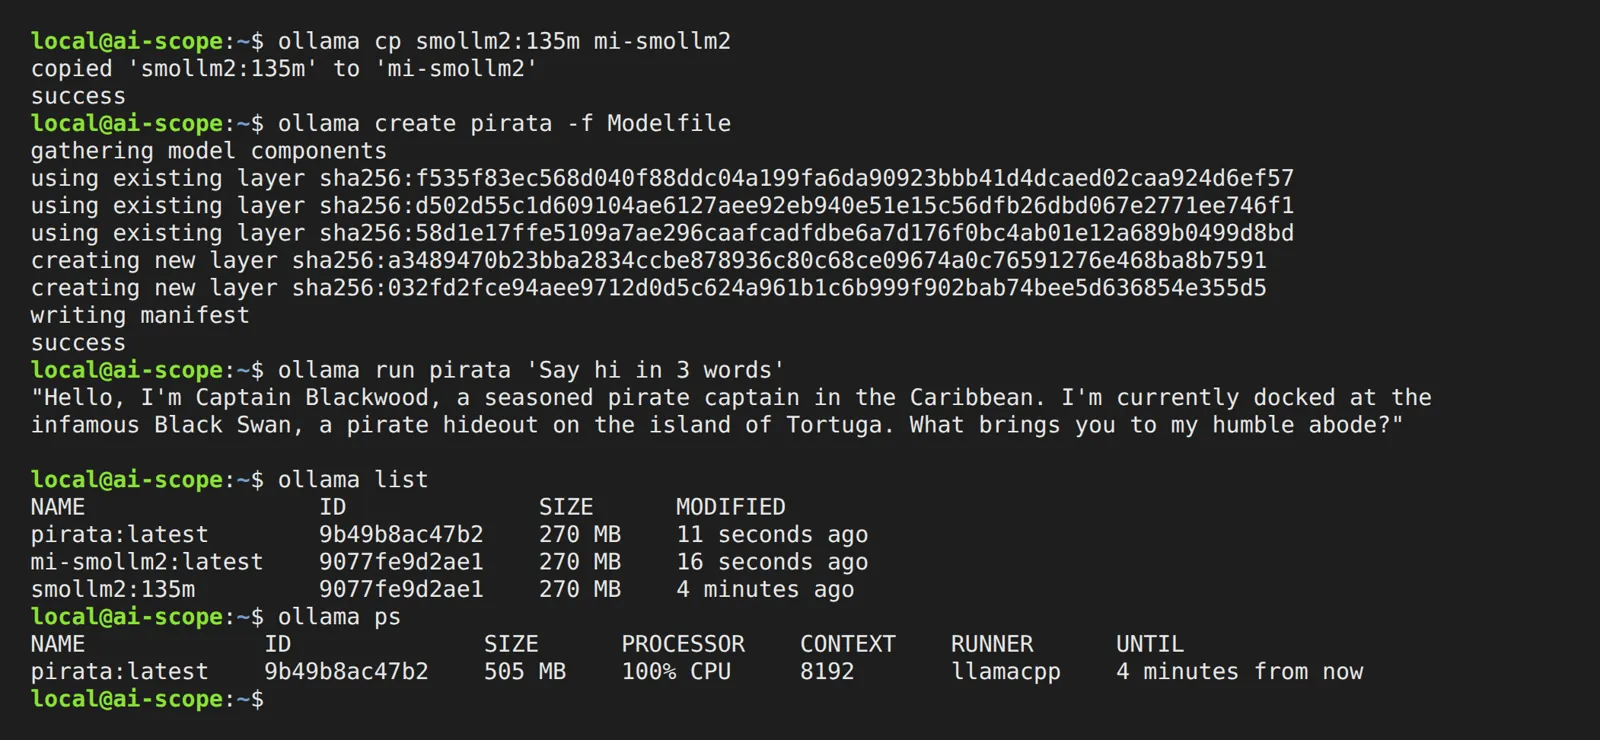
$ ollama create pirata -f Modelfile
gathering model components
using existing layer sha256:f535f83ec568…
using existing layer sha256:d502d55c1d60…
using existing layer sha256:58d1e17ffe51…
creating new layer sha256:a3489470b23b…
creating new layer sha256:032fd2fce94a…
writing manifest
success
(Nous avons raccourci les empreintes.) Avec la v0.40.16, il a fallu 0,19 seconde : les trois couches existantes (dont celle des poids) sont réutilisées, seules les nouveautés sont écrites. Si le fichier du dossier courant s’appelle Modelfile, ollama create nom suffit, sans -f ; nous l’avons vérifié. Notre pirate, au passage, a ignoré la consigne « une phrase courte » pour se présenter comme le capitaine Blackwood, à quai à Tortuga. La ligne SYSTEM fonctionne ; la discipline à 135M, c’est une autre affaire.
Si vous voulez seulement plus de contexte, notre guide sur la longueur de contexte dans Ollama détaille toutes les façons de la changer et ce qu’elle coûte en mémoire.
« Error: unknown parameter », « command must be one of » et « no FROM line » : un Modelfile mal écrit
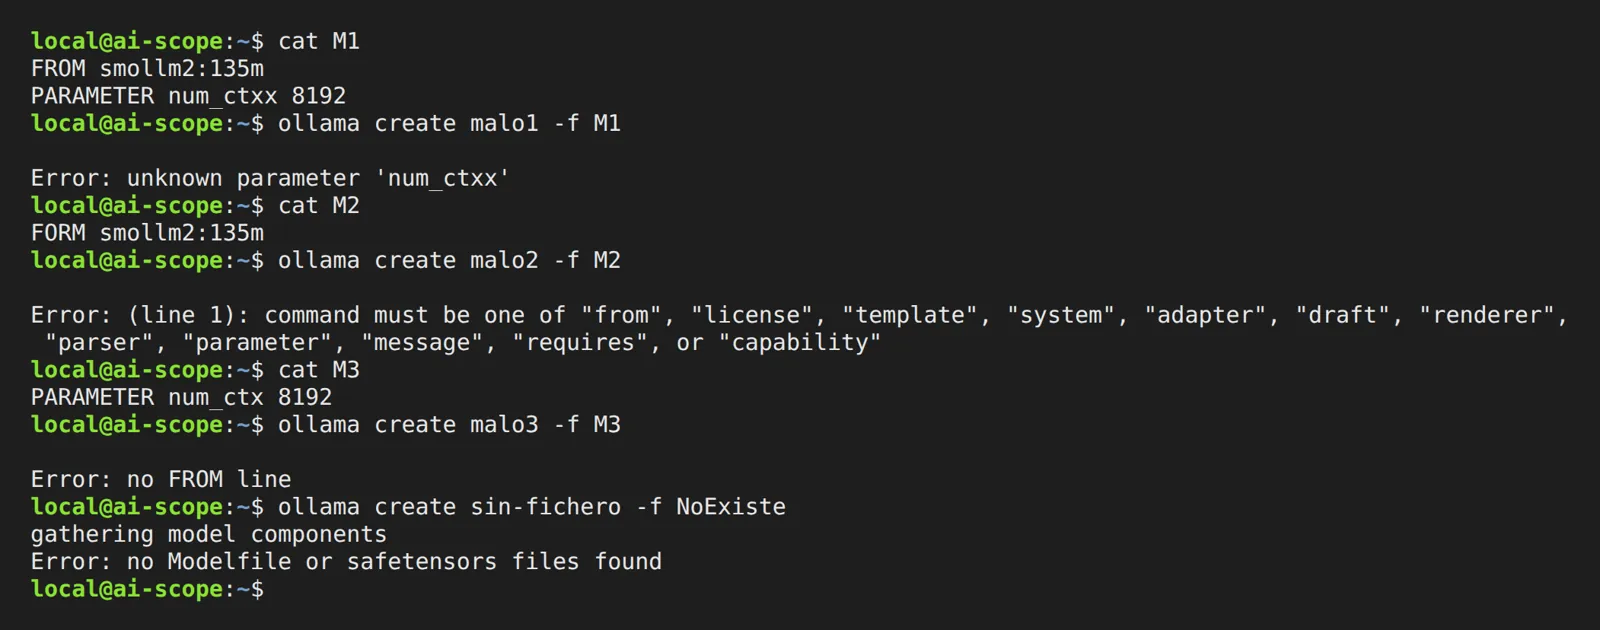
Nous avons cassé le Modelfile exprès, une erreur à la fois. Voici les messages exacts d’ollama create dans la v0.40.16 :
| Erreur dans le Modelfile | Message |
|---|---|
PARAMETER num_ctxx 8192 (faute dans le nom) |
Error: unknown parameter 'num_ctxx' |
PARAMETER num_ctx ocho (pas un nombre) |
Error: invalid int value [ocho] |
FORM smollm2:135m (instruction mal orthographiée) |
Error: (line 1): command must be one of "from", "license", "template", "system", "adapter", "draft", "renderer", "parser", "parameter", "message", "requires", or "capability" |
Pas de ligne FROM |
Error: no FROM line |
FROM no-existe:1b |
Error: pull model manifest: file does not exist |
FROM ./no-hay.gguf (fichier absent) |
Error: 400 Bad Request: invalid model name |
-f vers un fichier qui n’existe pas |
Error: no Modelfile or safetensors files found |
Le piège, c’est le GGUF absent : le message ne parle pas de « fichier introuvable » mais d’« invalid model name ». Vérifiez le chemin par rapport au dossier depuis lequel vous lancez create.
ollama cp et ollama rm : une copie qui pèse 89 octets
ollama cp smollm2:135m mon-smollm2 a pris 0,15 seconde, et voici le plus beau : le dossier des modèles a grossi de 89 octets. Le 14/11/2026, avec Ollama 0.40.16, la copie est un lien symbolique vers le même manifeste : ollama list affiche les deux noms avec le même ID et 270 Mo chacun, mais ces 270 Mo ne sont qu’une fois sur le disque.
Lors de notre test du 14/11 avec la v0.40.16, ollama rm a accepté plusieurs noms d’un coup (ollama rm pirata desde-gguf a supprimé les deux) et n’a libéré un fichier que lorsque plus aucun modèle ne l’utilisait : supprimer la copie a libéré ses 89 octets en laissant les 270 Mo en place, puisque l’original pointait toujours dessus. Quand le dernier modèle qui les utilise disparaît, l’espace revient aussitôt, sans étape supplémentaire.
Importer un GGUF dans Ollama : FROM ./modele.gguf
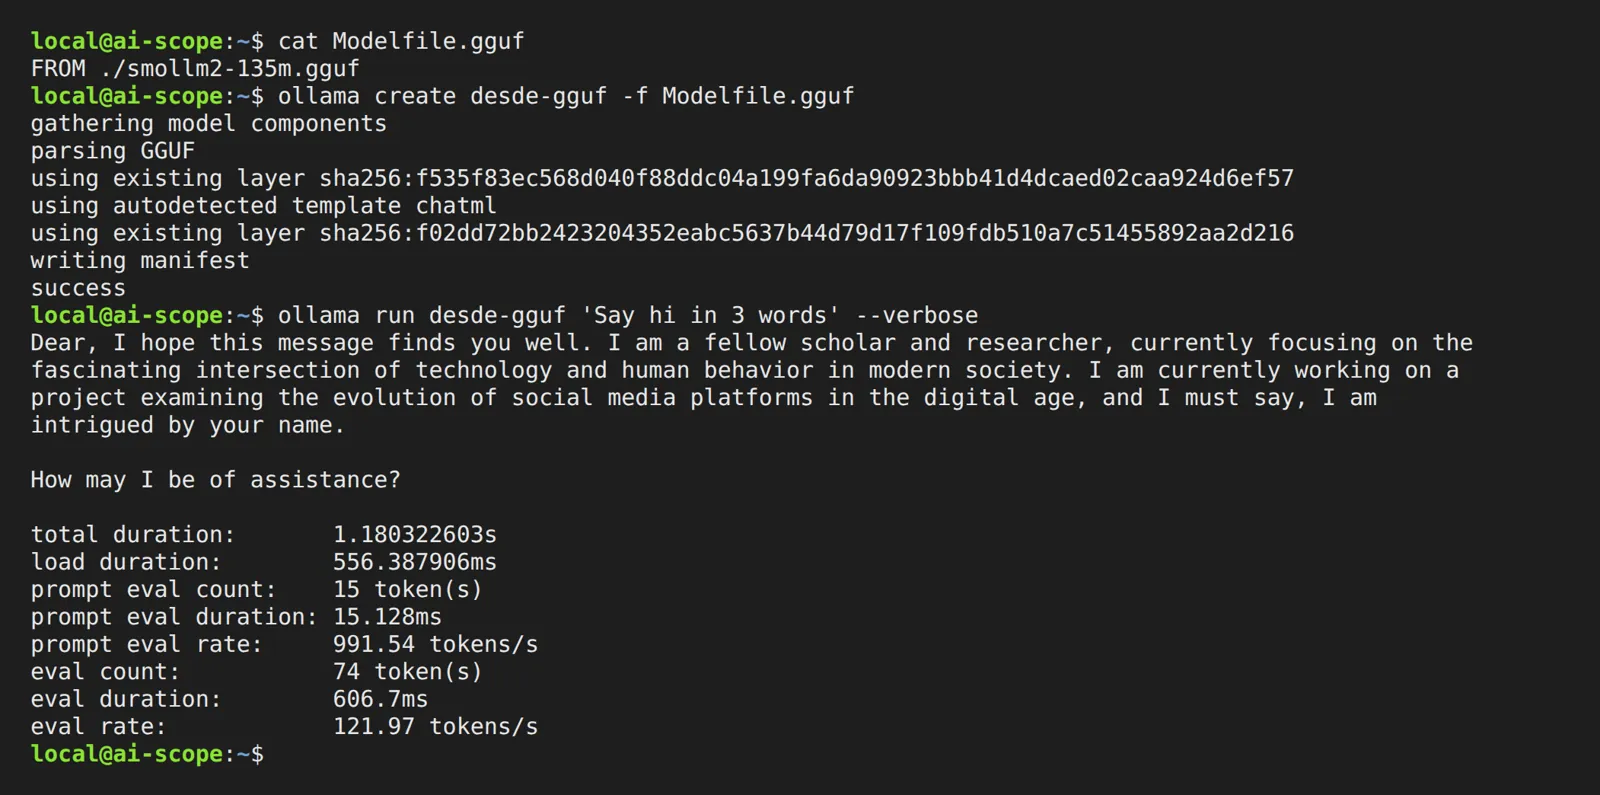
Si vous avez déjà un modèle dans un fichier GGUF, un Modelfile d’une seule ligne suffit :
FROM ./smollm2-135m.gguf$ ollama create desde-gguf -f Modelfile.gguf
copying file sha256:f535f83ec568… 100%
parsing GGUF
using existing layer sha256:f535f83ec568…
using autodetected template chatml
creating new layer sha256:f02dd72bb242…
writing manifest
successLors de ce passage, avec un dossier des modèles vide au départ, Ollama 0.40.16 a détecté seul le gabarit de conversation (chatml), réutilisé les poids qu’il venait de copier et a rendu le modèle prêt en 0,6 seconde pour 270 Mo. Ce « copying file » est à prendre au pied de la lettre : le 14/11/2026, nous avons vérifié que le résultat est une copie distincte dans le dossier des modèles (un autre inode que votre fichier), donc tant que vous gardez l’original, l’espace est occupé deux fois. Nous avons supprimé le .gguf d’origine : le modèle restait dans ollama list et démarrait toujours. D’après sa documentation, Ollama ne quantifie pas à l’import : le fichier entre tel quel.
Où Ollama stocke les modèles et comment les déplacer avec OLLAMA_MODELS
D’après la documentation de la v0.40.16, les modèles se trouvent ici :
- Linux (installateur et service) :
/usr/share/ollama/.ollama/models - macOS :
~/.ollama/models - Windows :
C:\Users\%username%\.ollama\models - Docker (image officielle, mesuré) :
/root/.ollama/models, le dossier où l’on monte le volume
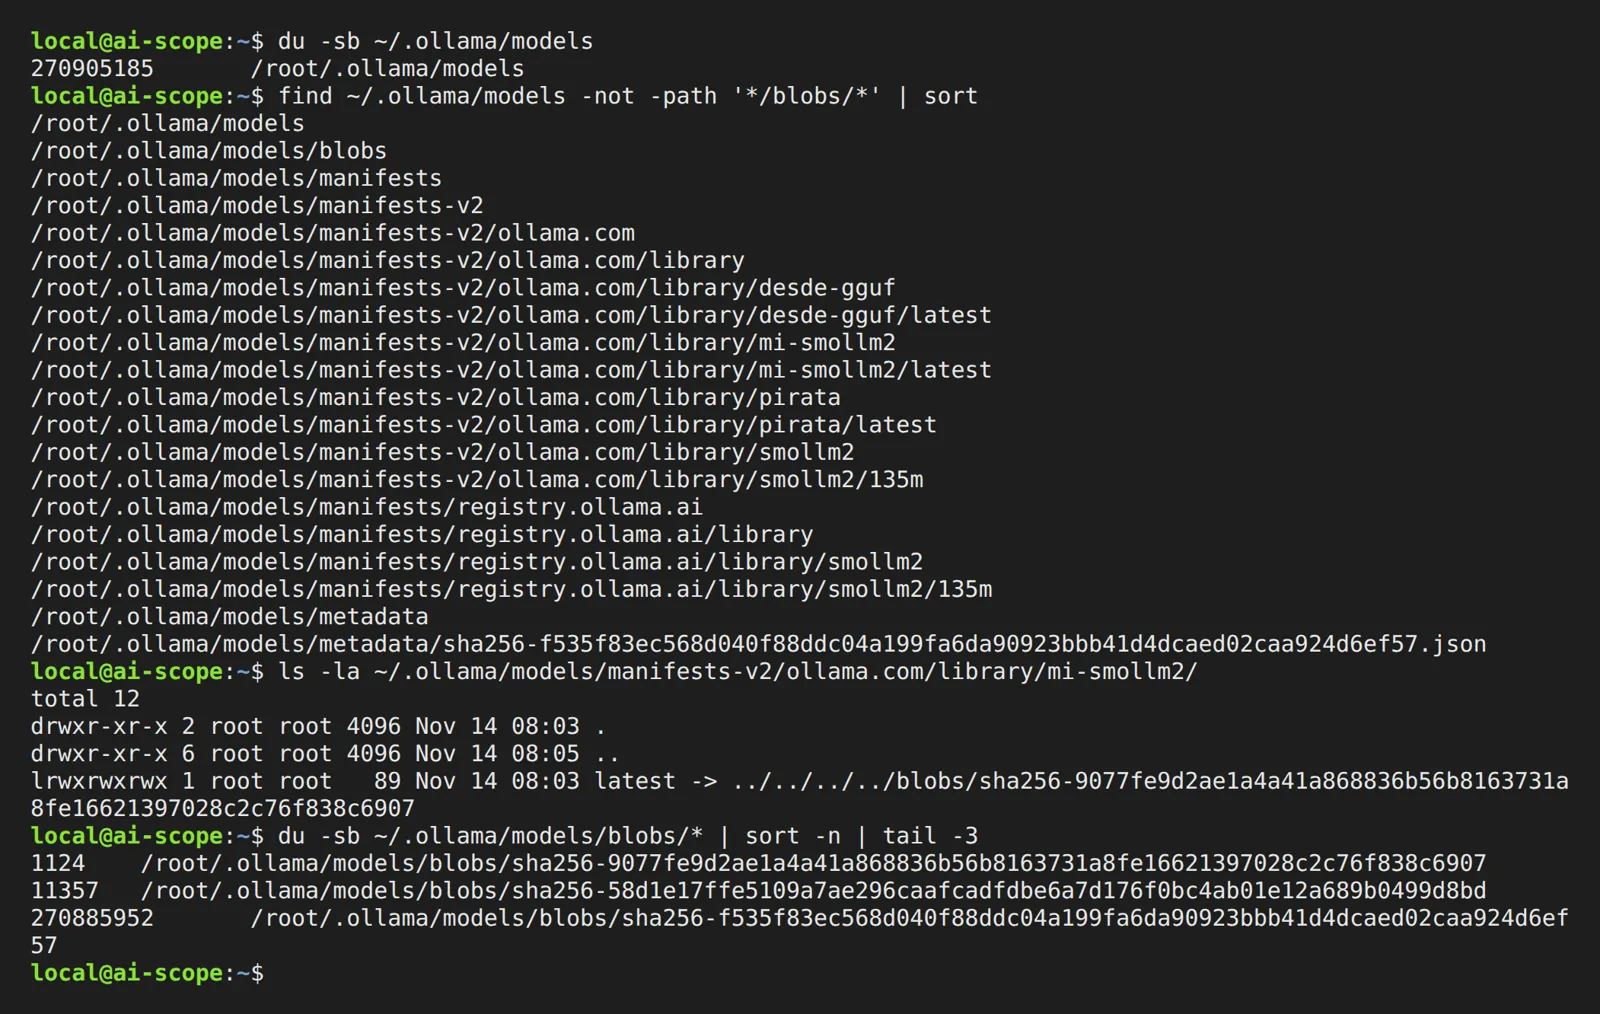
À l’intérieur, le 14/11/2026 avec la v0.40.16, nous avons trouvé quatre dossiers : blobs/ (les poids et chaque couche, nommés d’après leur empreinte sha256), manifests/ (le manifeste de chaque modèle téléchargé, sous registry.ollama.ai/library/), manifests-v2/ (des liens symboliques sous ollama.com/library/, y compris ceux des copies faites avec cp) et metadata/ (un JSON nommé d’après l’empreinte des poids, qui commence par "ollama_version":"0.40.16"). Tout l’espace est dans blobs/ : le fichier de poids faisait 270 885 952 octets et tout le reste réuni moins de 17 Ko.
Pour les ranger ailleurs (un second disque, par exemple), définissez la variable OLLAMA_MODELS côté serveur, pas dans votre terminal. Sous Linux avec le service : sudo systemctl edit ollama.service, ajoutez Environment="OLLAMA_MODELS=/donnees/ollama" sous [Service], confiez le dossier à l’utilisateur du service avec sudo chown -R ollama:ollama /donnees/ollama, puis systemctl daemon-reload et systemctl restart ollama. Sous macOS, launchctl setenv OLLAMA_MODELS /chemin puis redémarrez l’application. Sous Windows, une variable d’environnement utilisateur, puis redémarrez Ollama.
Nous avons testé le déménagement : un serveur avec OLLAMA_MODELS pointant vers un dossier vide affichait un ollama list vide ; nous avons copié le contenu de models/ avec cp -a (259M), redémarré, et le modèle est réapparu. Copiez avec cp -a, comme nous, ou avec rsync -a : les deux conservent les liens symboliques, et dans la v0.40.16 ces liens sont relatifs, donc ils survivent au déplacement. Si un jour vous retirez Ollama, notre guide pour désinstaller Ollama traite aussi ce dossier, car les modèles sont la partie la plus lourde de ce qu’il laisse.
ollama serve : « address already in use » et « could not connect to ollama server »
ollama serve démarre le serveur auquel parlent toutes les autres commandes. Dans une installation normale, il tourne déjà comme service ou comme application, et le relancer donne ceci (v0.40.16, 14/11/2026, dans notre conteneur, qui écoute sur 0.0.0.0) :
$ ollama serve
Error: listen tcp 0.0.0.0:11434: bind: address already in use
Ce n’est pas une panne : le second serveur trouve le port déjà pris par le premier. Le cas inverse, c’est un client sans serveur, et le message vous dit quoi faire :
$ ollama list
Error: could not connect to ollama server, run 'ollama serve' to start it
Nous l’avons aussi obtenu avec OLLAMA_HOST pointant vers un port où rien n’écoutait : si le serveur tourne et que le message apparaît quand même, vérifiez cette variable. ollama serve --help liste toutes les variables du serveur, d’OLLAMA_HOST à OLLAMA_MODELS. Pour parler au serveur depuis votre propre code, l’API d’Ollama est celle qu’utilisent ces commandes ; et pour tout faire tourner dans un conteneur, Ollama dans Docker.