GGUF est le format de modèle en un seul fichier que lisent llama.cpp, Ollama et LM Studio. Le Q4_K_M, Q5_K_M ou Q8_0 du nom, c’est la quantification : les bits gardés par poids. Q4_K_M est le choix courant : dans notre test, il pesait 59 % de Q8_0 et choisissait le même token suivant que l’original 89 % du temps.
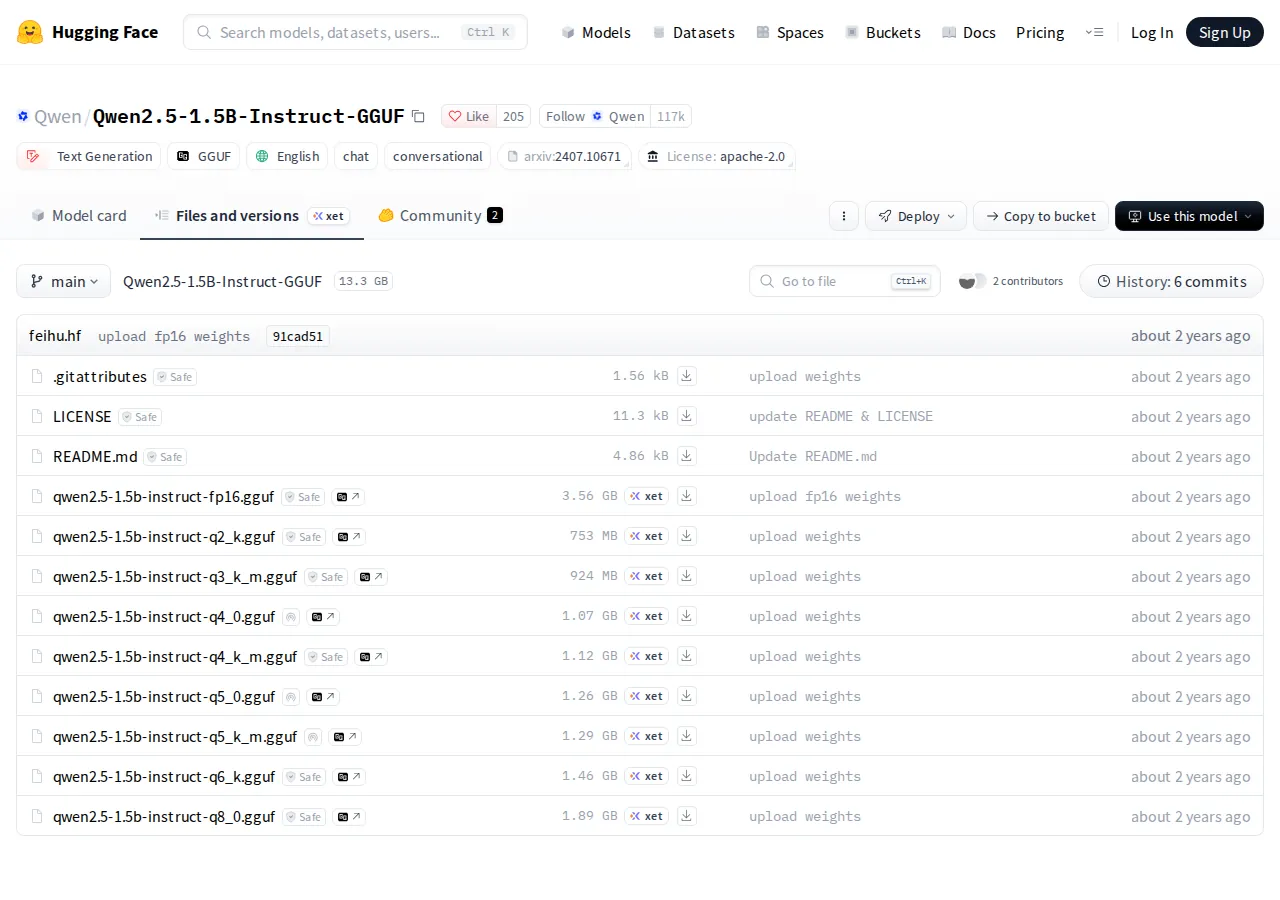
Le 18 novembre 2026, nous avons téléchargé les GGUF officiels de Qwen2.5 1.5B Instruct en 6 versions (de F16 à Q3_K_M) et nous les avons passés dans llama.cpp (build b12500) sur un serveur Linux sans carte graphique, avec un processeur AMD Ryzen 7 7730U sur 8 threads. Nous avons mesuré le poids de chaque fichier, sa vitesse d’écriture et la fréquence à laquelle son choix du token suivant diffère de celui du modèle non quantifié. Ensuite, nous avons fait passer les 28 modèles de notre trouveur de modèle par le calcul qu’utilise l’outil, pour voir ce qui tient dans 8, 12, 16, 24 et 32 Go à chaque niveau. Tout ce qui suit indique d’où vient le chiffre.
Ce qu’est le GGUF, et ce que veut dire Q4_K_M dans le nom du fichier
Un fichier GGUF contient tout ce dont un modèle a besoin pour tourner, d’un seul bloc : les poids, le tokenizer, l’architecture et, en général, le modèle de conversation. C’est pour cela que vous pouvez télécharger un seul fichier et l’ouvrir directement dans llama.cpp, LM Studio ou Ollama. Le format est né dans le projet llama.cpp, et ces 3 programmes le lisent parce qu’ils s’appuient sur llama.cpp et sa bibliothèque ggml.
 llama.cppFiche logiciel
La quantification, c’est la compression. Un modèle non quantifié stocke chaque poids sur 16 ou 32 bits ; un fichier quantifié le stocke sur moins, par blocs qui partagent une même échelle. Le nom vous dit comment :
- Le chiffre (Q3, Q4, Q5, Q6, Q8) donne les bits de base par poids.
- Le K désigne la famille des « k-quants », qui travaille par blocs regroupés en super-blocs. Q8_0 et Q4_0 appartiennent à l’ancienne famille, plus simple.
- Le _S, _M ou _L indique le mélange : petit, moyen ou grand. Ce n’est pas la taille du modèle, mais le nombre de tenseurs gardés à une précision plus élevée.
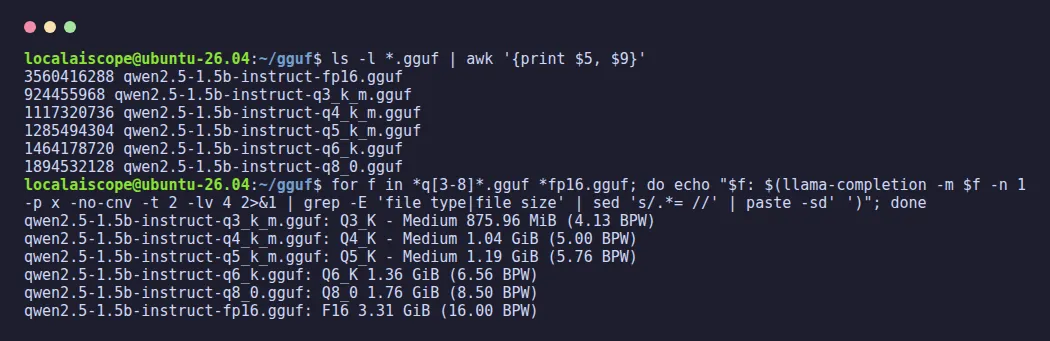
Ce dernier point, nous l’avons vérifié en ouvrant les fichiers. Notre Q4_K_M compte 169 tenseurs sur 4 bits (q4_K) et 29 sur 6 bits (q6_K) ; Q5_K_M a la même répartition 169/29 avec 5 bits de base ; Q6_K et Q8_0 utilisent un seul type pour les 198 tenseurs quantifiés. Choisir Q4_K_M, ce n’est donc pas choisir « tout en 4 bits » : c’est choisir 4 bits avec les parties les plus sensibles protégées. C’est aussi pour cela que llama.cpp annonce 5,00 bits par poids pour ce Q4_K_M, et non 4.
Si vous hésitez entre GGUF et les fichiers safetensors d’origine, ceux que chargent vLLM et transformers, cette comparaison se trouve dans notre guide vLLM vs Ollama, et sur Mac dans MLX vs GGUF.
Les niveaux de quantification GGUF : combien pèse chacun
La règle générale tient : moins de bits, fichier plus petit. Mais la descente n’est pas linéaire, à cause des tenseurs protégés et des parties qui ne sont jamais compressées. Voici les 6 fichiers que nous avons mesurés, tous issus du dépôt officiel de Qwen :
| Niveau | Fichier (Mo) |
Bits par poids |
vs Q8_0 |
|---|---|---|---|
| F16 | 3 560 | 16,00 | 188 % |
| Q8_0 | 1 895 | 8,50 | 100 % |
| Q6_K | 1 464 | 6,56 | 77 % |
| Q5_K_M | 1 285 | 5,76 | 68 % |
| Q4_K_M | 1 117 | 5,00 | 59 % |
| Q3_K_M | 924 | 4,13 | 49 % |
Ce modèle est petit et son vocabulaire compte à lui seul 151 936 tokens : c’est probablement pour cela que ses niveaux sont si proches. Sur des modèles plus gros, l’échelle s’ouvre : parmi les modèles de notre catalogue qui publient les deux fichiers, Q4_K_M pèse en moyenne 62 % de Q8_0, Q5_K_M 72 % et Q6_K 82 %. Pour Qwen3 8B, cela donne 8,11 Gio en Q8_0, 6,26 en Q6_K, 5,45 en Q5_K_M, 4,68 en Q4_K_M et 3,84 en Q3_K_M.
Q4_K_M vs Q5_K_M vs Q8_0 : combien de qualité vous perdez
Comment mesurer ce que perd un fichier compressé ? Avec la méthode intégrée à llama.cpp. D’abord, le modèle F16 a lu 10 240 tokens de texte de Wikipédia en anglais (le jeu de test wikitext-2, 20 blocs de 512 tokens) et nous avons enregistré, à chaque position, la probabilité qu’il donnait à chaque token suivant possible. Ensuite, chaque fichier quantifié a lu exactement le même texte et llama-perplexity les a comparés. Deux chiffres comptent : la fréquence à laquelle le token préféré du modèle quantifié est le même que celui de l’original, et la hausse de sa perplexité (PPL) (à quel point le vrai texte le surprend ; plus elle est basse, mieux c’est).
| Niveau | Même premier choix (%) |
PPL vs F16 (%) |
KLD moy. |
|---|---|---|---|
| Q8_0 | 97,7 | +0,3 | 0,0015 |
| Q6_K | 93,6 | +1,2 | 0,011 |
| Q5_K_M | 91,8 | +1,2 | 0,017 |
| Q4_K_M | 89,0 | +5,6 | 0,042 |
| Q3_K_M | 82,2 | +13,4 | 0,117 |
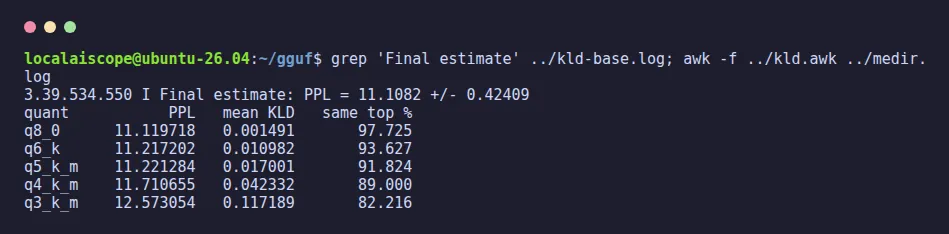
Q8_0 est pratiquement impossible à distinguer de l’original : le même premier choix pour 97,7 % des tokens et 0,3 % de perplexité en plus. Q6_K et Q5_K_M coûtent autant en perplexité (+1,2 %), même si Q5_K_M s’écarte un peu plus souvent dans son premier choix. Q4_K_M est la première vraie marche : +5,6 % de perplexité et un premier choix différent pour environ 1 token sur 9. Cela ne veut pas dire 1 mot faux sur 9 : un premier choix différent n’est pas forcément un mauvais choix. Q3_K_M, c’est là que ça commence à faire mal : plus du double de la perte de perplexité de Q4_K_M et presque 3 fois son écart (la colonne KLD).
Une limite, en toute honnêteté : il s’agit d’1 modèle de 1,5 milliard de paramètres, mesuré sur 1 texte en anglais. Nous n’avons pas mesuré de modèles plus gros de cette façon, donc nous ne leur donnons pas de chiffre.
Vitesse : le petit fichier écrit aussi plus vite
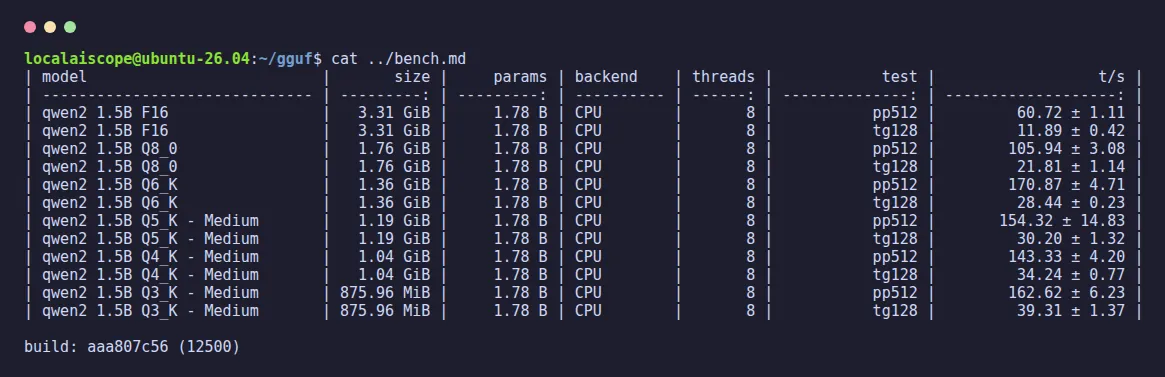
Sur un ordinateur sans carte graphique, écrire chaque token oblige à relire tout le modèle en mémoire : un fichier plus léger donne donc plus de tokens par seconde. Notre test avec llama-bench (128 tokens écrits et un prompt de 512 tokens lu, 3 répétitions, 8 threads) le confirme. Pour une fois, le régime rend plus rapide :
| CPU 18/11/2026 |
Écrit (tok/s) |
Lit (tok/s) |
|---|---|---|
| F16 | 11,9 | 61 |
| Q8_0 | 21,8 | 106 |
| Q6_K | 28,4 | 171 |
| Q5_K_M | 30,2 | 154 |
| Q4_K_M | 34,2 | 143 |
| Q3_K_M | 39,3 | 163 |
La vitesse d’écriture monte bien dans l’ordre à mesure que le fichier rétrécit : Q4_K_M écrit 57 % plus vite que Q8_0 sur le même processeur. La lecture du prompt ne suit pas cet ordre : là, le travail relève surtout du calcul et non de la mémoire, et dépend donc de la façon dont chaque format se décompresse sur ce processeur. Une réserve : le serveur faisait tourner d’autres tâches en même temps, si bien que de petits écarts, comme Q6_K face à Q5_K_M, restent dans le bruit. Nous n’avons pas mesuré sur carte graphique.
Ce qui tient dans 8, 12, 16, 24 et 32 Go avec chaque quantification
C’est ici que la quantification fait ses preuves. Nous avons compté, avec le calcul qu’utilise notre trouveur de modèle (poids + le vrai cache KV du modèle + une marge pour le programme, avec un contexte de 8 192 tokens), combien de nos 28 modèles tiennent dans chaque mémoire selon le niveau téléchargé :
| Mémoire | Q8_0 | Q5_K |
Q4_K |
Q3_K |
|---|---|---|---|---|
| 8 Go | 3 | 5 | 7 | 8 |
| 12 Go | 7 | 8 | 9 | 9 |
| 16 Go | 9 | 10 | 10 | 12 |
| 24 Go | 10 | 16 | 18 | 18 |
| 32 Go | 14 | 18 | 20 | 18 |
Les machines sont celles de notre catalogue : un PC avec RTX 4060 (8 Go), un autre avec RTX 3060 (12 Go), un Mac avec M4 (16 Go), une station de travail avec RTX 4090 (24 Go) et un Mac mini avec M6 (32 Go). Q6_K, sorti du tableau faute de place, se situe entre les deux : 3, 8, 9, 14 et 17 modèles. Comment la lire : avec 8 Go de VRAM, passer de Q8_0 à Q4_K_M vous fait passer de 3 modèles à 7. Avec 24 Go, de 10 à 18. La colonne Q3_K_M ne grandit pas toujours, parce que tous les modèles ne publient pas ce niveau : 23 de nos 28 l’ont, contre 26 pour Q4_K_M. La mémoire comptée est celle qui reste pour le modèle : 0,8 Gio de moins sur une carte graphique pour le bureau, 3 Gio de moins sur un Mac ou en RAM pour le système. Autre détail : la colonne Q3_K_M compte ce qui tient, mais le trouveur montre à part tout ce qui descend sous Q4_K_M au lieu de le compter.
Un exemple concret : Qwen3 8B demande 9,99 Gio en Q8_0 avec ce contexte, ce qui ne tient pas sur la RTX 4060 (7,2 Gio disponibles), et 6,56 Gio en Q4_K_M, ce qui tient. Le contexte coûte aussi de la mémoire ; si vous êtes juste, notre guide sur la longueur de contexte indique ce que coûte chaque palier.
Comment télécharger une quantification précise
Sur Hugging Face, les dépôts officiels proposent en général un fichier par niveau, et les 3 grands programmes vous laissent choisir :
- llama.cpp : le niveau se met après deux-points.
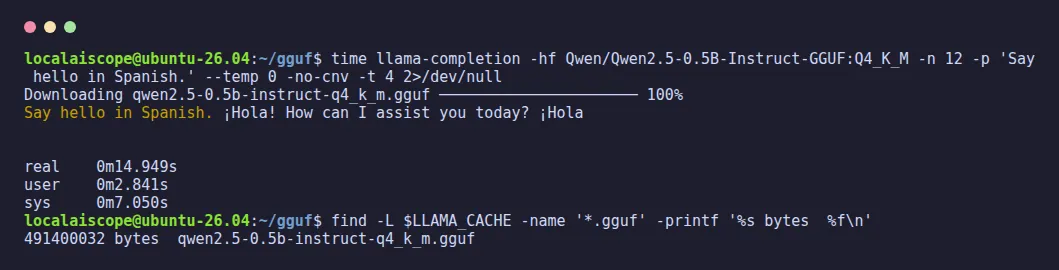
llama-completion -hf Qwen/Qwen2.5-0.5B-Instruct-GGUF:Q4_K_Ma téléchargé le fichier de 491 400 032 octets et a répondu en 14,9 secondes, téléchargement compris, dans notre test, alors que le nom du fichier est écrit en minuscules. Prié en anglais de dire bonjour en espagnol, il a répondu « ¡Hola! », puis, sans qu’on lui demande rien, il est passé à l’anglais pour proposer son aide : bilingue, oui, obéissant, moins. llama-server accepte la même option-hf. - Ollama : avec un modèle de Hugging Face, le même principe :
ollama run hf.co/utilisateur/depot:Q4_K_M(une voie que nous n’avons pas testée cette fois). Pour charger un GGUF déjà présent sur le disque,FROM ./modele.ggufdans un Modelfile, comme nous l’expliquons dans notre guide des commandes Ollama. - LM Studio : au téléchargement, il affiche les fichiers du dépôt avec leur taille et vous en choisissez un (nous ne l’avons pas testé cette fois). S’il se plaint avec « no LM runtime found for model format ‘gguf’ », la solution est dans LM Studio ne fonctionne pas.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez.
Une vidéo en anglais de 12 minutes sur l’échelle Q8, Q6, Q5 et Q4, publiée en octobre 2025.
Quelle quantification GGUF télécharger
- Le modèle tient largement : Q5_K_M ou Q6_K. Vous ne perdez presque rien par rapport à Q8_0 et il vous reste de la mémoire pour le contexte.
- Le cas courant : Q4_K_M. C’est le niveau que notre trouveur prend comme référence, celui qui fait passer de 3 à 7 modèles sur une carte de 8 Go, et dans notre mesure il a fait le même premier choix que l’original pour 89 % des tokens.
- De la mémoire à revendre, ou vous mesurez : Q8_0, qui est quasiment le modèle d’origine pour moitié moins de place que F16.
- Il ne tient pas en Q4_K_M : avant de descendre en Q3_K_M, essayez un modèle plus petit de la même famille en Q4_K_M ou plus. En dessous de Q4_K_M, notre trouveur vous montre le modèle à part au lieu de le compter comme un modèle qui tient.
Si vous préférez ne pas faire les calculs vous-même, le trouveur de modèle les fait pour votre machine, modèle par modèle, avec les mêmes chiffres que cette page.