llama-server est le serveur HTTP de llama.cpp : llama-server -m modele.gguf sert une API compatible OpenAI et une page de chat sur 127.0.0.1:9931 (8080 en v0.6.0 et avant). Par défaut, il ouvre 4 slots qui se partagent le contexte fixé par -c. Ajoutez -np, --api-key et --host seulement si vous en avez besoin.
Nous aimons llama-server parce qu’il ne cache rien : chaque requête, chaque slot et chaque token sont visibles, à condition de savoir où regarder. Le 11 novembre 2026, nous avons donc pris la version stable de llama.cpp, la v0.9.0 (build b12110, publiée le 4 novembre 2026), lancé son llama-server pour Linux dans un conteneur sans réseau avec un tout petit modèle de 135 millions de paramètres, SmolLM2 en Q4_K_M, et nous lui avons tout demandé : quel port, quels points d’accès, comment -c et -np se partagent le contexte, et ce qu’il répond quand quelque chose coince. Chaque message cité ici est celui que nous avons reçu, mot pour mot. Quand nous avons seulement lu le code de la v0.9.0, nous l’indiquons. Le 15 novembre 2026, nous avons refait tous les tests avec la v1.0.0 (build b12359, publiée le 13 novembre 2026) : mêmes codes d’état, mêmes messages et mêmes chiffres de mémoire, plus une ligne de sécurité au lancement, expliquée plus bas.
 llama.cppFiche logiciel
Lancer llama-server : la commande, le port et l’adresse
Le plus court, c’est un fichier de modèle :
llama-server -m ./SmolLM2-135M-Instruct-Q4_K_M.ggufou un modèle de Hugging Face, avec -hf et le nom du dépôt. Le nouveau programme unique llama fait la même chose avec llama serve ; cette page utilise llama-server, toujours inclus dans le build Linux officiel que nous avons testé. Avec la v0.9.0 le 11 novembre 2026, puis avec la v1.0.0 le 15 novembre, notre journal s’est terminé par listening on http://127.0.0.1:9931, et le seul socket ouvert était 127.0.0.1 sur le port 9931. Le port 8080 n’a pas répondu du tout. Si un vieux tutoriel vous envoie sur le 8080, c’est le port de la v0.6.0 et des versions antérieures : --port 8080 le rétablit.
Les images Docker du projet font exception : dans les Dockerfile de la v0.9.0 et de la v1.0.0, nous avons lu qu’elles fixent LLAMA_ARG_HOST=0.0.0.0 et LLAMA_ARG_PORT=8080. Dans un conteneur, le serveur écoute donc sur le 8080, sur toutes les interfaces.
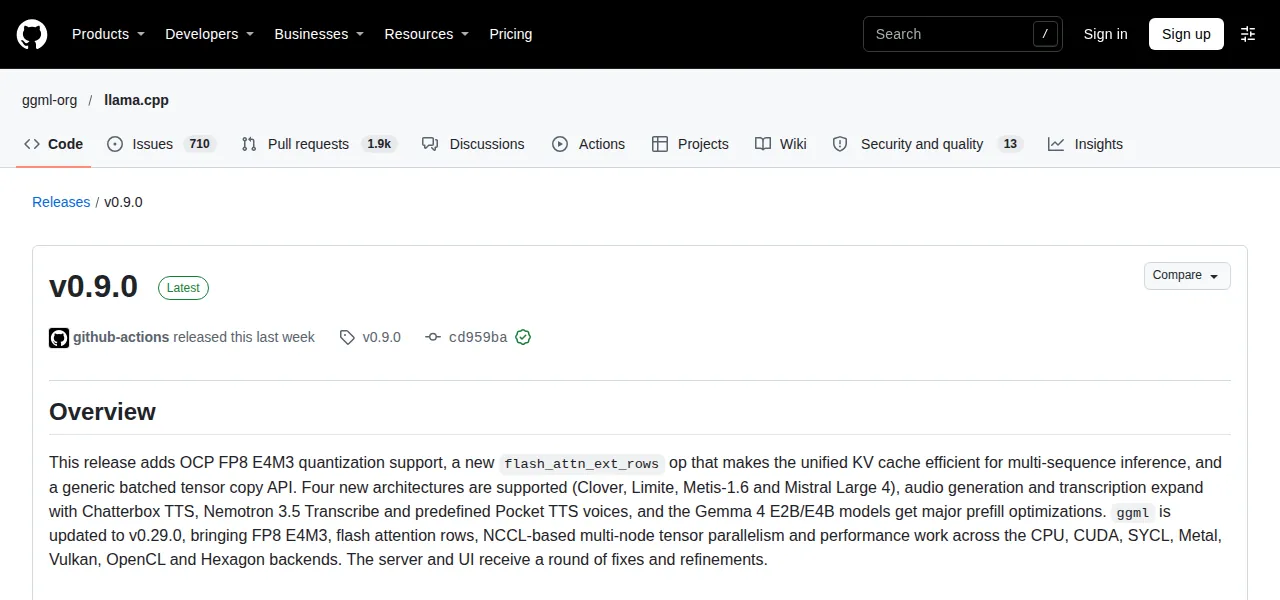
0.9.0-dev (build 12110, commit cd959bae9) affiché par llama-server --version Capture : GitHub, ggml-org/llama.cpp, 11-11-2026Les points d’accès utiles, et ce que répond chacun
llama-server parle le dialecte d’OpenAI : la plupart des clients n’ont besoin que de l’URL de base http://127.0.0.1:9931/v1. Voici les points d’accès que nous avons appelés, avec le code renvoyé par chacun sur un lancement par défaut :
| Point d’accès | À quoi il sert | Lancement par défaut (v0.9.0 et v1.0.0) |
|---|---|---|
GET /health |
le serveur est-il prêt ? | 503 pendant le chargement, puis 200 {"status":"ok"} |
GET /v1/models |
le modèle servi, façon OpenAI | 200 |
POST /v1/chat/completions |
le chat, façon OpenAI | 200 |
GET /slots |
chaque slot et son contexte | 200 |
GET /props |
réglages : slots, modèle de chat, ce qui est activé | 200 |
GET /metrics |
compteurs pour Prometheus | 501 tant que --metrics manque |
GET / |
la page de chat | 200 dans un navigateur |
Un détail de /v1/models : l’id du modèle est le chemin passé à -m, ici /models/SmolLM2-135M-Instruct-Q4_K_M.gguf. Lancez avec --alias smollm2 et l’id devient smollm2, bien plus pratique pour les clients qui vous demandent de taper un nom de modèle. La réponse donne aussi le contexte d’entraînement (n_ctx_train, 8 192 ici) et la taille, utiles pour vérifier quel fichier est réellement chargé. Et chaque réponse de chat contient un bloc timings et un system_fingerprint avec le build, b12110-cd959bae9 dans la v0.9.0 et b12359-b1b770d90 dans la v1.0.0.
« Loading model » : le 503 de /health
Juste après le lancement, /health répond 503 avec {"error":{"message":"Loading model","type":"unavailable_error","code":503}}. Ce n’est pas une panne : le modèle se charge encore. Le nôtre a mis 0,28 seconde, et nous l’avons tout de même surpris 5 fois de suite avant le premier 200 ; avec un modèle de plusieurs gigaoctets, l’attente est plus longue. Un script doit attendre le 200 avant d’envoyer du travail.
« This server does not support metrics endpoint. Start it with `--metrics` »
C’est le 501 renvoyé par /metrics sur un lancement par défaut. Avec --metrics, il renvoie des compteurs Prometheus comme llamacpp:prompt_tokens_total, llamacpp:tokens_predicted_total et llamacpp:n_tokens_max.
« Error: gzip is not supported by this browser »
Nous avons testé la page de chat avec un simple curl http://127.0.0.1:9931/ et reçu un 415 avec ce texte. La page est stockée compressée, et curl, sans option, n’annonce pas qu’il accepte gzip. Un navigateur le fait, et curl --compressed obtient un 200 normal. Rien n’est cassé.
-c et -np : comment llama-server partage le contexte entre les slots
C’est là que naissent la plupart des surprises. Un slot est une place pour une conversation ; -np (ou --parallel) en fixe le nombre, et -c (ou --ctx-size) le nombre total de tokens de mémoire que le serveur réserve. Voici ce qu’a dit le journal, ligne n_slots / n_ctx_slot / kv_unified, pour chaque lancement avec notre modèle de 8 192 tokens :
| Vous lancez avec | Slots | Contexte par slot | Réserve partagée ? | Cache KV réservé (RAM, build CPU) |
|---|---|---|---|---|
| rien (par défaut) | 4 | 8 192 | oui, 8 192 pour les 4 | 180 Mio |
-np 4 |
4 | 8 192 | non : 4 × 8 192 | 720 Mio |
-c 4096 -np 4 |
4 | 1 024 | non | 90 Mio |
-c 4096 -np 4 -kvu |
4 | 4 096 | oui, 4 096 pour les 4 | non affiché |
-c 16384 -np 4 |
4 | 4 096 | non | 360 Mio |
-np 1 |
1 | 8 192 | non | 180 Mio |
Mesuré avec llama.cpp v0.9.0 le 11 novembre 2026 et avec la v1.0.0 le 15 novembre 2026 (mêmes chiffres), SmolLM2-135M en Q4_K_M ; mémoire d’après la ligne KV buffer size du journal. Un modèle plus gros demande beaucoup plus de mémoire par token.
Trois règles en découlent. Sans option, llama-server choisit 4 slots et un cache unifié (nous l’avons lu dans tools/server/server.cpp, lignes 126 à 130 dans la v0.9.0 et 129 à 133 dans la v1.0.0) : une seule réserve de tokens où puisent toutes les conversations, si bien qu’un long échange peut l’occuper entièrement. Écrivez vous-même -np 4 et la réserve cesse d’être partagée : chaque slot reçoit le contexte complet, et le cache a pris 4 fois plus de mémoire, 720 Mio au lieu de 180. Avec -c et -np, enfin, -c est divisé : 4 096 pour 4 slots laisse 1 024 tokens à chacun, et le journal prévient, très poliment, n_ctx_seq (1024) < n_ctx_train (8192) -- the full capacity of the model will not be utilized. -kvu (--kv-unified) rétablit la réserve partagée.
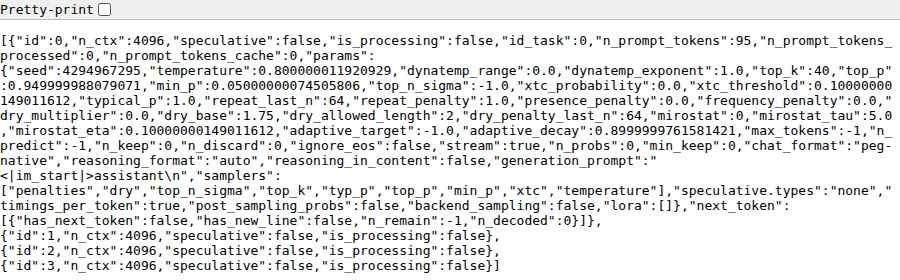
-c 4096 et sans -np : 4 slots, chacun pouvant utiliser les 4 096 tokens de la réserve partagée Capture : llama-server v0.9.0 (localaiscope.com), 11-11-2026Plusieurs slots servent au vrai travail en parallèle. Avec -np 1, nous avons envoyé 2 requêtes en même temps : l’une a fini en 1,18 s, l’autre a attendu son tour et a mis 2,18 s. Avec -np 2, les deux ont fini en 1,33 s. Si vous êtes seul à l’utiliser, 1 slot avec tout le contexte est le choix raisonnable ; avec -np écrit à la main, chaque slot de plus réserve son propre cache (dans notre test, en RAM ; nous n’avons pas mesuré de carte graphique). La mémoire qu’occupent le modèle et son contexte sur votre carte, c’est ce que calcule notre trouveur de modèle, à 8 192 tokens.
« request (931 tokens) exceeds the available context size (256 tokens), try increasing it »
C’est l’erreur exacte obtenue quand un prompt ne tenait pas dans son slot. Nous avons lancé -c 512 -np 2 (256 tokens par slot) et envoyé 931 tokens. Réponse : un 400.
{"error":{"code":400,"message":"request (931 tokens) exceeds the available context size (256 tokens), try increasing it","type":"exceed_context_size_error","n_prompt_tokens":931,"n_ctx":256}}Le nombre entre parenthèses est le contexte d’un slot, pas le -c que vous avez tapé. S’il est plus petit que prévu, divisez votre -c par vos slots : vous tenez le coupable. Les remèdes, dans l’ordre : retirez -np (ou mettez -np 1), ajoutez -kvu pour que les slots partagent la réserve, ou augmentez -c.
L’autre limite est plus discrète. Avec le même serveur, un prompt court, max_tokens à 400 et ignore_eos (pour que le modèle ne puisse pas s’arrêter de lui-même), la génération s’est arrêtée à 256 tokens au total (35 de prompt, 221 de réponse), avec finish_reason: "length" et un 200 ; le journal indiquait truncated = 1. Aucune erreur : la réponse est simplement coupée là où finit le slot, car le décalage de contexte est désactivé par défaut en v0.9.0 comme en v1.0.0 (lu dans common/common.h, ligne 580 en v0.9.0, 592 en v1.0.0). Si les réponses s’arrêtent au milieu d’une phrase, regardez finish_reason avant d’accuser le modèle.
--host, --port et --api-key : « Invalid API Key »
--host 0.0.0.0 --port 8080 a fait ce qu’il annonce : le journal affichait listening on http://0.0.0.0:8080 et le socket était ouvert sur toutes les interfaces. Avant de faire cela sur un portable qui sort de chez vous, ajoutez une clé. Avec --api-key (ou la variable LLAMA_API_KEY, pour ne pas la taper sur la ligne de commande), une requête sans clé, ou avec une autre, a reçu un 401 :
{"error":{"message":"Invalid API Key","type":"authentication_error","code":401}}Envoyez-la sous la forme Authorization: Bearer votre-cle, comme le font les clients OpenAI ; le code de la v0.9.0 l’accepte aussi dans un en-tête X-Api-Key. Deux choses que la clé ne couvre pas, mesurées : /health a continué à répondre 200 sans elle, et la page de chat est publique elle aussi (sans clé, elle a encore répondu, avec le 415 gzip du curl nu) ; ses propres appels à l’API exigent bien la clé, d’après le code. Et si le port est déjà pris, le serveur ne démarre pas : couldn't bind HTTP server socket, hostname: 127.0.0.1, port: 9931, puis il s’arrête. Cette erreur et 13 autres sont dans notre guide des erreurs de llama.cpp.
L’interface web : un chat sur le même port
Ouvrez http://127.0.0.1:9931 dans un navigateur : un chat complet vous attend, avec les conversations, le nom du modèle, son nombre de paramètres et sa quantification, et les tokens par seconde sous chaque réponse. Elle est activée par défaut ; --no-webui la coupe si vous ne voulez que l’API.
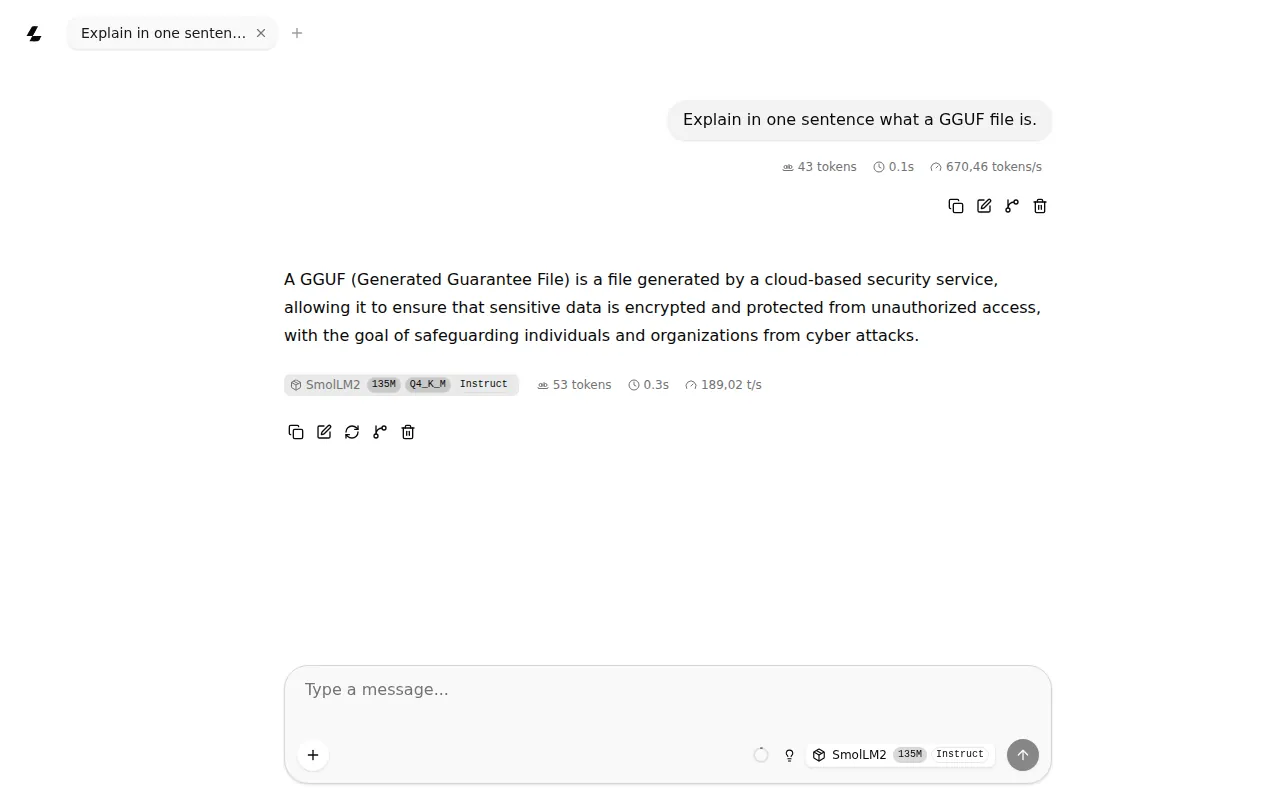
Oui, la réponse est fausse, et avec panache : 135 millions de paramètres suffisent pour tester un serveur, pas pour l’expliquer. Pour de vraies questions, prenez un vrai modèle. Dans la vidéo ci-dessous, le serveur est lancé avec -hf, un hôte et un port, et l’interface est montrée en action.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez.
Plusieurs modèles derrière un seul serveur : le mode routeur
Lancez llama-server sans modèle, avec un dossier, et il devient un routeur :
llama-server --models-dir ~/modelesNotre journal a affiché starting server in router mode. models will be automatically loaded on-demand et, en guise d’avertissement, router mode enabled - do not expose to untrusted environments. /v1/models a listé nos 2 fichiers GGUF (le même modèle, copié sous 2 noms), chacun nommé d’après son fichier sans .gguf et marqué unloaded. Une requête de chat sans nom de modèle a reçu un 400 : model name is missing from the request. Avec "model": "SmolLM2-135M-Instruct-Q4_K_M" dans le corps, le routeur a lancé un llama-server distinct pour ce modèle, sur son propre port, a répondu, et la liste l’a montré loaded tandis que l’autre restait unloaded. Dans le code, nous avons lu qu’il garde jusqu’à 4 modèles chargés par défaut (--models-max).
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez.
Le lancement que nous copierions
Pour une personne sur une machine :
export LLAMA_API_KEY="une-longue-chaine-aleatoire"
llama-server -m ./votre-modele.gguf -c 8192 -np 1 --alias local
Vous obtenez un slot avec les 8 192 tokens, une clé et un nom de modèle court, sur 127.0.0.1:9931. Vérifiez avec curl http://127.0.0.1:9931/health et curl -H "Authorization: Bearer $LLAMA_API_KEY" http://127.0.0.1:9931/v1/models. L’installation de llama.cpp, le choix du build pour votre carte et le reste des réglages de sécurité, CORS compris, sont dans notre guide d’installation de llama.cpp ; ce qu’il envoie de lui-même est sur la fiche llama.cpp ; et si vous hésitez avec un serveur pensé pour de nombreux utilisateurs, voyez vLLM vs llama.cpp.