Prenez llama.cpp pour faire tourner un modèle sur votre propre ordinateur, quel qu’il soit : Mac, Windows ou Linux, avec ou sans carte graphique. Prenez vLLM pour servir beaucoup de monde à la fois depuis un Linux avec carte NVIDIA ou AMD. Les deux connaissent nos 28 modèles : la version stable de llama.cpp depuis la v0.9.0 (4 novembre), celle de vLLM depuis la 0.34.0 (16 novembre). Le matériel tranche.
Voilà la version courte, et elle vient de la lecture du code, pas d’une intuition. Le 4 novembre 2026, nous avons pris les versions stables des deux projets, vLLM 0.33.0 et llama.cpp v0.8.0, nous les avons confrontées aux 28 modèles de notre outil et aux 18 machines de notre liste, puis nous avons comparé fichiers, serveurs, mémoire et ce que chacun envoie de lui-même. Le 17 novembre, nous sommes revenus au code de vLLM pour sa nouvelle version, la 0.34.0, qui apporte Mistral Large 4 et une autre façon d’utiliser la mémoire. Nous ne les avons pas chronométrés : pas de vainqueur en vitesse sur cette page, mais à la fin, la marche à suivre pour obtenir votre propre chiffre.
vLLMFiche logiciel llama.cppFiche logiciel
| vLLM | llama.cpp | |
|---|---|---|
| Versions stables lues | 0.34.0 (16 novembre) ; avant, la 0.33.0 (2 novembre) | v0.9.0 (4 novembre, 13:08 UTC), compilation b12110 ; avant, la v0.8.0 (b11960) |
| Ce que c’est | Un serveur en Python conçu pour servir des modèles à beaucoup d’utilisateurs | Un moteur en C et C++ avec ligne de commande, serveur et page de chat |
| Modèles de notre catalogue que connaît son code (28) | 28 dans la 0.34.0 (27 dans la 0.33.0) | 28 dans la v0.9.0 (27 dans la v0.8.0) |
| Machines parmi nos 18 où il utilise la puce graphique | 6, d’après sa documentation | 15 |
| Systèmes | Linux ; Windows seulement via WSL ; Mac sur le processeur, en expérimental | Windows, macOS et Linux, avec des téléchargements prêts |
| Format des fichiers | safetensors (le modèle d’origine) et des formats comme AWQ, GPTQ ou FP8 ; GGUF seulement via un module à part | GGUF ; safetensors seulement après conversion |
| Serveur local | 0.0.0.0:8000 (tout le réseau), sans clé |
127.0.0.1:9931 (votre ordinateur seulement), sans clé |
| Requêtes simultanées (serveur, d’origine) | Jusqu’à 256 sur une carte de moins de 70 Go | 4 emplacements |
| Mémoire graphique | Depuis la 0.34.0, la mémoire libre après le préchauffage, moins une marge de sécurité (avant, 92 % de la carte) | Ce que demandent le modèle et son contexte |
| Ce qu’il envoie de lui-même | Des statistiques d’usage au démarrage puis toutes les 10 minutes, sauf si vous les coupez | Rien (ni télémétrie ni vérification de version) |
| Licence | Apache 2.0 | MIT |
Les 28 mêmes modèles, deux métiers très différents
Nous attendions un écart énorme sur ce chiffre, et il n’y en a pas. Nous avons pris l’architecture que déclare chacun de nos 28 modèles dans son propre config.json et l’avons cherchée dans le registre de modèles de vLLM 0.33.0 et dans le convertisseur de llama.cpp v0.8.0. Résultat (lu dans le code le 4 novembre 2026) : 27 sur 28 pour chacun, et ce sont les 27 mêmes, de Qwen3 1.7B à gpt-oss-120b, en passant par Gemma 4, DeepSeek V4 Flash et Flint. Le même jour, llama.cpp a publié la v0.9.0, qui ajoute le 28e. Et le 16 novembre, vLLM 0.34.0 l’a ajouté à son tour : nous avons lu son registre de modèles le 17 novembre, et désormais les deux connaissent les 28.
Une précision honnête : il s’agit de prise en charge dans le code, pas de 28 modèles lancés un par un. Alors, s’ils connaissent les mêmes modèles, qu’est-ce qui les sépare ? Leur raison d’être. llama.cpp est né pour faire tenir un modèle sur du matériel ordinaire. vLLM est né pour servir un modèle à une foule sur de grosses cartes, et tout le reste en découle.
Sur lesquelles de nos 18 machines tourne chacun
C’est souvent ici que le choix se fait tout seul. llama.cpp publie des versions prêtes pour Windows, macOS et Linux, avec CUDA pour NVIDIA, Metal pour Apple Silicon, et ROCm ou Vulkan pour AMD. Sur les 18 machines de notre outil, il utilise la puce graphique sur 15 : les 5 PC à carte NVIDIA, les 8 Mac et les 2 PC à Ryzen AI Max. Sur les 3 autres, il tourne sur le processeur.
La liste de vLLM est plus courte. Il lui faut une carte NVIDIA de capacité de calcul 7.5 ou plus (nos RTX 3060, 4060, 4070, 4090 et les 2 RTX 3090 conviennent) ou une puce AMD de sa liste ROCm, qui cite la série Ryzen AI MAX / AI 300 : notre Ryzen AI Max+ 395 y entre, mais pas le PRO 495, de la série Max PRO 400, qu’elle ne mentionne pas encore. Soit 6 sur 18 avec la puce graphique selon sa documentation ; sur les autres, le processeur (sur Mac, aussi le module communautaire vLLM-Metal). Il tourne sous Linux ; sous Windows, via WSL. Depuis la 0.33.0, ses paquets prêts à l’emploi sont compilés pour CUDA 13.0 uniquement.
Et le Mac ? vLLM qualifie d’expérimentale sa prise en charge de macOS, sur le processeur seulement, en FP32 et FP16. Sa page d’installation dit toujours qu’il faut le compiler, alors que la publication 0.34.0, comme la 0.33.0, fournit bien un paquet CPU prêt pour Apple Silicon. Pour la puce graphique d’un Mac, il existe vLLM-Metal, un module maintenu par la communauté, qui s’appuie sur MLX et attend des modèles MLX. Si vous êtes sur Mac, le duel qui compte, c’est MLX vs llama.cpp.
Fichiers : GGUF d’un côté, le modèle d’origine de l’autre
llama.cpp se nourrit de GGUF, le format en un seul fichier inventé par ce projet, avec des poids déjà compressés entre 1 et 8 bits (quelques versions restent en 16). Notre catalogue recense 559 versions GGUF prêtes des 28 modèles, de 2 à 27 par modèle : bien souvent, llama-server -hf suivi du nom du dépôt suffit.
vLLM lit le modèle tel que son éditeur le publie, en safetensors, plus une longue liste de formats pensés pour les cartes graphiques : AWQ, GPTQ, FP8, MXFP4 et d’autres. GGUF n’est plus intégré : il vit dans un module à part, vllm-gguf-plugin, que la documentation de vLLM elle-même dit hautement expérimental. Concrètement, sur une carte grand public, vLLM a besoin qu’une version 4 ou 8 bits existe dans l’un de ses formats, car les poids d’origine d’un modèle de 27B ne tiennent pas dans 24 Go.

1 personne ou 256 : comment chacun sert
C’est le tour de force de vLLM. Il prend les requêtes à mesure qu’elles arrivent et glisse chaque nouvelle dans le lot dès qu’une place se libère, sans attendre la réponse la plus lente. Sur une carte de moins de 70 Go, son serveur traite d’origine jusqu’à 256 requêtes simultanées (1 024 sur les plus grosses cartes de centre de données). Son système de mémoire, PagedAttention, range le cache des conversations en petites pages pour ne rien gaspiller.
llama-server est plus modeste : la v0.9.0, comme la v0.8.0, ouvre 4 emplacements d’origine, qui partagent un seul cache. Pour vous, votre famille ou une petite équipe, c’est largement suffisant ; pour une application à plusieurs centaines d’utilisateurs, c’est là que vLLM prend le large.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
La vidéo pédagogique d’IBM Technology, que nous avons regardée via ses sous-titres, raconte la même histoire en 10 minutes environ : llama.cpp fait tenir les modèles sur du matériel ordinaire grâce à la quantification, au GGUF et au processeur ; vLLM vise la montée en charge, avec un traitement continu par lots expliqué par des crêpes sur une plancha (validé). Les deux, rappelle-t-elle, parlent la même API de style OpenAI : votre code change à peine si vous passez de l’un à l’autre.
Mémoire : toute la carte d’un coup, ou ce que demande le modèle
vLLM est gourmand par conception, et depuis la 0.34.0 encore plus. Jusqu’à la 0.33.0, il réservait au démarrage 92 % de la mémoire de la carte, le modèle plus un gros cache pour toutes ces conversations en parallèle. Dans le code source de la 0.34.0 (lu le 17 novembre 2026, sans mesure), la valeur par défaut monte à toute la carte sur NVIDIA et AMD : après avoir chargé le modèle et fait son préchauffage, vLLM donne à son cache la mémoire encore libre, moins une marge de sécurité d’au moins 1 Gio (3 Gio sur AMD) et la place dont a besoin sa propre mémoire de travail. Parfait sur un serveur qui ne fait que ça. Sur un PC de bureau, ce qui occupait déjà la carte, votre écran compris, garde sa place ; l’application que vous ouvrez ensuite la trouve pleine.
llama.cpp demande ce dont le modèle et son contexte ont besoin. D’origine, il prend le contexte d’entraînement du modèle et, si la mémoire manque, le réduit jusqu’à ce que tout tienne, jamais sous 4 096 tokens. Et si le modèle dépasse la carte, il peut laisser une partie des couches en mémoire système et les faire tourner sur le processeur : plus lent, mais ça démarre.
Portes ouvertes et ce que chacun envoie
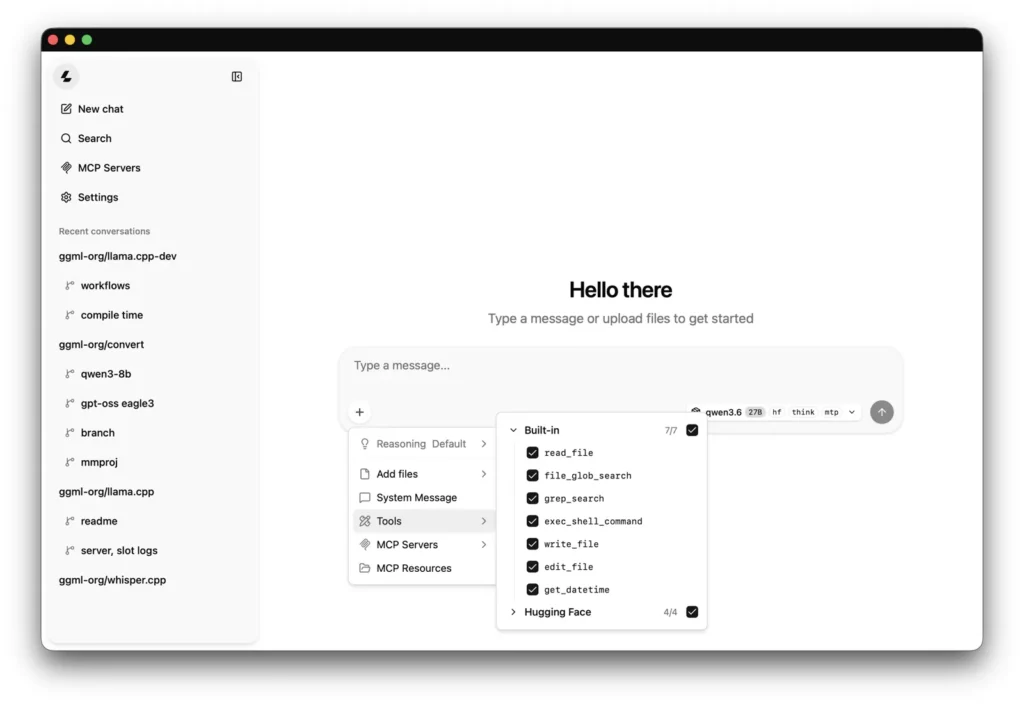
C’est la partie qui compte le plus pour nous sur ce site. llama.cpp n’écoute que sur votre propre ordinateur (127.0.0.1), sur le port 9931, n’a ni télémétrie ni vérification de version, et ne se connecte que si vous le lui demandez : pour télécharger un modèle ou récupérer une image par son adresse web. Son serveur propose aussi une page de chat à la même adresse et accepte d’origine les appels de n’importe quelle page web, avec un avertissement dans la console si vous n’avez pas défini de clé.
vLLM collecte d’origine des données d’usage anonymes, et il le dit : il les envoie à stats.vllm.ai au démarrage puis toutes les 10 minutes tant qu’il tourne, et en garde une copie dans ~/.config/vllm/usage_stats.json pour que vous lisiez exactement ce qui est parti. Une ligne suffit à couper : VLLM_NO_USAGE_STATS=1 (il existe 3 autres moyens). Les appels depuis des pages web sont fermés tant que vous ne les autorisez pas. Chaque connexion, avec sa source, figure sur les fiches vLLM et llama.cpp.
Lequel nous prendrions, et ce que nous ne savons pas
- Un modèle sur votre propre ordinateur, pour vous : llama.cpp. Il tourne sur nos 18 machines et utilise la puce graphique sur 15.
- Un Mac : llama.cpp, avec Metal. vLLM sur Mac, c’est le processeur seul, en expérimental.
- Une application ou une équipe qui sollicite le même modèle en même temps, sous Linux avec une carte NVIDIA : vLLM. Jusqu’à 256 requêtes simultanées d’origine, c’est toute sa raison d’être.
- Le modèle d’origine, ou des formats GPU comme FP8 ou AWQ : vLLM. Pour des fichiers 4 bits prêts qui tiennent dans une carte grand public, GGUF et llama.cpp.
Ce que nous ne savons pas : lequel est le plus rapide sur votre machine avec votre modèle. Nous ne l’avons pas mesuré, et cela dépend de la carte, du modèle, du format et du nombre de personnes qui interrogent en même temps. Les deux fournissent leur banc d’essai : vllm bench serve et llama-bench. Même modèle, taille comparable, même prompt, et vous tenez votre propre chiffre.
Envie de vous lancer ? Nos guides vous accompagnent pour démarrer llama.cpp et démarrer vLLM, et en cas de pépin, il y a llama.cpp ne fonctionne pas et vLLM ne fonctionne pas. Si vous hésitez entre l’un des deux et Ollama, vLLM vs Ollama et llama.cpp vs Ollama prennent le relais, et le trouveur de modèle vous dit lesquels des 28 tiennent dans la mémoire de votre ordinateur.