Elige llama.cpp para mover un modelo en tu propio ordenador, sea el que sea: Mac, Windows o Linux, con tarjeta gráfica o sin ella. Elige vLLM para servir a mucha gente a la vez desde un Linux con tarjeta NVIDIA o AMD. Los dos tienen código para nuestros 28 modelos: la estable de llama.cpp desde la v0.9.0 (4 de noviembre) y la de vLLM desde la 0.34.0 (16 de noviembre). Decide el hardware.
Esa es la versión corta, y sale de leer código, no de una corazonada. El 4 de noviembre de 2026 cogimos las versiones estables de los dos proyectos, vLLM 0.33.0 y llama.cpp v0.8.0, cruzamos con ellas los 28 modelos de nuestro buscador y los 18 equipos de nuestra lista, y pusimos lado a lado ficheros, servidores, memoria y lo que manda cada uno por su cuenta. El 17 de noviembre volvimos al código de vLLM por su versión nueva, la 0.34.0, que trae Mistral Large 4 y otra forma de usar la memoria. No los hemos cronometrado, así que en esta página no hay ganador de velocidad; al final te contamos cómo sacar tu propia cifra.
vLLMFicha del programa llama.cppFicha del programa
| vLLM | llama.cpp | |
|---|---|---|
| Versiones estables que hemos leído | 0.34.0 (16 de noviembre); antes, la 0.33.0 (2 de noviembre) | v0.9.0 (4 de noviembre, 13:08 UTC), compilación b12110; antes, la v0.8.0 (b11960) |
| Qué es | Un servidor en Python pensado para servir modelos a muchos usuarios | Un motor en C y C++ con línea de órdenes, servidor y página de chat |
| Modelos de nuestro catálogo que conoce su código (28) | 28 en la 0.34.0 (27 en la 0.33.0) | 28 en la v0.9.0 (27 en la v0.8.0) |
| Equipos de nuestros 18 en los que usa el chip gráfico | 6, según su documentación | 15 |
| Sistemas | Linux; Windows solo con WSL; Mac con el procesador, en experimental | Windows, macOS y Linux, con descargas listas |
| Formato de los ficheros | safetensors (el modelo original) y formatos como AWQ, GPTQ o FP8; GGUF solo con un complemento aparte | GGUF; safetensors solo tras convertirlos |
| Servidor local | 0.0.0.0:8000 (toda la red), sin clave |
127.0.0.1:9931 (solo tu ordenador), sin clave |
| Peticiones a la vez (servidor, de serie) | Hasta 256 en una tarjeta de menos de 70 GB | 4 huecos |
| Memoria gráfica | Desde la 0.34.0, la memoria libre tras el calentamiento, menos un margen de seguridad (antes, el 92 % de la tarjeta) | La que piden el modelo y su contexto |
| Lo que manda por su cuenta | Estadísticas de uso al arrancar y cada 10 minutos, salvo que las apagues | Nada (ni telemetría ni comprobación de versiones) |
| Licencia | Apache 2.0 | MIT |
Los mismos 28 modelos para dos oficios muy distintos
Esperábamos una paliza en esta cifra y no la hay. Tomamos la arquitectura que declara cada uno de nuestros 28 modelos en su propio config.json y la buscamos en el registro de modelos de vLLM 0.33.0 y en el conversor de llama.cpp v0.8.0. Resultado (leído en código, 4 de noviembre de 2026): 27 de 28 cada uno, y son los mismos 27, de Qwen3 1.7B a gpt-oss-120b, pasando por Gemma 4, DeepSeek V4 Flash y Flint. Ese mismo día llama.cpp publicó la v0.9.0, que suma el 28.º. Y el 16 de noviembre lo sumó también vLLM 0.34.0: leímos su registro de modelos el 17 de noviembre, y ahora los dos conocen los 28.
Una nota honesta: esto es soporte en el código, no 28 modelos ejecutados uno a uno. Y si los dos conocen los mismos modelos, ¿qué los separa? Para qué nacieron. llama.cpp nació para meter un modelo en hardware normal y corriente. vLLM nació para servir un modelo a una multitud con tarjetas grandes, y todo lo demás viene de ahí.
En cuáles de nuestros 18 equipos funciona cada uno
Aquí la elección suele hacerse sola. llama.cpp publica compilaciones listas para Windows, macOS y Linux, con CUDA para NVIDIA, Metal para Apple Silicon y ROCm o Vulkan para AMD. De los 18 equipos de nuestro buscador, usa el chip gráfico en 15: los 5 PC con tarjeta NVIDIA, los 8 Mac y los 2 PC con Ryzen AI Max. En los otros 3 tira del procesador.
La lista de vLLM es más corta. Pide una tarjeta NVIDIA con capacidad de cómputo 7.5 o superior (nuestras RTX 3060, 4060, 4070, 4090 y las 2 RTX 3090 cumplen) o un chip AMD de su lista de ROCm, que nombra la serie Ryzen AI MAX / AI 300: entra nuestro Ryzen AI Max+ 395, pero no el PRO 495, de la serie Max PRO 400, que aún no aparece. Total: 6 de 18 con el chip gráfico según su documentación; en el resto, el procesador (en Mac, también el complemento vLLM-Metal de la comunidad). Funciona en Linux; en Windows, a través de WSL. Desde la 0.33.0, sus paquetes listos salen compilados solo para CUDA 13.0.
¿Y el Mac? vLLM llama experimental a su soporte de macOS, solo con el procesador y con números FP32 y FP16. Su página de instalación sigue diciendo que hay que compilarlo, aunque la publicación 0.34.0, como la 0.33.0, sí trae un paquete listo de CPU para Apple Silicon. Para el chip gráfico de un Mac existe vLLM-Metal, un complemento que mantiene la comunidad, que usa MLX por debajo y pide modelos MLX. Si estás en un Mac, la pelea que te importa es MLX vs llama.cpp.
Ficheros: GGUF en un lado, el modelo original en el otro
llama.cpp se alimenta de GGUF, el formato de un solo fichero que inventó este proyecto, con los pesos ya comprimidos a entre 1 y 8 bits (algunas versiones se quedan en 16). Nuestro catálogo recoge 559 versiones GGUF listas de los 28 modelos, entre 2 y 27 por modelo, así que muchas veces basta con llama-server -hf y el nombre del repositorio.
vLLM lee el modelo tal como lo publica su fabricante, en safetensors, más una larga lista de formatos pensados para tarjetas gráficas: AWQ, GPTQ, FP8, MXFP4 y otros. GGUF ya no viene de serie: vive en un complemento aparte, vllm-gguf-plugin, y la propia documentación de vLLM lo llama altamente experimental. En la práctica, con una tarjeta de casa vLLM necesita que alguien haya publicado una versión de 4 u 8 bits en uno de sus formatos, porque los pesos originales de un modelo de 27B no caben en 24 GB.

1 persona o 256: cómo atiende cada uno
Este es el número estrella de vLLM. Recoge las peticiones según llegan y mete cada nueva en el lote en cuanto queda un hueco libre, sin esperar a la respuesta más lenta. En una tarjeta de menos de 70 GB, su servidor procesa de serie hasta 256 peticiones a la vez (1.024 en las tarjetas de centro de datos más grandes). Su sistema de memoria, PagedAttention, guarda la caché de las conversaciones en páginas pequeñas para no desperdiciarla.
llama-server es más modesto: la v0.9.0, como la v0.8.0, abre 4 huecos de serie que comparten una sola caché. Para ti, tu familia o un equipo pequeño, sobra; para una aplicación con cientos de usuarios, ahí es donde vLLM se escapa.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
El vídeo divulgativo de IBM Technology, que vimos por sus subtítulos, cuenta la misma historia en unos 10 minutos: llama.cpp hace que los modelos quepan en hardware normal con cuantización, GGUF y el procesador; vLLM es para escalar, con el procesamiento continuo por lotes explicado con tortitas en una plancha (aprobado). Los dos, recuerda, hablan la misma API al estilo de OpenAI, así que tu código apenas cambia si saltas de uno a otro.
Memoria: la tarjeta entera de golpe, o lo que pida el modelo
vLLM es glotón por diseño, y desde la 0.34.0 todavía más. Hasta la 0.33.0 se reservaba al arrancar el 92 % de la memoria de la tarjeta, el modelo más una caché grande para todas esas conversaciones en paralelo. En el código fuente de la 0.34.0 (leído el 17 de noviembre de 2026, sin medir), el valor por defecto sube a la tarjeta entera en NVIDIA y AMD: tras cargar el modelo y hacer el calentamiento, vLLM le da a su caché la memoria que sigue libre, menos un margen de seguridad de al menos 1 GiB (3 GiB en AMD) y el sitio que necesita su propia memoria de trabajo. En un servidor que solo hace eso, perfecto. En un ordenador de sobremesa, lo que ya estaba en la tarjeta, tu pantalla incluida, conserva su sitio; la aplicación que abras después se la encuentra llena.
llama.cpp pide lo que necesitan el modelo y su contexto. De serie toma el contexto con el que se entrenó el modelo y, si falta memoria, lo recorta hasta que quepa, nunca por debajo de 4.096 tokens. Y si el modelo es más grande que la tarjeta, puede dejar algunas capas en la memoria del sistema y moverlas con el procesador: más lento, pero arranca.
Puertas abiertas y lo que manda cada uno
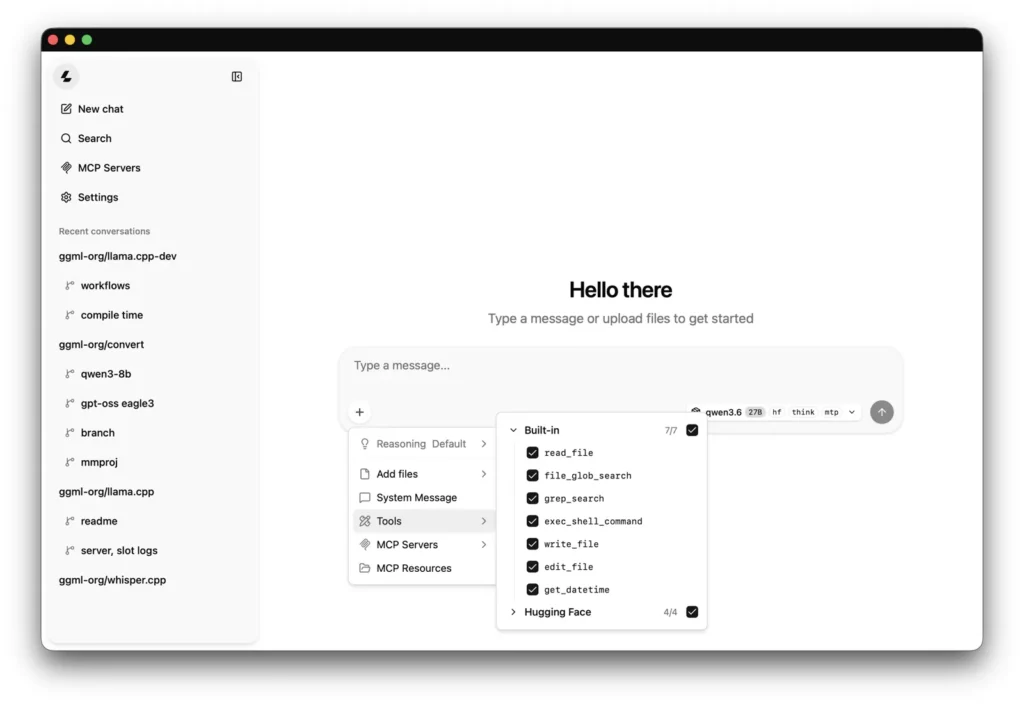
Esta es la parte que más nos importa en esta web. llama.cpp escucha solo en tu propio ordenador (127.0.0.1), en el puerto 9931, no tiene telemetría ni comprueba versiones, y solo se conecta cuando se lo pides: para bajar un modelo o para traer una imagen por su dirección web. Su servidor también sirve una página de chat en la misma dirección y, de serie, acepta llamadas desde cualquier página web, con un aviso en la consola si no has puesto clave.
vLLM recoge datos de uso anónimos de serie y lo dice: los manda a stats.vllm.ai al arrancar y cada 10 minutos mientras funciona, y guarda una copia en ~/.config/vllm/usage_stats.json para que leas exactamente lo que ha salido. Una línea lo apaga: VLLM_NO_USAGE_STATS=1 (hay 3 vías más). Las llamadas desde páginas web están cerradas salvo que las permitas. Cada conexión, con su fuente, está en las fichas de vLLM y de llama.cpp.
Cuál usaríamos nosotros, y lo que no sabemos
- Un modelo en tu propio ordenador, para ti: llama.cpp. Funciona en nuestros 18 equipos y usa el chip gráfico en 15.
- Un Mac: llama.cpp, con Metal. vLLM en Mac va solo con el procesador y en experimental.
- Una aplicación o un equipo atacando el mismo modelo a la vez, en Linux con tarjeta NVIDIA: vLLM. Hasta 256 peticiones a la vez de serie es su razón de ser.
- El modelo original, o formatos de GPU como FP8 o AWQ: vLLM. Para ficheros de 4 bits listos que caben en una tarjeta de casa, GGUF y llama.cpp.
Lo que no sabemos: cuál va más rápido en tu equipo con tu modelo. No lo hemos medido, y depende de la tarjeta, el modelo, el formato y de cuánta gente pregunte a la vez. Los dos traen su prueba de velocidad: vllm bench serve y llama-bench. Mismo modelo, tamaño parecido, mismo prompt, y ya tienes tu propia cifra.
¿Te lanzas? Nuestras guías te llevan de la mano para instalar llama.cpp y instalar vLLM, y si algo se tuerce, tienes llama.cpp no funciona y vLLM no funciona. Si dudas entre cualquiera de los dos y Ollama, vLLM vs Ollama y llama.cpp vs Ollama siguen donde esta se para, y el buscador de modelos te dice cuáles de los 28 caben en la memoria de tu ordenador.