Ollama v0.40.16 le da a un modelo 4.096 tokens de contexto si encuentra menos de 23 GiB de memoria gráfica, 32.768 desde 23 GiB y 262.144 desde 47 GiB. Se cambia con OLLAMA_CONTEXT_LENGTH, /set parameter num_ctx o num_ctx; en LM Studio, al cargar el modelo; en llama.cpp, con -c. Y cada token cuesta memoria.
¿Cuánta memoria? Lo hemos calculado. El 5 de noviembre de 2026 leímos el código y la documentación oficial de las 3 versiones estables (Ollama v0.40.14, LM Studio 0.4.28 y llama.cpp v0.9.0; el 7 de noviembre comprobamos que Ollama v0.40.15 mantiene el mismo código de contexto y la misma documentación, y el 10 de noviembre, que la v0.40.16 también) y pasamos 6 modelos de nuestro catálogo por el mismo motor que mueve nuestro buscador de modelos: cuánto pesa la caché del contexto a 4k, 8k, 32k, 128k y al máximo de cada modelo, y en cuántos de nuestros 18 equipos cabe cada combinación. Te adelantamos el final: en un modelo pequeño, el contexto completo puede pesar 15 veces más que el propio modelo.
 OllamaFicha del programa
 LM StudioFicha del programa
 llama.cppFicha del programa
Qué es la longitud de contexto y por qué se come la memoria
El contexto es todo lo que el modelo ve a la vez: tus instrucciones, la conversación hasta ahora, el documento que has pegado y la respuesta que está escribiendo. Se cuenta en tokens, trozos de palabra: en nuestras mediciones con el tokenizador de Qwen3 8B, un contrato en español gasta 1,54 tokens por palabra.
Para no releerlo todo con cada token nuevo, el programa guarda una caché, la caché KV (K y V son las 2 mitades que guarda de cada token en cada capa). Esa caché se reserva al cargar el modelo, para todo el contexto que hayas pedido, lo uses o no. Su tamaño sale del diseño del modelo: capas × cabezas KV × tamaño de cabeza × 2 mitades × bytes por valor. En Qwen3 8B son 36 capas × 8 cabezas × 128 × 2 × 2 bytes: 144 KiB por token. Multiplica por 40.960 tokens y salen 5,6 GiB, más que los 4,7 GiB que pesa el modelo en Q4_K_M.
Cuánta memoria cuesta cada contexto: 6 modelos
Elegimos modelos que la gente usa de verdad: 2 Qwen3 pequeños, Phi-4, Gemma 4 12B, gpt-oss-20b (un modelo de mezcla de expertos, MoE) y Qwen3.6 27B. La tabla da la memoria que añade la caché, en GiB, con la precisión f16 de serie, y la última columna dice en cuántos de los 18 equipos de nuestro buscador cabe el modelo a su contexto máximo, con el fichero Q4_K_M. Son las mismas cifras que da la herramienta, porque hace el mismo cálculo.
| Modelo (contexto máximo) | 4k | 8k | 32k | 128k | A su máximo | Cabe a su máximo |
|---|---|---|---|---|---|---|
| Qwen3 4B 2507 (262.144) | 0,6 | 1,1 | 4,5 | 18,0 | 36,0 | 8 de 18 |
| Qwen3 8B (40.960) | 0,6 | 1,1 | 4,5 | — | 5,6 | 15 de 18 |
| Phi-4 (16.384) | 0,8 | 1,6 | — | — | 3,1 | 15 de 18 |
| Gemma 4 12B (262.144) | 0,4 | 0,4 | 0,8 | 2,3 | 4,3 | 12 de 18 |
| gpt-oss-20b (131.072) | 0,1 | 0,2 | 0,8 | 3,0 | 3,0 | 12 de 18 |
| Qwen3.6 27B (262.144) | 0,3 | 0,5 | 2,0 | 8,0 | 16,0 | 8 de 18 |
Fíjate en las filas que no crecen como las demás. Gemma 4 12B usa una ventana deslizante de 1.024 tokens en 40 de sus 48 capas, así que solo 8 capas guardan la conversación entera: 4,3 GiB a 262.144 tokens. gpt-oss-20b hace lo mismo con una ventana de 128 tokens en la mitad de sus capas: 3,0 GiB a 131.072. Qwen3.6 27B guarda un estado de tamaño fijo en 48 de sus 64 capas, y solo 16 crecen con el contexto. Qwen3 y Phi-4, en cambio, guardan cada token en cada capa, y ahí es donde el contexto duele. Si se contaran como completas todas las capas de gpt-oss-20b y Qwen3.6 27B, gpt-oss-20b pediría 6,0 GiB a 131.072 en vez de 3,0, y Qwen3.6 27B 64 GiB en vez de 16; nuestro motor lee el patrón de capas de cada modelo.
2 casos que conviene conocer. Qwen3 8B con sus 40.960 tokens completos no cabe en una RTX 3060 ni en una RTX 4070 de 12 GB: pide 11,7 GiB con los búferes y esas tarjetas dejan 11,2. A 32.768 sí cabe, con 10,4. Phi-4 a sus 16.384 pide 12,5 GiB y se queda fuera de las mismas 2. Cuantizar la caché, más abajo, rescata a los dos.
Ollama: 4k, 32k o 256k según tu memoria gráfica
Ollama elige el contexto por ti al arrancar el servidor. En server/routes.go de la v0.40.16 (líneas 2579 a 2584) suma la memoria de las tarjetas gráficas que detecta y pone 262.144 tokens desde 47 GiB, 32.768 desde 23 GiB y 4.096 por debajo (si no detecta ninguna tarjeta, el total es 0). El registro del servidor dice lo que ha elegido, en una línea con el mensaje vram-based default context. Con una RTX 3060 de 12 GB te tocan 4.096; con una RTX 4090 de 24 GB, 32.768; con 2 RTX 3090, 262.144.
Hay 4 formas de cambiarlo, de la más general a la más concreta (documentación de Ollama v0.40.16, docs/faq.mdx, docs/modelfile.mdx y docs/context-length.mdx):
- Para todos los modelos: arranca el servidor con
OLLAMA_CONTEXT_LENGTH=8192 ollama serve(envconfig/config.go, línea 230). La aplicación de escritorio tiene un deslizador para esto en sus ajustes. - En un chat con
ollama run: escribe/set parameter num_ctx 8192(cmd/interactive.go, línea 109). - Para un modelo, de forma fija: un Modelfile con
PARAMETER num_ctx 8192y despuésollama create. - Desde tu código:
"options": {"num_ctx": 8192}en la petición a/api/generateo/api/chat.
Después compruébalo con ollama ps: la columna CONTEXT enseña lo que se ha cargado de verdad, y PROCESSOR te dice si todo se ha quedado en la tarjeta gráfica. 3 detalles del código que explican resultados raros. Si pides más de lo que admite el modelo, Ollama lo recorta a ese máximo (llm/server.go, líneas 111 a 113). Si el contexto lo eligió Ollama y el modelo no cabe al cargarlo, reintenta una sola vez con el escalón de abajo: 32.768 si estaba por encima, o 4.096 si estaba entre 4.097 y 32.768; en 4.096 ya no reintenta (server/sched.go, líneas 694 a 697, 811 a 813 y 953 a 962); si lo has fijado tú, no baja por su cuenta. Y OLLAMA_NUM_PARALLEL (1 de serie) multiplica el contexto, y la caché, por el número de peticiones que puede atender a la vez.
Se abre en YouTube (sin cookies) solo si pulsas.
Este vídeo corto repasa 4 formas de saber si Ollama mueve un modelo en tu tarjeta gráfica o en el procesador. Es la comprobación que toca después de subir num_ctx: si PROCESSOR deja de decir 100% GPU, el contexto que pediste ha echado parte del modelo fuera de la tarjeta.

LM Studio: el contexto se decide al cargar el modelo
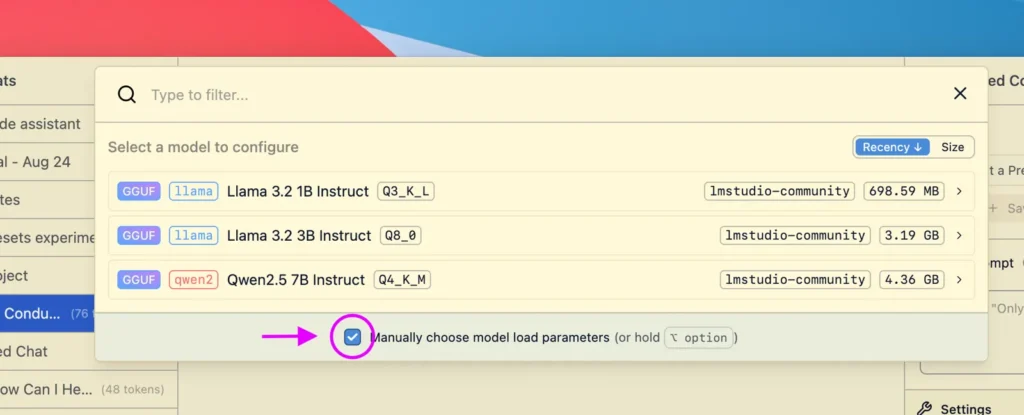
En LM Studio 0.4.28 (la versión estable el 5 de noviembre de 2026), la longitud de contexto es un ajuste de carga, no del chat. En el selector de modelos, marca «Manually choose model load parameters» y te aparecen los ajustes de carga, el contexto entre ellos, antes de que el modelo se cargue; también puedes guardarlos como los de serie de ese modelo, junto con el reparto en la GPU y Flash Attention.
Desde la terminal, su comando lms hace lo mismo (documentación de LM Studio, lmstudio.ai/docs/cli/local-models/load): lms load <model_key> --context-length 16384 (en el código de lms, también -c 16384). Añade --estimate-only y te dice la memoria que necesitaría, contando ese contexto, sin cargar nada: una forma gratis de probar 32k antes de lanzarte. Si no pones --context-length, se usa el valor guardado de serie para ese modelo. Desde código, la API REST acepta context_length en POST /api/v1/models/load.
llama.cpp: -c, y un valor de serie que es el máximo del modelo
llama.cpp v0.9.0 es el que más pide de serie. En common/arg.cpp (línea 1590), -c, --ctx-size vale 0 si no lo tocas, y 0 significa el contexto con el que se entrenó el modelo: 40.960 en Qwen3 8B, 262.144 en Gemma 4 12B. Lo que te salva es --fit, encendido de serie (common/common.h, línea 485): si ese contexto no cabe en memoria, lo encoge, pero nunca por debajo de 4.096 tokens (línea 487, se cambia con --fit-ctx). Si escribes tú -c 0, deja de recortar e intenta el máximo completo.
En la práctica: llama-server -m modelo.gguf -c 16384 y sabes exactamente lo que pagas. Con llama-server hay un detalle más: de serie abre 4 ranuras (slots) que comparten una sola caché del tamaño de -c (tools/server/server.cpp, líneas 127 a 130), así que 4 conversaciones largas a la vez se reparten esos tokens.
La palanca: cuantizar la caché a q8_0 o q4_0
La caché se guarda en f16 de serie, 2 bytes por valor. Los 3 programas pueden guardarla en menos bytes: q8_0 usa 34 bytes por cada 32 valores (el 53 % de f16) y q4_0 usa 18 (el 28 %). Nuestro motor, con esos tamaños exactos:
- Qwen3 8B a 40.960 tokens: la caché pasa de 5,6 a 3,0 GiB con q8_0, y el modelo ya cabe en la RTX 3060 y la RTX 4070 de 12 GB (9,0 GiB en total): de 15 a 17 de nuestros 18 equipos.
- Phi-4 a 16.384: de 3,1 a 1,7 GiB con q8_0, y también entra en esas 2 tarjetas: 17 de 18.
- Qwen3 4B 2507 a 262.144: de 36,0 a 10,1 GiB con q4_0, y de 8 a 12 equipos (se suman la RTX 4090, el Mac con M4 Pro de 24 GB y los 2 equipos de 32 GB).
Cómo se activa. En Ollama, OLLAMA_KV_CACHE_TYPE=q8_0 al arrancar el servidor; vale para todos los modelos y solo funciona con Flash Attention, que Ollama enciende por sí solo cuando tu hardware lo admite. En llama.cpp, -ctk q8_0 -ctv q8_0 (--cache-type-k y --cache-type-v, common/arg.cpp líneas 2388 y 2401). La mitad V cuantizada exige Flash Attention: con -fa en auto, que es lo de serie, llama.cpp lo enciende; con -fa off se niega a arrancar (src/llama-context.cpp, líneas 4331 a 4338). En LM Studio son opciones de carga de su motor llama.cpp, una para K y otra para V (llamaKCacheQuantizationType y llamaVCacheQuantizationType en su SDK).
Qué contexto elegir
Parte de tu tarea, no del máximo del modelo. Un chat de preguntas cortas vive feliz con 4.096 u 8.192 tokens. Resumir un informe largo o un contrato pide de 16.384 a 32.768: un contrato de 10.000 palabras son unos 15.400 tokens para Qwen3 8B en español, 11.200 en inglés, 15.000 en francés y 22.700 en alemán, medidos con su tokenizador sobre textos nuestros. Las herramientas de programación y los agentes que leen ficheros enteros quieren 64.000 o más, que es la cifra que da la documentación de Ollama para ellos.
Si Ollama es nuevo para ti, nuestra guía para usar Ollama en local empieza desde cero, y si un modelo carga y luego va a paso de tortuga, Ollama no funciona tiene los arreglos. Para los otros 2, mira cómo usar LM Studio en local y cómo usar llama.cpp en local. Y para llamar a Ollama desde tu propio código, nuestra guía de la API de Ollama explica sus rutas, su capa compatible con OpenAI y keep_alive.