Auf einem Mac mit Apple Silicon laden Sie MLX, wenn Sie es mit mlx-lm oder der MLX-Engine von LM Studio nutzen: Bei 6 der 7 Modelle, die wir gemessen haben, ist die 4-Bit-MLX-Datei 4 bis 8 % kleiner als GGUF in Q4_K_M. GGUF nehmen Sie für llama.cpp, für jeden anderen Rechner oder für feinere Kompressionsstufen. Ollama entscheidet für Sie.
Hinter diesem letzten Satz steckt der kurioseste Fund dieser Seite, dazu kommen wir gleich. Zuerst die Methode. Am 27. Oktober 2026 haben wir auf Hugging Face die echte Größe derselben 7 Modelle in beiden Formaten gemessen, den Code von Ollama 0.40.11 dort gelesen, wo er entscheidet, welche Datei Ihr Mac lädt, und seinen Katalog nach 9 Modellen gefragt, genau so, wie Ollama selbst fragt. Die Versionen an diesem Tag: mlx-lm 0.32.2 mit mlx 0.32.4, llama.cpp v0.7.0, Ollama 0.40.11 und LM Studio 0.4.26. Was wir nicht gemacht haben: MLX gegen llama.cpp auf einem eigenen Mac mit der Stoppuhr antreten lassen. Einen Geschwindigkeitssieger finden Sie hier also nicht, und weiter unten steht, warum.
 MLX (mlx-lm)Programm-Datenblatt
 llama.cppProgramm-Datenblatt
| MLX | GGUF | |
|---|---|---|
| Was es ist | Apples Framework für maschinelles Lernen und sein Modellformat: ein Ordner mit config.json, dem Tokenizer und den Gewichten als safetensors-Dateien |
Das Format, das llama.cpp erfunden hat: 1 Datei mit Gewichten, Tokenizer und Einstellungen (große Modelle kommen in Teile gesplittet) |
| Läuft auf | Macs mit Apple Silicon ab macOS 14; unter Linux mit CUDA oder nur auf dem Prozessor über Zusatzpakete | Windows, macOS (auf Intel-Macs nur Prozessor), Linux und Android |
| Programme, die es ausführen | mlx-lm, die MLX-Engine von LM Studio und Ollama auf Apple Silicon | llama.cpp, LM Studio und Ollama; nicht mlx-lm |
| Versionen am 27. Oktober 2026 | mlx-lm 0.32.2, mlx 0.32.4 | llama.cpp v0.7.0 (Build b11669) |
| Kompressionsstufen | 2, 3, 4, 5, 6 oder 8 Bit, dazu mxfp4, nvfp4 und mxfp8, gemischte Rezepte und DWQ-Versionen | 25 Dateien für Qwen3 8B in einem einzigen Repository, von IQ1_S bis Q8_0 und BF16 |
| Dasselbe Modell mit 4 Bit (Qwen3 Coder 30B) | 16,00 GiB, 4,50 Bit pro Gewicht | 17,28 GiB in Q4_K_M, 4,86 Bit pro Gewicht |
| Modelle, die Bilder verstehen | Der Bildteil steckt im selben Ordner | Eine eigene mmproj-Datei, 0,87 GiB bei Qwen3.6 27B |
| In Ollama 0.40.11 | Lädt ein Mac mit Apple Silicon, wenn das Tag eine MLX-Version hat | Laden alle anderen Rechner, und der Mac, wenn das Tag keine MLX-Version hat |
| Selbst erstellen | mlx_lm.convert -q aus den Originalgewichten |
Das Skript convert_hf_to_gguf.py aus dem Repository von llama.cpp, danach sein Quantisierer |
| Lokaler Server | mlx_lm.server auf 127.0.0.1:8080 |
llama serve auf 127.0.0.1:9931 |
| Geschwindigkeit | Von uns nicht gemessen | Von uns nicht gemessen |
2 Formate und 4 Programme: wer was liest
Der Vergleich wird unübersichtlich, weil MLX 2 Dinge zugleich ist. Es ist Apples Framework, die Rechenschicht, die auf dem Grafikchip des Macs arbeitet und dabei seinen gemeinsamen Speicher nutzt, und es ist auch der Name für Modelle, die dafür umgewandelt wurden. GGUF ist nur ein Dateiformat, das von llama.cpp, und die 3 Programme auf dieser Seite, die es lesen, haben llama.cpp an Bord.
Auf einem Mac lesen 4 Programme diese Dateien, und jedes steht auf einer Seite:
- mlx-lm führt MLX aus und sonst nichts. Es lädt einen Ordner mit
config.jsonundmodel*.safetensors-Dateien;*.ggufsteht nicht einmal in der Liste der Dateien, die es herunterlädt. Es kann ein Modell nach GGUF exportieren, aber nur Modelle im Stil von Mistral, Mixtral und Llama in fp16. - llama.cpp führt GGUF aus und sonst nichts, auf dem Grafikchip des Macs über Metal. Ein Modell in safetensors muss vorher umgewandelt werden.
- LM Studio führt beides aus. Seine Suche zeigt GGUF und MLX nebeneinander; GGUF geht an seine llama.cpp-Engine, MLX an seine eigene MLX-Engine, die quelloffen unter MIT steht.
- Ollama führt ebenfalls beides aus, entscheidet aber für Sie: Auf einem Mac mit Apple Silicon lädt es die MLX-Version eines Modells, wenn es eine gibt, sonst die GGUF-Version.
 LM StudioProgramm-Datenblatt
 OllamaProgramm-Datenblatt
„MLX oder GGUF?“ sind also eigentlich 2 Fragen: welche Datei, und welches Programm sie ausführt. Ist das Programm llama.cpp, lautet die Antwort GGUF, und die Seite ist hier zu Ende. Spannend wird es mit den anderen 3.
Gleiches Modell, 2 Größen: was wir an 7 Modellen gemessen haben
Wir haben 7 Modelle genommen, die es in beiden Formaten gibt, und am 27. Oktober 2026 die Bytes aller Gewichtsdateien auf Hugging Face addiert: die 4-Bit-MLX-Version der Organisation mlx-community gegen GGUF in Q4_K_M aus den Repositories, die unser Modellfinder ohnehin nutzt, damit sich die Zahlen mit ihm abgleichen lassen.
| Modell | MLX 4 Bit | GGUF Q4_K_M | Unterschied |
|---|---|---|---|
| Qwen3 8B | 4,29 GiB | 4,68 GiB | −0,39 GiB (−8,4 %) |
| Qwen3.5 9B* | 5,54 GiB | 5,29 GiB | +0,25 GiB (+4,7 %) |
| Gemma 4 12B | 6,28 GiB | 6,63 GiB | −0,35 GiB (−5,3 %) |
| gpt-oss-20b | 10,41 GiB | 10,83 GiB | −0,42 GiB (−3,8 %) |
| Qwen3.6 27B* | 14,95 GiB | 15,66 GiB | −0,71 GiB (−4,5 %) |
| Qwen3 Coder 30B A3B | 16,00 GiB | 17,28 GiB | −1,28 GiB (−7,4 %) |
| Qwen3.6 35B A3B* | 19,00 GiB | 20,61 GiB | −1,61 GiB (−7,8 %) |
Gemessen: Größe der Gewichtsdateien auf Hugging Face am 27. Oktober 2026, in GiB (der Einheit unseres Modellfinders). MLX: mlx-community, 4-Bit-Versionen (affin, Gruppen zu 64; bei gpt-oss-20b die Version MXFP4-Q4). GGUF: unsloth, Q4_K_M (UD-Q4_K_M bei Qwen3.6 35B A3B, die Datei, die unser Katalog zählt). *Der MLX-Ordner dieser 3 enthält den Teil, der Bilder liest; bei GGUF ist das eine eigene Datei von 0,84–0,87 GiB, die Sie nur für Bilder brauchen. Auch der MLX-Ordner von Gemma 4 12B enthält einen kleinen Bild- und Audioteil; seine separate GGUF-Bilddatei hat 0,16 GiB.
MLX ist in 6 von 7 Fällen leichter, um 0,35 bis 1,61 GiB. Der Ausreißer, Qwen3.5 9B, bricht die Regel nicht: Sein MLX-Ordner trägt den Bildleser mit sich, und sobald Sie auf der GGUF-Seite die separate Bilddatei (0,86 GiB) dazurechnen, ist MLX auch hier leichter, um 9,9 %.
Welche antwortet „mit 4 Bit“ besser? Q4_K_M gibt mehr Bits aus, aber wie sich das in den Antworten zeigt, haben wir nicht gemessen, und die Größe einer Datei verrät es nicht. Sagen können wir Ihnen: Die 2 Etiketten „4-bit“ und „Q4“ beschreiben nicht dasselbe.
Was in Ihren Mac passt: dieselbe Rechnung, MLX meist auf der sicheren Seite
Unser Modellfinder und unsere Hardware-Seiten addieren die GGUF-Datei in Q4_K_M, den Speicher für den Kontext in der Länge, die Sie wählen, und einen Puffer für das Programm, und halten 3 GiB des gemeinsamen Speichers für macOS und Ihre offenen Apps frei. Diese Größen sind GGUF. Bei 6 der 7 Modelle oben wog die 4-Bit-MLX-Version weniger, bei diesen liegt die Rechnung des Modellfinders also auf der sicheren Seite, was die Datei betrifft; Qwen3.5 9B mit eingebautem Bildleser ist als MLX 0,25 GiB größer. Bei einem Modell, das wir nicht in beiden Formaten gemessen haben, prüfen Sie die Größe der MLX-Dateien, bevor Sie sich auf die GGUF-Rechnung verlassen.
Der Kontext kostet bei beiden gleich viel. mlx-lm hält seinen Kontext-Cache in voller Genauigkeit, solange Sie nicht --kv-bits verlangen, und llama.cpp hält ihn standardmäßig bei 16 Bit. Wie viel Speicher ein langes Gespräch braucht, hängt also vom Modell und von der Länge ab, nicht vom Format.
Einen Haken gibt es nur bei MLX. mlx-lm fragt macOS, wie viel Speicher es für den Grafikchip empfiehlt, und reserviert bis zu dieser Menge fest, und auf einem Mac mit 16 GB liegt diese Empfehlung deutlich unter den 13 GiB, die unsere Hardware-Seiten dem Modell lassen. Liegen die Gewichte über 90 % davon, warnt mlx-lm vor dem ersten Token; darüber wird alles langsam oder stürzt ab. Die echten Zahlen für einen Mac mit 16 GB, die Warnung und wie Sie die Grenze anheben, stehen in unserem Ratgeber zu MLX-Fehlern. Und wenn Sie lieber messen als rechnen: mlx_lm.generate gibt nach jeder Antwort Peak memory (in GB zu 10^9 Byte) aus, also das, was Modell und Gespräch auf Ihrem Mac tatsächlich belegt haben.
Ollama entscheidet für Sie: MLX auf dem Mac, GGUF überall sonst
Jetzt der kuriose Fund. Seit 0.40.0 kann ein Tag in Ollamas Katalog eine Liste mit 2 Versionen sein: einer MLX-Version aus safetensors und einer GGUF-Version. Im Code von 0.40.11 legt die Funktion runnerPreferences() die Reihenfolge fest: unter macOS mit Apple Silicon zuerst MLX, dann llama.cpp; auf jedem anderen System zuerst llama.cpp und MLX zuletzt. Beim Laden geht ein GGUF an den Server von llama.cpp selbst und ein MLX-Modell an Ollamas MLX-Runner.
Wir haben Ollamas Katalog nach 9 Tags gefragt, mit derselben Anfrage, die Ollama schickt, der, die eine Liste akzeptiert. 6 kamen mit 2 Versionen zurück, und das lädt jeder Rechner herunter:
| Tag | Mac mit Apple Silicon (MLX) | Windows, Linux, Intel-Mac (GGUF) |
|---|---|---|
qwen3.5:9b |
7,11 GiB | 6,10 GiB |
gemma4:e4b |
8,81 GiB | 6,13 GiB |
gemma4:12b |
7,18 GiB | 7,47 GiB |
qwen3.6:27b |
17,49 GiB | 16,55 GiB |
qwen3.6:35b |
21,98 GiB | 21,07 GiB |
flint:latest |
21,03 GiB | 21,29 GiB |
Gemessen: Summe der Schichten jeder Version in Ollamas Registry am 27. Oktober 2026, Bild- und Hilfsteile eingeschlossen. Die anderen 3 Tags, nach denen wir gefragt haben, qwen3:8b, gpt-oss:20b und qwen3-coder:30b, haben nur eine GGUF-Version, dieselbe Datei auf jedem Rechner.
Schauen Sie noch einmal hin: Bei 4 der 6 lädt der Mac die größere Datei, bis zu 2,68 GiB mehr bei gemma4:e4b. Der Grund: Ollamas MLX-Versionen sind nicht die 4-Bit-Versionen von mlx-community aus dem vorigen Abschnitt. Die meisten sind mit NVIDIAs Werkzeug ModelOpt in NVFP4 erstellt, einem eigenen 4-Bit-Format von NVIDIA, und einige lassen Teile des Modells bei 8 Bit oder mehr; die MLX-Version von Flint nutzt schlichte 4-Bit-Ganzzahlen. „MLX ist kleiner“ gilt also für die Dateien, die Sie selbst wählen, nicht für das, was Ollama für Sie wählt.

Tags mit nur einer GGUF-Version laufen auch auf dem Mac: Ollama gibt sie an llama.cpp weiter, das den Grafikchip über Metal nutzt. Die Engine wählen nicht Sie; die wählt das Tag. Ollamas MLX-Engine ist eigener Code, nicht mlx-lm, und unser Vergleich MLX vs. Ollama prüft, welche Modelle die beiden jeweils kennen.
Kompressionsstufen: 25 GGUF-Dateien gegen eine Handvoll MLX-Versionen
Hier gewinnt GGUF bei der Auswahl. Für Qwen3 8B bietet ein einziges GGUF-Repository 25 Dateien: die I-Quants von IQ1_S bis IQ4_NL, die K-Quants von Q2_K bis Q6_K, Q4_1, Q8_0 und BF16, dazu gemischte „XL“-Versionen. Mit dieser feinen Leiter bekommen Sie ein Modell genau in den Speicher, den Sie haben, Sprosse für Sprosse. Wie viel jede Sprosse wiegt, wie schnell sie schreibt und wie weit sie vom Original abweicht, haben wir in unserem Ratgeber zur GGUF-Quantisierung gemessen: Bei Qwen2.5 1.5B traf Q4_K_M bei 89 % der Tokens dieselbe erste Wahl wie das nicht quantisierte Modell.
Auf der MLX-Seite hat die Organisation mlx-community Qwen3 8B mit 3, 4, 6 und 8 Bit und in bf16, dazu ein paar spezielle 4-Bit-Versionen: AWQ und DWQ. DWQ ist der eigene Kniff von mlx-lm: Ein bereits komprimiertes Modell wird darauf trainiert, das Original nachzuahmen, so behält es die 4-Bit-Größe und versucht, einen Teil dessen zurückzuholen, was die Kompression gekostet hat. Wie viel es zurückholt, haben wir nicht gemessen.
Ein Modell selbst umzuwandeln, ist mit MLX einfacher. 1 Befehl lädt die Originalgewichte und komprimiert sie:
mlx_lm.convert --model Qwen/Qwen3-8B -q-q allein bedeutet 4 Bit in Gruppen zu 64, im Modus affine; --q-bits ändert die Bitzahl, --q-mode akzeptiert mxfp4, nvfp4 und mxfp8, und --quant-predicate nimmt 4 gemischte Rezepte von mixed_2_6 bis mixed_4_6. Für GGUF lassen Sie das Skript convert_hf_to_gguf.py aus dem Repository von llama.cpp laufen und danach seinen Quantisierer. In beiden Fällen laden Sie zuerst die Originalgewichte: rund 15 GiB für ein 8B-Modell in BF16.
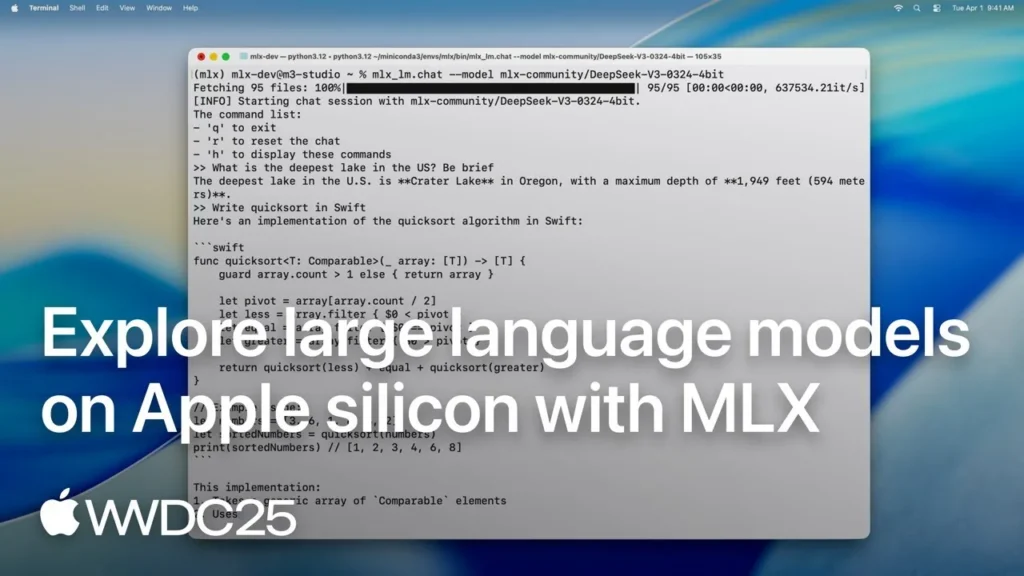
Wenn Sie es lieber erst sehen wollen: Apples Session zu großen Sprachmodellen mit MLX zeigt mlx-lm beim Erzeugen von Text und im Kapitel zur Quantisierung genau dieses mlx_lm.convert. Die Session wurde mit einer älteren mlx-lm aufgenommen: Wo ihre Optionen und diese Seite abweichen, folgt diese Seite der 0.32.2.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Geschwindigkeit: warum diese Seite keinen Sieger kürt
Wir würden Ihnen hier gern eine Zahl geben, und wir werden keine erfinden. Wir haben MLX nicht gegen llama.cpp auf einem eigenen Mac gemessen, und eine Geschwindigkeitsangabe bedeutet nur etwas, wenn Rechner, Modell, Kompression, Kontext und beide Versionen danebenstehen. Beide laufen auf demselben Grafikchip mit demselben Speicher, und MLX ist das Framework, das Apple für seine eigenen Chips baut; das ist ein Grund, es auszuprobieren, keine Messung.
Die gute Nachricht: Sie klären das auf Ihrem eigenen Mac mit 2 Läufen. mlx_lm.generate zeigt bei jedem Lauf die Token pro Sekunde fürs Lesen der Frage und fürs Schreiben der Antwort; geben Sie llama.cpp dasselbe Modell als GGUF und dieselbe Frage, und glauben Sie Ihrem Rechner mehr als jedem Diagramm, unseres eingeschlossen.
Wenn Sie Engines vor dem Ausprobieren nebeneinander sehen wollen: Dieser Test schickt 5 Modelle durch 3 Inferenz-Engines auf einem Mac mini M6. Seine Zahlen stammen von seinem Rechner und seinen Versionen, nicht von denen auf dieser Seite.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Portabilität, offene Türen und was jedes Programm sendet
Eine GGUF-Datei geht überallhin: Dieselbe Datei läuft in llama.cpp unter Windows, unter Linux, auf einem Intel-Mac oder einem Android-Handy, dazu in LM Studio und Ollama. Ein MLX-Ordner ist für Apple Silicon gemacht. Das Framework mlx gibt es auch für Linux mit CUDA oder nur auf dem Prozessor, und mlx-lm bietet dort die Extras cuda12, cuda13 und cpu, aber unter Windows installiert pip install mlx-lm die Werkzeuge ohne die Engine. Liegen Ihre Modelle auf einer Platte, die Sie mit einem PC teilen, funktioniert GGUF auf beiden.
Das Format selbst hört auf niemanden und sendet nichts: Das tut das Programm. Jedes öffnet eine andere Tür auf Ihrem Rechner, ab Werk alle nur auf dem Rechner selbst:
- mlx-lm:
mlx_lm.serverauf127.0.0.1:8080, ohne Schlüssel und mit CORS, das für jede Webseite offen ist. Von sich aus ruft es nichts auf; die Hugging-Face-Bibliothek, mit der es herunterlädt, fragt bei huggingface.co jedes Mal nach, ob sich ein Modell geändert hat, wenn Sie es über seinen Namen laden, bis SieHF_HUB_OFFLINE=1setzen. - llama.cpp:
127.0.0.1:9931seit v0.7.0, ohne Schlüssel, außer Sie ergänzen--api-key, CORS offen für jede Webseite, und von sich aus sendet es nichts. - LM Studio: sein Server auf
127.0.0.1:1234, CORS standardmäßig aus. Laut Hersteller sucht die App nach Updates und die Engines aktualisieren sich selbst; der Code ist geschlossen, mehr lässt sich von außen nicht sagen. - Ollama:
127.0.0.1:11434, CORS nur offen für Seiten auf localhost, 127.0.0.1 und 0.0.0.0. Mit nurollama serve2 Arten von Aufrufen an ollama.com, dieOLLAMA_NO_CLOUD=1abschaltet; mit der Desktop-App 4.

Jedes Ziel, mit Quelle und Datum, steht auf unseren Seiten zu MLX, llama.cpp, LM Studio und Ollama.
Was wir laden würden, je nach Profil
- Ein Mac mit Apple Silicon und ein Fenster zum Chatten: LM Studio, mit MLX-Versionen, wo es sie gibt. Meist bekommen Sie die kleinere Datei, und GGUF ist 1 Klick entfernt, wenn ein Modell keine MLX-Version hat.
- Ein Mac und das Terminal: mlx-lm mit den 4-Bit-Versionen von mlx-community; unsere Anleitung zur Einrichtung von MLX bringt Sie von der Installation bis zum Server.
- Ein Mac mit Ollama: Lassen Sie es wählen, aber rechnen Sie mit dem Download: Bei 4 der 6 Tags, die wir gemessen haben, ist seine MLX-Version die größere.
- Dieselben Modelle auf Mac und PC, oder ein Intel-Mac: GGUF, mit llama.cpp, LM Studio oder Ollama.
- Wenig Speicher, und das Modell muss aufs letzte Gigabyte passen: GGUF, wegen seiner Leiter aus 25 Dateien.
- Eigene Kompressionen oder Feintuning auf dem Mac: MLX, mit
mlx_lm.convertund seinem DWQ.
Falls unterwegs etwas hakt, haben wir Ratgeber für wenn MLX nicht funktioniert und wenn llama.cpp nicht funktioniert. Schwanken Sie eher zwischen Programmen als zwischen Dateien? Unsere Vergleiche LM Studio vs. Ollama und llama.cpp vs. Ollama stellen sie gegenüber, und der Modellfinder sagt Ihnen, welche Modelle in Ihren Mac passen. Wenn Sie direkt zwischen mlx-lm und llama.cpp wählen, zählt unser Vergleich MLX vs. llama.cpp, welche unserer 27 Modelle jede Engine kennt.