Auf einem Mac mit Apple Silicon nutzt Ollama bereits MLX: Bringt ein Tag seiner Bibliothek eine MLX-Version mit, lädt Ollama diese und führt sie mit einer eigenen Engine aus. Nehmen Sie Ollama für App, Bibliothek und API auf Port 11434. Nehmen Sie mlx-lm, um Modelle in MLX laufen zu lassen, die Ollamas Engine nicht kennt, für mlx-community-Builds und fürs Feintuning.
Dieser erste Satz verschiebt die Frage, und der Rest der Seite folgt daraus. Am 30. Oktober 2026 haben wir den Code von Ollama 0.40.13 und mlx-lm 0.32.2 gelesen, die 27 Modelle, die unser Modellfinder an diesem Tag hatte, gegen beide geprüft und Ollamas Bibliothek gefragt, welche Version ein Mac bei 9 ihrer Tags bekommt. Ein Rennen mit der Stoppuhr haben wir nicht veranstaltet, deshalb gibt es hier keinen Tempo-Sieger; weiter unten steht, wie Sie das auf Ihrem eigenen Mac klären.
 MLX (mlx-lm)Programm-Datenblatt
 OllamaProgramm-Datenblatt
| mlx-lm | Ollama | |
|---|---|---|
| Was es ist | Apples Python-Paket, um Sprachmodelle mit MLX auszuführen und feinzutunen | Eine App und ein Server, die Modelle aus der eigenen Bibliothek laden und mit MLX oder llama.cpp ausführen |
| Version am 30. Oktober 2026 | mlx-lm 0.32.2, das mlx 0.32.4 installiert | Ollama 0.40.13 |
| Welches MLX drinsteckt | Apples Paket mlx, die stabile 0.32.4 | Eine eigene, in Go geschriebene Engine auf der C-Schnittstelle von MLX, gebaut mit einem mlx-Stand vom 25. Oktober 2026, 31 Änderungen nach der 0.32.4 |
| Modelle unseres Katalogs, die sein MLX-Code kennt (27 am 30. Oktober 2026) | 22 | 17 |
| Woher die Modelle kommen | Hugging Face: mlx-community-Builds oder Ihre eigene Konvertierung | Die eigene Bibliothek (ollama pull) oder Ihr eigener safetensors-Ordner oder Ihre GGUF-Datei, importiert mit ollama create |
| GGUF | Liest es nicht | Ja, mit llama.cpp, bei Tags ohne MLX-Version |
| Installation | pip install mlx-lm, nur im Terminal |
Desktop-App oder ein Einzeiler-Skript |
| Lokaler Server | mlx_lm.server auf 127.0.0.1:8080, Routen im OpenAI-Stil |
127.0.0.1:11434: eigene API plus Routen im OpenAI- und Anthropic-Stil |
| Feintuning | LoRA mit mlx_lm.lora |
Nein; und 0.40.13 lehnt LoRA-Adapter beim Erstellen eines Modells ab |
| Was es von selbst sendet | Nichts; die Hugging-Face-Bibliothek, mit der es lädt, prüft auf Modell-Updates | 2 Arten von Aufrufen an ollama.com nur mit dem Server, 4 mit der Desktop-App |
| Lizenz | MIT | MIT |
| Tempo | Von uns nicht gemessen | Von uns nicht gemessen |
Ollama führt auf Ihrem Mac schon MLX aus, aber es ist nicht mlx-lm
Seit Ollama 0.40.0 kann ein Tag in der Bibliothek 2 Versionen tragen: eine in safetensors für MLX und eine in GGUF für llama.cpp. Auf einem Mac mit Apple Silicon setzt der Code MLX an die erste Stelle; gibt es beide, bekommt Ihr Mac die MLX-Version. Ausgeführt wird sie aber nicht von mlx-lm. Ollama hat eine eigene MLX-Engine, in Go geschrieben, die über die C-Schnittstelle mit MLX spricht: kein Python, kein mlx-lm-Paket und für jede Modellfamilie eigener Code.
Auch das MLX darunter ist nicht ganz dasselbe. Ollama 0.40.13 wird mit einem Entwicklungsstand von Apples mlx vom 25. Oktober 2026 gebaut, 31 Änderungen nach der stabilen 0.32.4. mlx-lm 0.32.2 verlangt mlx 0.32.2 oder neuer, also installiert Ihnen pip heute die stabile 0.32.4. Dasselbe Gerüst, 11 Tage auseinander, und darauf 2 verschiedene Sätze Modellcode.
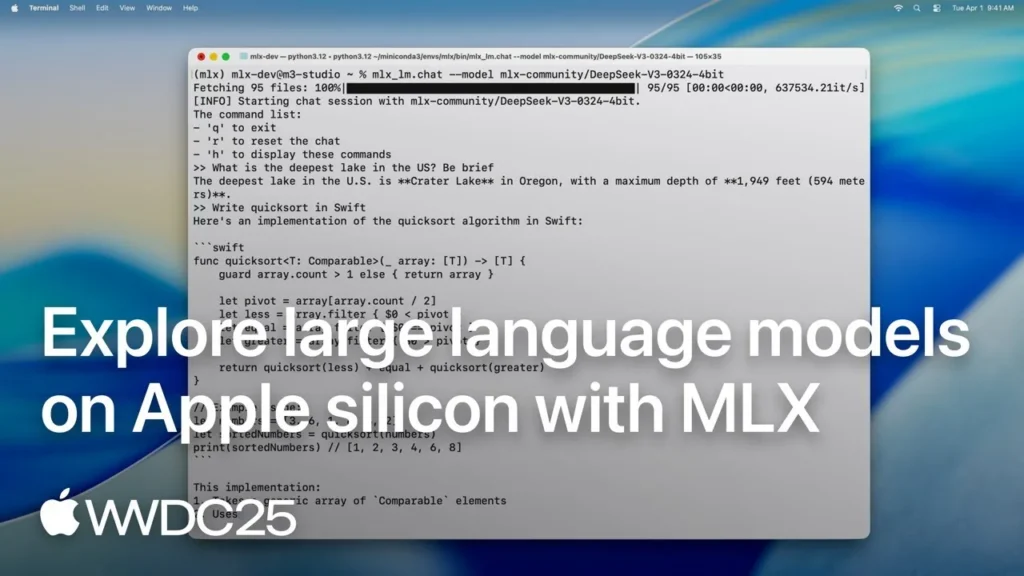
„MLX vs. Ollama“ heißt also eigentlich: das MLX von mlx-lm gegen das MLX von Ollama. Das hat 2 Folgen, die Sie merken: Ein Modell, das der eine unterstützt, unterstützt der andere nicht automatisch, und eine Tempo-Zahl vom einen sagt wenig über den anderen.
Welche Modelle jeder ausführt: die 27, die wir gegen beide geprüft haben
Wir haben die 27 Modelle genommen, die unser Modellfinder am 30. Oktober 2026 hatte, die Architektur gelesen, die jedes in seiner config.json auf Hugging Face angibt, und sie im Code beider nachgeschlagen: Ollamas MLX-Engine wählt ihren Modellcode nach diesem Namen, und mlx-lm braucht eine Datei für den Modelltyp.
| Wer es kennt | Modelle |
|---|---|
| Beide (14) | Qwen3 1.7B, Qwen3 4B 2507, Qwen3 8B, Qwen3.5 9B, Qwen3.6 27B, Qwen3.8 27B, Qwen3.6 35B A3B, Gemma 4 E2B, E4B, 12B, 26B A4B und 31B, Muse Glimmer 30B, Nemotron 3.5 Lightning 30B |
| Nur mlx-lm (8) | Qwen3 Coder 30B, gpt-oss-20b, gpt-oss-120b, GLM-5.2, Mistral Small 24B, Llama 4 Scout, Granite 4.2 8B, Phi-4 |
| Nur Ollamas MLX-Engine (3) | Flint, Qwen3.8 Flash Next, Nemotron 3.5 Super 120B |
| Keiner (2) | DeepSeek V4 Flash, GLM-5.3 Flash |
Gelesen im Code von mlx-lm 0.32.2 und Ollama 0.40.13 am 30. Oktober 2026, abgeglichen mit der config.json jedes Modells auf Hugging Face. Das ist Unterstützung im Code, kein Testlauf: Wir haben die 27 nicht auf einem Mac geladen.
„Nur mlx-lm“ heißt nicht, dass Ollama das Modell gar nicht ausführen kann. Am 30. Oktober 2026 standen phi4:14b, gpt-oss:20b und qwen3-coder:30b mit nur einer GGUF-Version in Ollamas Bibliothek; auf einem Mac führt Ollama sie also mit llama.cpp aus, über Metal auf dem Grafikchip. Wollen Sie diese Modelle in MLX, ist mlx-lm der Weg. Und umgekehrt: Wenn Sie Flint, Qwen3.8 Flash Next oder Nemotron 3.5 Super in MLX suchen, hat mlx-lm 0.32.2 dafür noch keinen Code, Ollamas Engine schon.

Die Engine kann, das Tag entscheidet
Eine Architektur zu kennen reicht Ollama nicht: Das Tag muss eine MLX-Version mitbringen. Qwen3 8B ist das deutlichste Beispiel. Ollamas MLX-Engine hat den Code dafür, aber am 30. Oktober 2026 hatte das Tag qwen3:8b nur eine GGUF-Version, also läuft es auf einem Mac mit llama.cpp. Am selben Tag brachten qwen3.5:9b, qwen3.6:27b, gemma4:e4b, gemma4:12b und flint:latest beide Versionen mit, und ein Mac bekommt die MLX-Version.
Bei mlx-lm gibt es keine solche Liste: Sie wählen das genaue Repository auf Hugging Face, etwa einen 4-Bit-Build von mlx-community, oder konvertieren die Originalgewichte selbst mit mlx_lm.convert. Ollamas MLX-Versionen sind eigene Builds und wiegen nicht immer so viel wie die von mlx-community; unser Vergleich MLX vs. GGUF misst die Größen Tag für Tag.
Ollama hat hier 2 eigene Türen, die wir im Code der 0.40.13 gelesen und nicht getestet haben. ollama create importiert einen safetensors-Ordner als MLX-Version, und die Option --quantize komprimiert ihn dabei auf nvfp4, mxfp4, int4, mxfp8 oder int8. Und pull und run akzeptieren die versteckte Option --runner, um eine der 2 Versionen eines Tags anzufordern. Versteckte Optionen können sich ohne Vorwarnung ändern.
Server: Port 11434 oder 8080, und die Überraschung mit 512 Tokens
Beide öffnen ab Werk einen Server nur auf Ihrem eigenen Rechner, ohne Schlüssel. Ollama lauscht auf 127.0.0.1:11434 und spricht 3 Dialekte: die eigene API (/api/chat), den OpenAI-Stil (/v1/chat/completions und /v1/responses) und den Anthropic-Stil (/v1/messages). Ein Modell bleibt 5 Minuten nach der letzten Anfrage geladen (OLLAMA_KEEP_ALIVE ändert das), und von Webseiten nimmt Ollama ab Werk nur Aufrufe von Seiten an, die auf localhost, 127.0.0.1 oder 0.0.0.0 laufen (dazu app://, tauri://, file:// und Code-Editoren; OLLAMA_ORIGINS fügt weitere hinzu).
mlx_lm.server lauscht auf 127.0.0.1:8080, nur im OpenAI-Stil (/v1/chat/completions, /v1/completions und /v1/models), nimmt Aufrufe von jeder Webseite an und warnt bei jedem Start, dass er nicht für den Produktivbetrieb gedacht ist. Er hält 1 Modell im Speicher und tauscht es aus, wenn eine Anfrage ein anderes beim Namen nennt. Wenn das Modell es erlaubt, bündelt er Anfragen: ab Werk bis zu 32 Antworten und 8 Prompts gleichzeitig.
Speicher: Beide stellen macOS dieselbe Frage
macOS sagt jedem Programm, wie viel Speicher es für den Grafikchip empfiehlt, und beide lesen diese Zahl. mlx-lm setzt sein Limit für fest reservierten Grafikspeicher auf die gesamte Empfehlung. Ollamas MLX-Engine setzt dieses Limit auf das, was das geladene Modell belegt, höchstens auf die Empfehlung, und schreibt eine Warnung ins Log, wenn das Modell über der Empfehlung liegt: Ab da kann die Leistung leiden.
Keiner der beiden Kniffe macht ein Modell kleiner. Ob es passt, hängt von der Datei, dem gewünschten Kontext und Ihrem Speicher ab, und unser Modellfinder rechnet das für Ihren Mac aus. Wenn Sie auf einem Mac mit 16 GB mit mlx-lm an die Decke stoßen, stehen in unserem Ratgeber zu MLX-Fehlern die echten Zahlen und wie Sie die Decke anheben.
Wollen Sie Ollama vorher auf dem günstigsten Mac mini M4 sehen, dem mit 16 GB, zeigt dieser Test (auf Spanisch) es genau dort und schaut, welche Modelle laufen und ab wann er auslagert. Seine Zahlen stammen von seiner Maschine und seinen Versionen, nicht von denen auf dieser Seite.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Was nur mlx-lm kann: Feintuning und eigene Builds
Hier spielt mlx-lm in einer eigenen Liga. mlx_lm.lora tunt ein Modell mit LoRA auf Ihrem Mac, mlx_lm.fuse verschmilzt das Ergebnis mit dem Modell. mlx_lm.convert komprimiert die Originalgewichte, und mlx_lm.dwq, mlx_lm.awq und mlx_lm.gptq sind weitere Kompressionswege, die weniger Qualität verlieren sollen. mlx_lm.evaluate, mlx_lm.perplexity und mlx_lm.benchmark messen, was Sie gebaut haben. Ollama trainiert nichts, und 0.40.13 nimmt auch keine neuen LoRA-Adapter mehr an: ollama create antwortet „LoRA adapters are no longer supported“.
Beide können eine Antwort mit einem kleinen Entwurfsmodell beschleunigen, das vorausrät. mlx-lm nimmt mit --draft-model jedes passende Modell. Ollama 0.40.13 kann auf seiner MLX-Engine auch eines nutzen, wenn das Tag es mitbringt oder Sie es mit einer DRAFT-Zeile in ollama create hinzufügen; welche Tags der Bibliothek eines haben, haben wir nicht geprüft. Und Ollama behält den Komfort: Desktop-App, eine Bibliothek, in der 1 Befehl ein Modell lädt und startet, und eine API, die Apps für Ollama, OpenAI oder Anthropic aufrufen können.
Apples eigene Sicht zeigt die WWDC26-Session „Run local agentic AI on the Mac using MLX“, die offizielle Quelle (auf Englisch). Die Session wurde mit ihren eigenen Versionen aufgezeichnet: Wo sie und diese Seite bei einer Option auseinandergehen, folgt diese Seite mlx-lm 0.32.2.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Tempo, und was jeder sendet
Wir würden Ihnen gern eine Zahl nennen, und wir erfinden keine. Beide teilen sich Apples Gerüst, aber weder die Version noch den Modellcode, also ist der einzige faire Test Ihr eigener: gleiches Modell, gleiche Kompression, gleicher Prompt. ollama run qwen3.6:27b --verbose zeigt nach jeder Antwort das Tempo beim Lesen des Prompts und beim Schreiben in Tokens pro Sekunde, und mlx_lm.generate macht das von selbst. Nehmen Sie ein Tag mit MLX-Version, sonst stoppen Sie llama.cpp: Im Code der 0.40.13 ergänzt ollama show eine Zeile runner, wenn ein Tag 2 Versionen hat.

Im Netz macht mlx-lm von sich aus keine Aufrufe; die Hugging-Face-Bibliothek, mit der es lädt, fragt bei huggingface.co nach, ob sich ein Modell geändert hat, sooft Sie es beim Namen laden, bis Sie HF_HUB_OFFLINE=1 setzen. Ollama macht mit nur ollama serve 2 Arten von Aufrufen an ollama.com, die OLLAMA_NO_CLOUD=1 abschaltet; mit der Desktop-App 4, und die Update-Prüfung lässt sich nicht abschalten. Jedes Ziel steht mit Quelle und Datum auf unseren Seiten zu MLX und Ollama. Beide sind Open Source unter MIT, also kann jeder nachlesen, was wir gelesen haben.
Was wir nehmen würden, je nach Fall
- Erste Schritte auf dem Mac, und Sie wollen heute chatten: Ollama. MLX bekommen Sie ungefragt, sobald das Tag es mitbringt. Unser Ratgeber zur Ollama-Installation führt Sie durch.
- Eine App oder ein Agent, der Ollamas oder Anthropics API spricht: Ollama, auf Port 11434.
- Phi-4, gpt-oss, Qwen3 Coder 30B, Mistral Small oder Granite in MLX: mlx-lm. Ollamas MLX-Engine kennt sie nicht; in Ollama laufen sie mit llama.cpp, sofern die Bibliothek sie hat (geprüft bei
phi4:14b,gpt-oss:20bundqwen3-coder:30b). - Flint, Qwen3.8 Flash Next oder Nemotron 3.5 Super in MLX: Ollama, dessen Engine den Code hat; mlx-lm 0.32.2 hat ihn nicht.
- Feintuning, eigene Kompressionen oder ein bestimmter mlx-community-Build: mlx-lm; unser Ratgeber zur MLX-Installation bringt Sie von der Installation bis zum Server.
- Beide: mlx-lm und Ollama lassen sich parallel installieren und lauschen auf verschiedenen Ports (8080 und 11434), aber jeder hält seine eigene Kopie eines Modells, und 2 geladene Modelle addieren sich im Speicher.
Hakt es unterwegs, haben wir Ratgeber für wenn MLX nicht funktioniert und wenn Ollama nicht funktioniert. Schwanken Sie noch zwischen anderen Programmen? Unsere Vergleiche LM Studio vs. Ollama und llama.cpp vs. Ollama helfen weiter. Sie schwanken zwischen mlx-lm und llama.cpp, ohne App darüber? Unser Vergleich MLX vs. llama.cpp prüft, welche Modelle unseres Katalogs jede Engine kennt.