Nehmen Sie LM Studio, wenn Sie ein Fenster wollen: Modell suchen, laden und chatten, ohne Terminal und mit einem Server, der ab Werk dicht ist. Nehmen Sie llama.cpp, wenn Sie offenen Code, die neueste Engine am Tag ihres Erscheinens und null Datenversand wollen. Darunter steckt dieselbe Engine: LM Studio führt GGUF-Modelle auf seinem eigenen llama.cpp-Build aus.
Genau dieser letzte Satz macht den Vergleich spannend, und wir haben nachgeprüft, wie weit er trägt. LM Studio 0.4.26 ist die Version, die sein Download-Dienst am 27. Oktober 2026 auslieferte (Build 0.4.26-4), und weder Version 0.4.27 (29. Oktober) noch 0.4.28 (31. Oktober, die er am 5. November 2026 ausliefert) nennt in ihrem Changelog eine neue llama.cpp-Runtime; die stabile Version von llama.cpp ist v0.9.0 vom 4. November 2026. Den Code von llama.cpp haben wir überall dort gelesen, wo er über Speicher, parallele Anfragen, Netzwerk und Ihre Privatsphäre entscheidet. Der Code von LM Studio ist geschlossen; dort berichten wir, was der Hersteller schreibt, und sagen das jedes Mal dazu. Mit der Stoppuhr haben wir sie nicht gegeneinander antreten lassen, einen Sieger beim Tempo gibt es hier also nicht: Mit derselben GGUF-Datei auf llama.cpp hängt das Tempo vom Build der Engine und von den Einstellungen ab, und genau da unterscheiden sich die beiden.
 LM StudioProgramm-Datenblatt
 llama.cppProgramm-Datenblatt
| LM Studio | llama.cpp | |
|---|---|---|
| Was es ist | Eine Desktop-App mit Modellsuche, Chat und Server, aufgebaut auf Engines | Die Engine selbst, mit Server, Terminal-Chat und Chat-Seite |
| Version am 5. November 2026 | 0.4.28 (Download 0.4.28-2) | v0.9.0 (Build b12110, 4. November), dazu tägliche Builds (b12125 am 5. November) |
| llama.cpp im Inneren | Runtime 2.50.0 auf Basis von b11337 (2. Oktober 2026), wie mit 0.4.26 ausgeliefert; die Changelogs von 0.4.27 und 0.4.28 nennen keine neuere | Es ist llama.cpp: stabiler Kanal oder jeder tägliche Build |
| Code und Lizenz | Geschlossen; kostenlos privat und im Job, Weiterverkauf als Dienst verboten. Kommandozeile lms, SDKs und MLX-Engine unter MIT |
Open Source, MIT |
| Läuft auf | Windows x64 (mit AVX2) und ARM64, macOS 14+ auf Apple Silicon, Linux x64 und ARM64. Kein Intel-Mac | Windows, macOS, Linux und Android; Builds für CPU, CUDA, ROCm, Vulkan, Metal, SYCL und OpenVINO. Intel-Mac auf dem Prozessor |
| Modelldateien | GGUF und MLX; Sie wählen in der Suche | GGUF; Safetensors erst nach Umwandlung |
| Anfragen gleichzeitig, ab Werk | 4 (Max Concurrent Predictions; llama.cpp- und MLX-Engine) | 4, die sich einen Pool an Kontextspeicher teilen |
| Kontext ab Werk | Nicht veröffentlicht; Sie legen ihn beim Laden fest | Das Maximum des Modells, gekürzt auf das, was passt (nie unter 4.096 Token) |
| Modell im Leerlauf | Per API bei Bedarf geladene Modelle werden nach 60 Minuten entladen; mit lms load geladene bleiben |
Bleibt geladen, bis Sie den Server stoppen |
| Fenster | Vollständige Desktop-App; llmster ohne Fenster |
Eine Chat-Seite im Browser, ab Werk an |
| Lauscht auf | 127.0.0.1:1234 |
127.0.0.1:9931 (8080 bis v0.6.0) |
| Schlüssel und CORS | Optionaler Schlüssel mit Berechtigungen (Require Authentication); CORS aus | Optionaler Schlüssel (--api-key); CORS offen für jede Webseite |
| Sendet von selbst | Laut Hersteller 2 Dinge: Update-Prüfung und Engine-Updates (nur Letztere abschaltbar). Nicht überprüfbar | Nichts |
Dieselbe Engine: welches llama.cpp in LM Studio 0.4.26 steckt
LM Studio schreibt für GGUF-Dateien keine eigene Engine. Es verpackt llama.cpp in eine sogenannte Runtime mit eigener Versionsnummer, und sein Changelog nennt, auf welchem llama.cpp jede davon aufbaut. Version 0.4.26, verfügbar seit dem 8. Oktober 2026, brachte die Runtime 2.50.0 auf Basis des llama.cpp-Builds b11337, eines täglichen Builds vom 2. Oktober 2026. Auf Macs mit Apple Silicon gibt es eine zweite Engine, MLX, die LM Studio offen unter MIT-Lizenz entwickelt; und seit 0.4.25 eine dritte, Splash, für M3 oder neuer ab macOS 26.4, was wir nur nach Herstellerangabe wiedergeben können, weil die App geschlossen ist.

Und jetzt das Kuriose. Am 5. November 2026 ist das stabile llama.cpp, v0.9.0, Build b12110 vom 4. November: 773 Builds weiter als das in LM Studio 0.4.26 (mit v0.8.0, der stabilen Version bis zum 4. November, waren es 623). Dazu steigt die Build-Nummer von llama.cpp um rund 21 am Tag; rund 13 davon erscheinen als tägliche Builds (vom 28. Oktober bis zum 5. November 2026), und am 5. November ist der neueste b12125. Wenn also eine neue Modellfamilie in llama.cpp landet, ist llama.cpp pur der schnellste Weg, sie auszuprobieren. LM Studio zieht nach, aber in seinem eigenen Takt.
Fairerweise ein Punkt für LM Studio: Seine Engines aktualisieren sich selbst, ab Werk an und in den App-Einstellungen abschaltbar. Das llama.cpp in Ihrem LM Studio kann also neuer sein als 2.50.0; welche Runtime Sie haben, zeigt Ihnen die App. Dieses Video zeigt, wie Sie LM Studio und seine llama.cpp-Engines unter Windows aktualisieren; es wurde mit einer anderen Version aufgenommen, wo es abweicht, gilt diese Seite.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken.
Fenster oder Terminal: Installation und erste Antwort
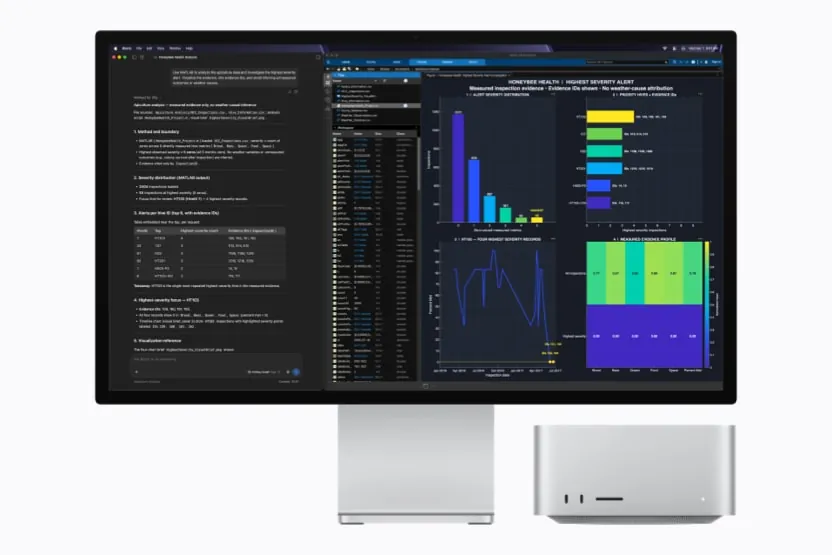
LM Studio ist ein ganz normaler Installer: eine .dmg auf dem Mac, eine .exe unter Windows, ein AppImage oder ein .deb unter Linux. Danach 3 Schritte in der App und keiner im Terminal: Modell im Tab Discover suchen und herunterladen, laden, chatten. Wollen Sie es ohne Fenster, auf einem Server oder Mini-PC, gibt es llmster, einen Dienst ohne Oberfläche, den Sie mit der Kommandozeile lms steuern.
llama.cpp verlangt vorher eine Entscheidung: welcher Build. Der entspannte Weg ist brew install llama.cpp, das Ihnen auf Mac und Linux die stabile v0.9.0 gibt (Homebrew liefert sie seit dem 5. November 2026 aus). Die Release-Seite auf GitHub veröffentlicht Builds pro System und Grafikkarte, und Sie nehmen den, der zu Ihrer passt. Dann 1 Befehl:
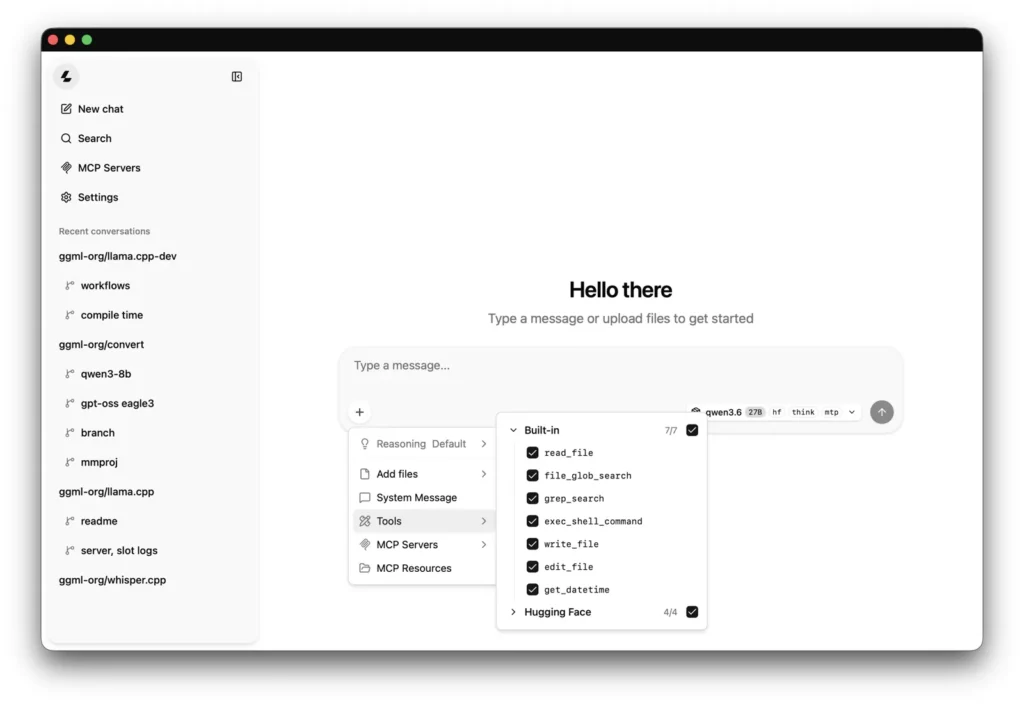
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF -c 8192Er lädt das Modell von Hugging Face und öffnet den Server und eine Chat-Seite unter http://127.0.0.1:9931. Diese Seite ist die Antwort von llama.cpp auf das Fenster von LM Studio: Ihre Unterhaltungen und seit v0.7.0 eine Modellverwaltung, alles im Browser. Die Chats liegen im Speicher des Browsers; wenn Sie die Website-Daten löschen, sind sie weg. LM Studio legt sie als JSON-Dateien in ~/.lmstudio/conversations/ ab.
Unsere Anleitung für LM Studio und die für llama.cpp gehen Schritt für Schritt vor. Bei der Hardware hat llama.cpp die längere Liste: Es läuft sogar auf einem Intel-Mac, nur auf dem Prozessor, und auf Android-Handys. Für Intel-Macs gibt es LM Studio gar nicht, und unter Windows x64 braucht es einen Prozessor mit AVX2.
Welche Datei Sie ausführen, und wer sie auswählt
Beide lesen GGUF, das Format, das llama.cpp geschaffen hat. Der Unterschied liegt darin, wie die Datei zu Ihnen kommt.
Die Suche von LM Studio zeigt GGUF und MLX nebeneinander, und Sie wählen; auf einem Mac mit Apple Silicon können Sie beides haben. Die Modelle landen in ~/.lmstudio/models/, und lms import fügt ein anderswo geladenes GGUF hinzu. llama.cpp liest nur GGUF: Ein Modell in Safetensors müssen Sie zuerst mit dem Skript convert_hf_to_gguf.py umwandeln. Mit -hf holt es das Modell von Hugging Face, wählt die Kompression Q4_K_M, wenn Sie keine andere nennen, und legt die Datei im Standard-Cache von Hugging Face ab.
Auf dem Mac ist die Formatwahl eine eigene Frage, und unser Vergleich MLX vs. GGUF misst 7 Modelle in beiden. Und wenn Sie lieber ohne App direkt die Engine wählen, stellt unser Vergleich MLX vs. llama.cpp mlx-lm und llama.cpp nebeneinander.
4 Anfragen gleichzeitig bei beiden, und der Kontext
Hier sind sie sich einiger, als man denkt. Starten Sie llama serve, und es öffnet 4 Slots: Im Code von v0.9.0 steht die Zahl der Slots wie in v0.8.0 ab Werk auf auto, und auto heißt 4, mit einem gemeinsamen Pool an Kontextspeicher für alle. Mit -c 8192 bekommen Sie 8.192 Token für die 4 zusammen. -np setzt eine andere Zahl.
Die Dokumentation von LM Studio nennt dieselbe Zahl: Max Concurrent Predictions steht ab Werk auf 4, also werden bis zu 4 Anfragen gemeinsam verarbeitet, statt in der Warteschlange zu stehen. Die Einstellung sitzt in den erweiterten Optionen des Modell-Laders und gilt für die llama.cpp-Engine und seit 0.4.2 (Februar 2026) auch für die MLX-Engine; 0.4.13 (Mai 2026) hat sie auf MLX-Modelle mit Bildverständnis erweitert. Wie LM Studio den Speicher auf diese 4 verteilt, ist nicht veröffentlicht, und den geschlossenen Code können wir nicht lesen.
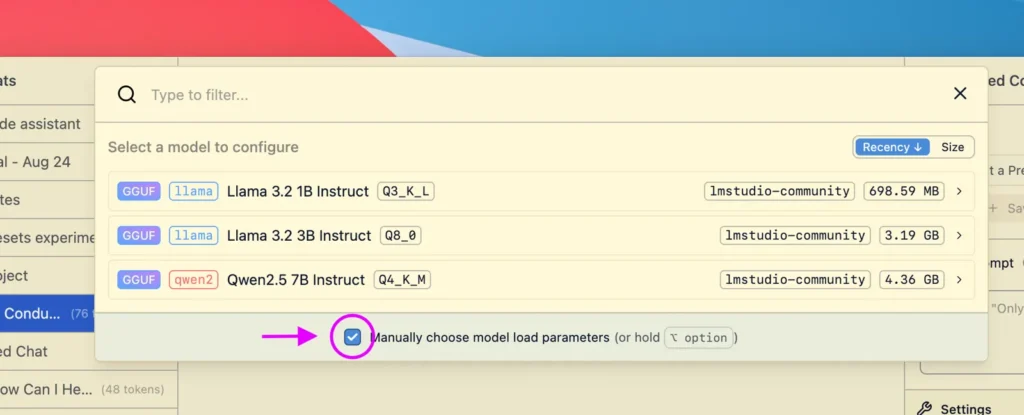
Beim Kontext trennen sich die Wege. llama.cpp fängt oben an: Die Kontextgröße steht ab Werk auf dem längsten Kontext, mit dem das Modell trainiert wurde, und ein Mechanismus namens --fit, ab Werk an, kürzt ihn bis auf eine Untergrenze von 4.096 Token und schiebt Schichten in den Arbeitsspeicher, bis das Modell passt, mit dem Ziel, auf jedem Gerät 1.024 MiB frei zu lassen. LM Studio veröffentlicht seinen Standardwert nicht; Sie sehen und ändern die Zahl im Lader oder mit lms load --context-length. Unser Rat gilt für beide: Schreiben Sie die Zahl selbst hin, dann wissen Sie, was Sie bekommen.
Auch der Speicher nach der Antwort verhält sich anders. llama-server hält das Modell geladen, bis Sie ihn stoppen; --sleep-idle-seconds schickt es nach einer Weile schlafen. In LM Studio werden per API bei Bedarf geladene Modelle nach 60 Minuten ohne Anfrage entladen, und wer so ein neues lädt, wirft das vorherige raus.
Welche Türen offen sind: 127.0.0.1:1234 gegen 127.0.0.1:9931
Zuerst die gute Nachricht: Beide lauschen ab Werk nur auf Ihrem eigenen Rechner. LM Studio wartet auf 127.0.0.1:1234, llama.cpp v0.9.0 auf 127.0.0.1:9931 (bis v0.6.0 war es 8080, und die Docker-Images des Projekts nutzen im Container weiter 8080). Niemand in Ihrem WLAN erreicht einen der beiden, bis Sie ihn absichtlich öffnen: Serve on Local Network oder lms server start --bind 0.0.0.0 bei LM Studio, --host 0.0.0.0 bei llama.cpp. Nebeneinander laufen sie problemlos: verschiedene Ports, kein Konflikt.
Der Unterschied ist CORS, das entscheidet, welche Webseiten einen lokalen Server aus Ihrem Browser heraus nutzen dürfen, und hier starten beide an entgegengesetzten Enden. LM Studio lässt CORS aus, solange Sie nicht Enable CORS einschalten oder den Server mit --cors starten. llama.cpp spiegelt ab Werk jede Herkunft zurück und erlaubt Anmeldedaten: Eine Webseite, die Sie besuchen, kann also Anfragen an Ihren llama-server schicken und die Antworten lesen, solange er läuft; der Server warnt beim Start mit security: no API key is set and CORS allows all origins.
Beide können einen Schlüssel verlangen. LM Studio hat seit 0.4.0 Require Authentication, mit Tokens, die Berechtigungen tragen; ab Werk ist es aus. llama.cpp hat --api-key, die Variable LLAMA_API_KEY und --api-key-file für mehrere. Ein Haken bei llama.cpp: Der Schlüssel ändert nichts an CORS. Zu macht es --cors-origins localhost.

Was jeder sendet, und was Sie überprüfen können
Hier gewinnt llama.cpp klar, und Sie müssen uns nicht glauben: Der Code ist öffentlich. Wir haben seine Engine, den Server, den Terminal-Chat und die Chat-Seite nach Analyse, Telemetrie und Tracking durchsucht und nichts gefunden. v0.8.0 hat 2 neue Wege nach draußen mitgebracht, die v0.9.0 unverändert beibehält, beide aus, bis Sie sie einschalten: --connect, experimentell, öffnet über ein separates Programm, llama-connect, einen Peer-to-Peer-Tunnel zu Ihrem Server; und die Option Discover Models der Chat-Seite: Sobald Sie sie in den Einstellungen anhaken, fragt Ihr Browser Hugging Face ab, dazu den Modellkatalog des Projekts auf llama.app (laut Hilfetext ist sie für den Router-Modus gedacht, wenn der Server ohne festes Modell startet). llama.cpp selbst sucht nicht nach Updates und hat kein Konto. Online geht es nur, wenn Sie es wollen: Modell-Downloads mit -hf, llama download oder --model-url, als Container-Image verpackte Modelle mit --docker-repo und llama update bei Installationen über das Skript des Projekts. Liegen die Modelle auf der Platte, verbietet --offline jeden Download.
LM Studio sagt, es habe keine Telemetrie, und nach eigener Darstellung gehen 2 Dinge von selbst raus: Die App prüft auf Updates (laut Datenschutzerklärung erhält der Hersteller dabei App-Version und Build, Betriebssystem und IP-Adresse), und die Engines aktualisieren sich selbst, ab Werk an und in den Einstellungen abschaltbar. Die Suche in Discover erreicht Hugging Face, aber nur, wenn Sie sie benutzen; Hub, Websuche und Cloud-Funktionen brauchen ein Konto. Ist das alles? Das können wir Ihnen nicht sagen: Der Code ist geschlossen und die Nutzungsbedingungen verbieten Reverse Engineering, also kann niemand außerhalb der Firma es prüfen. Das ist der Preis für das Fenster.
Die Lizenz folgt derselben Linie. llama.cpp steht unter MIT: lesen, ändern, in Ihr eigenes Produkt einbauen. LM Studio ist nach seinen Bedingungen privat und im Job kostenlos, darf aber nicht als Dienst weiterverkauft werden. Jedes Ziel mit Quelle und Datum steht auf unserer Seite zu LM Studio und unserer Seite zu llama.cpp.
Was wir installieren würden, je nach Fall
- Zum ersten Mal lokale KI, und kein Terminal: LM Studio. Suchen, laden, chatten, und ein Server, der ab Werk dicht ist.
- Ein Mac mit Apple Silicon: LM Studio, das auch MLX-Modelle ausführt; llama.cpp liest nur GGUF.
- Ein Modell, das diese Woche erschienen ist: ein täglicher Build von llama.cpp, der neue Modellfamilien vor der Runtime von LM Studio bekommt.
- Nichts darf den Rechner verlassen, und Sie wollen es prüfen: llama.cpp mit
--offline. Nur offener Code lässt sich überprüfen. - Ein Produkt oder Dienst, der darauf aufbaut: llama.cpp, MIT; die Bedingungen von LM Studio verbieten den Weiterverkauf als Dienst.
- Ein Intel-Mac oder ein Android-Handy: llama.cpp, das einzige der 2, das dort läuft.
- Beide: kein Problem. Verschiedene Ports, 1234 und 9931, und dieselbe GGUF-Datei dient beiden.
Wenn unterwegs etwas schiefgeht, haben wir eine Anleitung für den Fall, dass LM Studio nicht funktioniert, und eine, wenn llama.cpp nicht funktioniert. Schwanken Sie auch bei Ollama? Unsere Vergleiche LM Studio vs. Ollama und llama.cpp vs. Ollama decken das ab, und der Modellfinder sagt Ihnen, welche Modelle auf Ihren Rechner passen.