Auf einem Mac mit Apple Silicon rechnen beide über Metal auf dem Grafikchip. Nehmen Sie llama.cpp für die größte Auswahl: Version 0.8.0 hat Code für 27 der 28 Modelle unseres Katalogs, mlx-lm 0.32.2 für 22, und für jedes der 28 liegt eine fertige GGUF-Datei bereit. Nehmen Sie mlx-lm für MLX-Fassungen, Python und LoRA-Feintuning.
Das ist die kurze Antwort, und sie gefällt uns, weil sie aus dem Code stammt und nicht aus dem Bauch. Am 30. Oktober 2026 haben wir die stabilen Versionen beider Projekte gelesen, die 27 Modelle, die unser Modellfinder an dem Tag kannte, mit ihrem Code abgeglichen und Server, Werkseinstellungen und das, was jedes Programm von sich aus sendet, nebeneinandergelegt. Mit der Stoppuhr haben wir sie nicht gemessen, einen Tempo-Sieger gibt es hier also nicht; gegen Ende steht, wie Sie das auf Ihrem eigenen Mac klären.
 MLX (mlx-lm)Programm-Datenblatt
 llama.cppProgramm-Datenblatt
| mlx-lm | llama.cpp | |
|---|---|---|
| Stabile Version am 30. Oktober 2026 | 0.32.2 (16. Oktober), installiert mlx 0.32.4 | v0.8.0 (28. Oktober), Build b11960 |
| Was es ist | Apples Python-Paket, um Sprachmodelle mit MLX auszuführen und feinzutunen | Eine Engine in C und C++ mit Kommandozeile, Server und Chatseite |
| Modelle unseres Katalogs, die sein Code kennt (27 am 30. Oktober 2026) | 22 | 27 |
| Dateiformat | MLX-Ordner (safetensors); liest kein GGUF | GGUF; safetensors erst nach der Umwandlung |
| Installation auf dem Mac | pip install mlx-lm (Python 3.11 oder neuer, natives ARM) |
brew install llama.cpp oder der Download für macOS ARM64 |
| Lokaler Server | mlx_lm.server auf 127.0.0.1:8080 |
llama-server auf 127.0.0.1:9931 |
| Antwortlänge, wenn die Anfrage nichts sagt | 512 Token | Ohne Grenze |
| Gleichzeitige Anfragen (Server) | Bündelt, was sich bündeln lässt; 1 Modell geladen | 4 Slots ab Werk |
| Feintuning | LoRA mit mlx_lm.lora |
Ein Beispiel, das die eigene README als Baustelle bezeichnet |
| Was es von sich aus sendet | Nichts; es geht nur auf Anforderung nach draußen (Downloads samt Änderungsprüfung, Bilder per URL, Kalibrierung) | Nichts (keine Telemetrie, keine Update-Prüfung); es geht nur auf Anforderung nach draußen (Downloads, Bilder per URL) |
| Lizenz | MIT | MIT |
Zwei Engines, kein Fenster
Keines der beiden ist eine App zum Doppelklicken. mlx-lm ist das Python-Paket, das Apples MLX-Team auf seinem Framework mlx pflegt: Sie installieren es mit pip und sprechen es über Befehle wie mlx_lm.chat, mlx_lm.generate oder mlx_lm.server an. llama.cpp ist die Engine in C und C++, die unter sehr vielen Programmen für lokale KI steckt; auf dem Mac bekommen Sie sie über Homebrew (dort seit dem 28. Oktober in Version 0.8.0) oder als fertigen Download für macOS ARM64. Beide sind Open Source unter MIT-Lizenz, und genau deshalb konnten wir jede Zeile lesen, die wir hier zitieren.
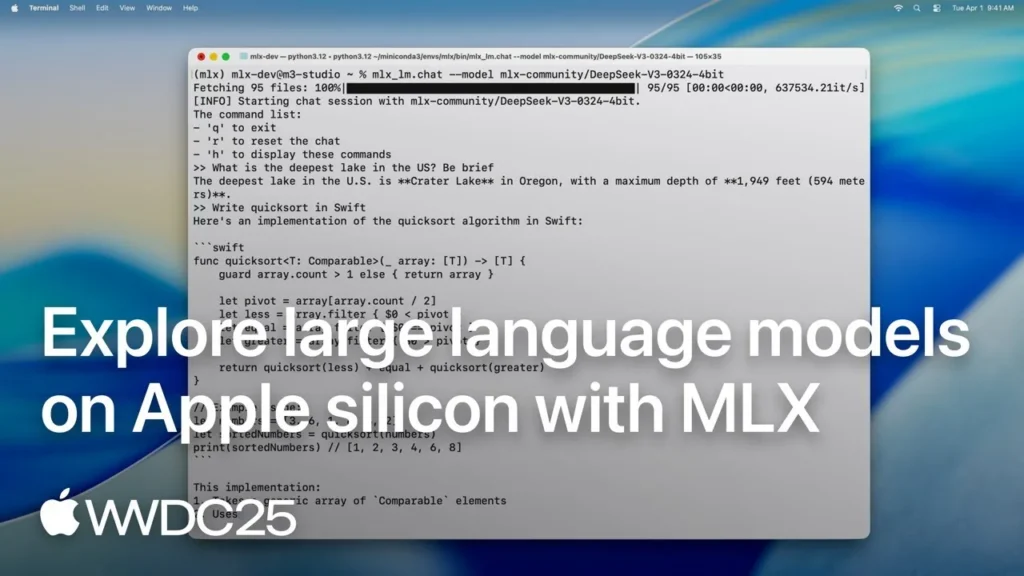
Wenn Sie eigentlich ein Fenster mit Chatfeld suchen, ist das hier nicht Ihr Duell: Unser Vergleich LM Studio vs. llama.cpp behandelt die App, die beide Engines mitbringt, und MLX vs. Ollama den Server, der ebenfalls MLX-Modelle ausführt. Diese Seite ist für den Moment, in dem Sie eine Ebene tiefer gehen und die Engine selbst wählen.
Die 27, die wir geprüft haben: llama.cpp kennt alle, mlx-lm 22
Hier ist die Zahl, wegen der wir gekommen sind. Wir haben die Architektur genommen, die jedes der 27 Modelle in seiner eigenen config.json auf Hugging Face angibt, und sie im Code beider Projekte gesucht: im Umwandlungsregister von llama.cpp v0.8.0, aufgelöst wie sein Konverter es tut, und im Modellordner von mlx-lm 0.32.2. Ergebnis (im Code gelesen, 30. Oktober 2026): llama.cpp hat Code für 27 von 27, mlx-lm für 22. Die 22, die mlx-lm kennt, kennt auch llama.cpp. In unserem Katalog gibt es kein Modell, das nur mit mlx-lm läuft.
Seit dieser Prüfung ist Mistral Large 4 als 28. Modell in unseren Katalog aufgenommen worden, und es ist die Ausnahme: Sein Code steckt in den täglichen Builds von llama.cpp ab b11998 (30. Oktober 2026), nicht in v0.8.0, die am 1. November noch die neueste stabile Version war (der stabile Kanal öffnet es seit v0.9.0, Build b12110, veröffentlicht am 4. November 2026); mlx-lm 0.32.2 hat keinen Code dafür, und der Pull Request, der ihn hinzufügt (#2018), war an dem Tag noch offen. Mit 591,21 GiB in Q4_K_M passt es auf keinen Rechner unseres Katalogs, auch nicht auf den Mac Studio mit 512 GB.
Zwei ehrliche Hinweise. Das ist Unterstützung im Code, nicht 27 Modelle, die wir einzeln gestartet hätten; und der Code kann mit der nächsten Version in mlx-lm landen, deshalb steht überall ein Datum. Der zweite Hinweis ist ein Pluspunkt für llama.cpp: Für 15 der 27 geprüften hat sein Konverter zusätzlich eine Klasse für den Bild- oder Audioteil des Modells, die separate Datei, die er Projektor nennt.

Dateien: GGUF auf der einen Seite, MLX-Ordner auf der anderen
Keines liest das Format des anderen. mlx-lm fragt Hugging Face gar nicht erst nach .gguf-Dateien: Es lädt MLX-Ordner, etwa die von mlx-community, oder wandelt das Originalmodell selbst mit mlx_lm.convert um. llama.cpp führt nur GGUF aus; wer von den originalen safetensors ausgeht, wandelt sie zuerst mit dem mitgelieferten Skript convert_hf_to_gguf.py um.
In der Praxis startet llama.cpp mit Vorsprung: Unser Katalog führt für jedes der 28 Modelle ein GGUF-Repository mit jeweils 2 bis 27 fertigen Quantisierungen (559 insgesamt), sodass llama-server -hf plus Repository-Name oft schon genügt. Bei mlx-lm haben wir die fertigen MLX-Fassungen nicht Modell für Modell gezählt; fehlt eine, ist die Umwandlung ein einziger Befehl, und Apples Session unten zeigt ihn.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Das ist Apples WWDC25-Session über Sprachmodelle mit MLX, auf Englisch. Wir haben sie über ihre Untertitel angesehen: Sie zeigt mlx_lm.generate, das Umwandeln und Quantisieren eines Modells mit mlx_lm.convert und das Training eines LoRA-Adapters auf einem 4-Bit-Modell. Ihre Modelle sind von 2025, die Versionen auf dieser Seite von heute. Wenn Sie vor allem die Dateigröße interessiert, wiegt unser Vergleich MLX vs. GGUF dieselben Modelle in beiden Formaten.
Quantisierung: weniger Regler oder mehr Dateien
mlx-lm kann beim Umwandeln quantisieren: mit -q. Ab Werk heißt das sein affiner Modus mit 4 Bit in Gruppen zu 64; die Option --q-mode akzeptiert außerdem mxfp4, nvfp4 und mxfp8, und es gibt 4 fertige gemischte Rezepte (mixed_2_6, mixed_3_4, mixed_3_6 und mixed_4_6), die empfindliche Teile mit mehr Bits behalten. Dazu kommen feinere Wege (DWQ, AWQ, GPTQ), falls Sie Lust auf so einen Abend haben.
llama.cpp geht den umgekehrten Weg: Sein Konverter schreibt das Modell ab Werk in 16 Bit (oder in 32, 8 Bit bzw. ternär), danach erzeugt llama-quantize die bekannten Namen wie Q4_K_M, Q5_K_M oder die IQ-Familie. Die gute Nachricht: Das machen Sie selten selbst, denn diese Dateien liegen schon in den Repositorys. Der Haken ist die Wahl: Ein einziges Repository kann bis zu 27 Quantisierungen anbieten.
Server: 8080 gegen 9931 und die 512-Token-Überraschung
Beide liefern einen lokalen Server mit Routen im OpenAI-Stil, der nur auf Ihrem eigenen Mac lauscht (127.0.0.1) und keinen Schlüssel verlangt. In den Details trennen sich die Wege:
- mlx_lm.server lauscht auf Port 8080. Sagt eine Anfrage nicht, wie lang die Antwort werden darf, hört er nach 512 Token auf; Temperatur 0 ab Werk; jeweils ein geladenes Modell (fordern Sie ein anderes an, tauscht er es aus). Er nimmt Aufrufe von jeder Webseite an (CORS offen) und warnt bei jedem Start, dass er nicht für den Produktivbetrieb gedacht ist.
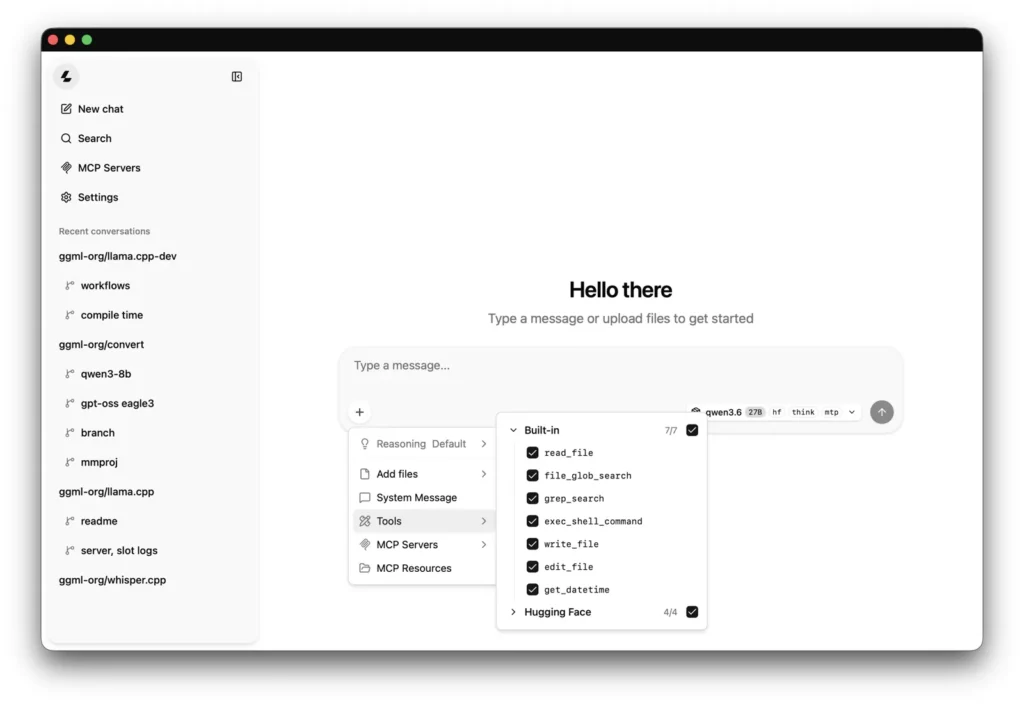
- llama-server lauscht seit v0.7.0 auf Port 9931 (vorher 8080). Ab Werk begrenzt er die Antwort nicht, nimmt den Kontext, mit dem das Modell trainiert wurde, und kürzt ihn bei knappem Speicher (nie unter 4.096 Token), und er öffnet 4 Slots für 4 gleichzeitige Anfragen. Unter derselben Adresse liefert er außerdem seine eigene Chatseite und spiegelt ab Werk den Origin jeder Webseite zurück, mit einer Warnung in der Konsole, wenn Sie keinen Schlüssel gesetzt haben.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Das Erklärvideo von IBM Technology, auf Englisch und ebenfalls über die Untertitel angesehen, erklärt in Ruhe, was llama.cpp ist: GGUF, Quantisierung, Metal, CUDA und llama-server. Beim Start des Servers setzt es selbst Port 8080, sein Befehl funktioniert also wie gezeigt; ohne diese Option landen Sie auf 9931.
Speicher und Metal auf Apple Silicon
Auf einem Mac mit Apple Silicon nutzen beide den Grafikchip über Metal, jedes mit eigenem Code, und beide leben mit derselben Regel: Prozessor und Grafikchip teilen sich einen Speicher, also kommen Modell, Kontext und Ihre übrigen Apps aus demselben Topf. mlx-lm fragt macOS, wie viel davon der Grafikchip nutzen sollte, und setzt dieses Limit beim Laden. Beide können den Gesprächscache verkleinern: mlx-lm mit --kv-bits, llama.cpp mit seinen Optionen für den Cache-Typ (ab Werk 16 Bit).
Auf einem Intel-Mac ist die Geschichte kurz. Der offizielle macOS-Build von llama.cpp für Intel kommt ohne Metal und rechnet daher auf dem Prozessor, und mlx-lm braucht ein natives ARM-Python. Hat Ihr Mac einen Intel-Chip, ist llama.cpp dasjenige, das noch läuft.
Was jedes von sich aus sendet
Das ist der Teil, der uns auf dieser Seite am wichtigsten ist, und beide benehmen sich gut. llama.cpp hat weder Telemetrie noch Update-Prüfung; wir haben seine Verbindungen am 25. August gezählt und den Code von v0.8.0 am 30. Oktober erneut gelesen: Die 2 neuen Wege nach draußen (ein Peer-to-Peer-Tunnel, --connect, und ein Schalter „Discover Models“ auf der Chatseite) sind ab Werk beide aus. Es verbindet sich nur, wenn Sie es verlangen: zum Herunterladen eines Modells (mit -hf und ähnlichen Optionen beim Start oder per Anfrage an /models, wenn Sie llama-server ohne Modell starten) oder um ein Bild, Audio oder Video zu holen, das eine Anfrage per Webadresse übergibt.
Auch mlx-lm sendet nichts Eigenes (für 0.32.2 am 17. Oktober erneut geprüft). Es geht nur auf Anforderung nach draußen: zum Laden von Modellen über die Bibliothek von Hugging Face, die beim Laden über den Namen auch prüft, ob sich das Modell geändert hat (HF_HUB_OFFLINE=1 stellt das ab, sobald Ihre Modelle auf der Platte liegen); um ein Bild zu holen, das eine Chat-Anfrage per Webadresse übergibt; und um Kalibrierdaten zu laden, wenn Sie mit AWQ, GPTQ, DWQ oder dynamischer Quantisierung quantisieren. Jede Verbindung von mlx-lm steht mit Quelle auf der Runtime-Seite zu MLX; die Seite zu llama.cpp zeigt Installation und Versionen.
Was wir nehmen würden, und was wir nicht wissen
- Sie wollen die größte Modellauswahl: llama.cpp. Seine stabile Version deckt alle 6 Modelle unseres Katalogs ab, die mlx-lm noch fehlen; das sechste, Mistral Large 4, seit v0.9.0 (4. November 2026), und mit 591,21 GiB in Q4_K_M passt es auf keinen unserer Rechner.
- Sie arbeiten in Python oder wollen feintunen: mlx-lm.
mlx_lm.loratrainiert Adapter sogar auf 4-Bit-Modellen, und die Trainings-README von llama.cpp nennt das eigene Feintuning „very much WIP“, also eine Baustelle. - Ihr Mac hat einen Intel-Chip: llama.cpp, auf dem Prozessor.
- Ihre App braucht mehrere Anfragen gleichzeitig: llama-server startet mit 4 Slots; mlx_lm.server bündelt, was geht, mit einem geladenen Modell.
Was wir nicht wissen: welches auf Ihrem Mac mit Ihrem Modell schneller ist. Wir haben es nicht gemessen, und es hängt von Chip, Modell und Version ab. Die Prüfung geht schnell: mlx_lm.generate zeigt Token pro Sekunde für das Einlesen und für die Antwort, und beide bringen ein Benchmark-Werkzeug mit: mlx_lm.benchmark und llama-bench. Gleiches Modell, gleiche Größe, gleicher Prompt, und Sie haben Ihre eigene Zahl.
Wenn Sie eines der beiden gegen Ollama abwägen, machen unsere Vergleiche llama.cpp vs. Ollama und MLX vs. Ollama dort weiter, wo dieser aufhört, und der Modellfinder sagt Ihnen, welche der 28 in den Speicher Ihres Mac passen.