Sur un Mac Apple Silicon, Ollama utilise déjà MLX : quand une étiquette de sa bibliothèque propose une version MLX, il télécharge celle-ci et l’exécute avec son propre moteur. Prenez Ollama pour son application, sa bibliothèque, son API sur le port 11434. Prenez mlx-lm pour faire tourner en MLX les modèles inconnus du moteur d’Ollama, utiliser les versions mlx-community, affiner.
Cette première phrase change la question, et tout le reste de la page en découle. Le 30 octobre 2026, nous avons lu le code d’Ollama 0.40.13 et de mlx-lm 0.32.2, confronté aux deux les 27 modèles que comptait ce jour-là notre outil de recherche, et demandé à la bibliothèque d’Ollama quelle version reçoit un Mac pour 9 de ses étiquettes. Nous ne les avons pas fait courir chronomètre en main : pas de vainqueur en vitesse ici, mais plus bas, de quoi trancher sur votre propre Mac.
 MLX (mlx-lm)Fiche logiciel
 OllamaFiche logiciel
| mlx-lm | Ollama | |
|---|---|---|
| Ce que c’est | Le paquet Python d’Apple pour exécuter et affiner des modèles de langage avec MLX | Une application et un serveur qui téléchargent des modèles depuis sa bibliothèque et les exécutent avec MLX ou llama.cpp |
| Version au 30 octobre 2026 | mlx-lm 0.32.2, qui installe mlx 0.32.4 | Ollama 0.40.13 |
| Le MLX embarqué | Le paquet mlx d’Apple, la version stable 0.32.4 | Un moteur maison écrit en Go sur l’interface C de MLX, compilé avec un mlx du 25 octobre 2026, en avance de 31 modifications sur la 0.32.4 |
| Modèles de notre catalogue connus de son code MLX (27 au 30 octobre 2026) | 22 | 17 |
| D’où viennent les modèles | Hugging Face : versions mlx-community ou votre propre conversion | Sa bibliothèque (ollama pull), ou votre propre dossier safetensors ou fichier GGUF importé avec ollama create |
| GGUF | Ne le lit pas | Oui, avec llama.cpp, pour les étiquettes sans version MLX |
| Installation | pip install mlx-lm, terminal uniquement |
Application de bureau ou script d’une ligne |
| Serveur local | mlx_lm.server sur 127.0.0.1:8080, routes façon OpenAI |
127.0.0.1:11434 : son API maison plus des routes façon OpenAI et façon Anthropic |
| Affinage | LoRA avec mlx_lm.lora |
Non ; et la 0.40.13 refuse les adaptateurs LoRA à la création d’un modèle |
| Ce qu’il envoie de lui-même | Rien ; la bibliothèque Hugging Face qui télécharge vérifie si le modèle a changé | 2 types d’appel à ollama.com avec le seul serveur, 4 avec l’application de bureau |
| Licence | MIT | MIT |
| Vitesse | Non mesurée par nous | Non mesurée par nous |
Ollama exécute déjà MLX sur votre Mac, mais ce n’est pas mlx-lm
Depuis Ollama 0.40.0, une étiquette de sa bibliothèque peut contenir 2 versions : une en safetensors pour MLX et une en GGUF pour llama.cpp. Sur un Mac Apple Silicon, le code place MLX en tête : quand les deux existent, votre Mac reçoit la version MLX. Ce qui l’exécute n’est pas mlx-lm. Ollama a son propre moteur MLX, écrit en Go, qui parle à MLX par son interface C : pas de Python, pas de paquet mlx-lm, et son propre code pour chaque famille de modèles.
Le MLX du dessous n’est pas tout à fait le même non plus. Ollama 0.40.13 est compilé sur un instantané de développement du mlx d’Apple daté du 25 octobre 2026, en avance de 31 modifications sur la version stable 0.32.4. mlx-lm 0.32.2 demande mlx 0.32.2 ou plus récent, donc pip vous installe aujourd’hui la stable 0.32.4. Même charpente à 11 jours d’écart, et par-dessus 2 jeux de code de modèles différents.
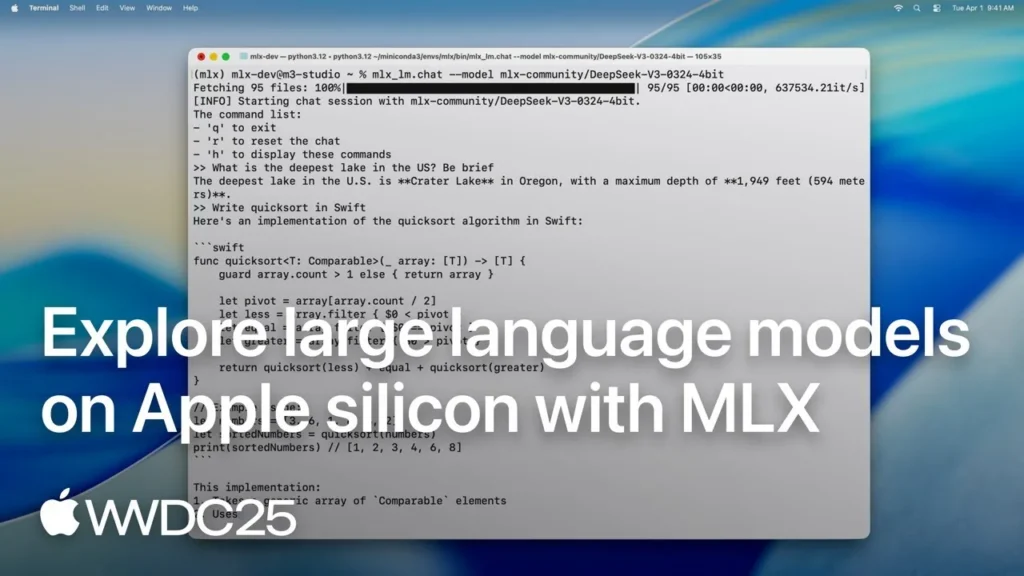
« MLX vs Ollama », c’est donc en réalité le MLX de mlx-lm contre le MLX d’Ollama. Avec 2 conséquences bien concrètes : un modèle pris en charge par l’un ne l’est pas forcément par l’autre, et un chiffre de vitesse mesuré sur l’un ne dit pas grand-chose de l’autre.
Quels modèles chacun fait tourner : les 27 que nous avons vérifiés, confrontés aux deux
Nous avons pris les 27 modèles de notre outil de recherche au 30 octobre 2026, lu l’architecture que chacun déclare dans son config.json sur Hugging Face, et cherché ce nom dans le code des deux : le moteur MLX d’Ollama choisit son code de modèle d’après ce nom, et mlx-lm a besoin d’un fichier pour ce type de modèle.
| Qui le connaît | Modèles |
|---|---|
| Les deux (14) | Qwen3 1.7B, Qwen3 4B 2507, Qwen3 8B, Qwen3.5 9B, Qwen3.6 27B, Qwen3.8 27B, Qwen3.6 35B A3B, Gemma 4 E2B, E4B, 12B, 26B A4B et 31B, Muse Glimmer 30B, Nemotron 3.5 Lightning 30B |
| mlx-lm seul (8) | Qwen3 Coder 30B, gpt-oss-20b, gpt-oss-120b, GLM-5.2, Mistral Small 24B, Llama 4 Scout, Granite 4.2 8B, Phi-4 |
| Le moteur MLX d’Ollama seul (3) | Flint, Qwen3.8 Flash Next, Nemotron 3.5 Super 120B |
| Aucun des deux (2) | DeepSeek V4 Flash, GLM-5.3 Flash |
Lu dans le code de mlx-lm 0.32.2 et d’Ollama 0.40.13 le 30 octobre 2026, face au config.json de chaque modèle sur Hugging Face. C’est une prise en charge dans le code, pas une exécution : nous n’avons pas chargé les 27 sur un Mac.
« mlx-lm seul » ne veut pas dire qu’Ollama ne peut pas faire tourner le modèle. Le 30 octobre 2026, phi4:14b, gpt-oss:20b et qwen3-coder:30b figuraient dans la bibliothèque d’Ollama avec une seule version GGUF : sur un Mac, Ollama les exécute donc avec llama.cpp, sur la puce graphique via Metal. Si vous voulez ces modèles en MLX, c’est mlx-lm. Et dans l’autre sens : si vous cherchez Flint, Qwen3.8 Flash Next ou Nemotron 3.5 Super en MLX, mlx-lm 0.32.2 n’a pas encore de code pour eux, le moteur d’Ollama si.

Le moteur peut, l’étiquette décide
Connaître une architecture ne suffit pas à Ollama : il faut que l’étiquette apporte une version MLX. Qwen3 8B est le cas le plus parlant. Le moteur MLX d’Ollama a le code pour lui, mais le 30 octobre 2026 l’étiquette qwen3:8b n’avait qu’une version GGUF : un Mac l’exécute donc avec llama.cpp. Le même jour, qwen3.5:9b, qwen3.6:27b, gemma4:e4b, gemma4:12b et flint:latest avaient les 2 versions, et un Mac reçoit la MLX.
Avec mlx-lm, pas de liste de ce genre : vous choisissez le dépôt exact sur Hugging Face, par exemple une version 4 bits de mlx-community, ou vous convertissez vous-même les poids d’origine avec mlx_lm.convert. Les versions MLX d’Ollama sont ses propres compilations et ne pèsent pas toujours autant que celles de mlx-community ; notre comparatif MLX vs GGUF mesure les tailles étiquette par étiquette.
Ollama a ici 2 portes à lui, que nous avons lues dans le code de la 0.40.13 sans les tester. ollama create importe un dossier safetensors comme version MLX, et son option --quantize le compresse au passage en nvfp4, mxfp4, int4, mxfp8 ou int8. Et pull et run acceptent une option cachée, --runner, pour demander l’une des 2 versions d’une étiquette. Les options cachées peuvent changer sans prévenir.
Serveurs : port 11434 ou 8080, et la surprise des 512 tokens
Les deux ouvrent d’origine un serveur limité à votre propre machine, sans clé. Ollama écoute sur 127.0.0.1:11434 et parle 3 dialectes : son API maison (/api/chat), le style OpenAI (/v1/chat/completions et /v1/responses) et le style Anthropic (/v1/messages). Il garde un modèle chargé 5 minutes après la dernière requête (OLLAMA_KEEP_ALIVE le modifie) et, côté pages web, n’accepte par défaut que les appels de celles servies depuis localhost, 127.0.0.1 ou 0.0.0.0 (plus app://, tauri://, file:// et les éditeurs de code ; OLLAMA_ORIGINS en ajoute d’autres).
mlx_lm.server écoute sur 127.0.0.1:8080, dans le seul style OpenAI (/v1/chat/completions, /v1/completions et /v1/models), accepte les appels de n’importe quelle page web et prévient à chaque démarrage qu’il n’est pas fait pour la production. Il garde 1 modèle en mémoire et le remplace quand une requête en demande un autre par son nom. Quand le modèle le permet, il regroupe les requêtes : par défaut, jusqu’à 32 réponses et 8 prompts à la fois.
Mémoire : les deux posent la même question à macOS
macOS indique à chaque programme combien de mémoire il recommande pour la puce graphique, et les deux lisent ce chiffre. mlx-lm règle sa limite de mémoire verrouillée pour la puce graphique sur la totalité du montant recommandé. Le moteur MLX d’Ollama règle cette limite sur ce qu’occupe le modèle chargé, plafonnée au montant recommandé, et inscrit un avertissement dans son journal quand le modèle dépasse la recommandation : les performances peuvent en pâtir à partir de là.
Aucune de ces deux astuces ne rend un modèle plus petit. Qu’il tienne ou non dépend du fichier, du contexte demandé et de la mémoire disponible, et notre outil de recherche de modèles fait ce calcul pour votre Mac. Si vous butez sur le plafond avec mlx-lm sur un Mac de 16 Go, notre guide des erreurs MLX donne les vrais chiffres et la façon de le relever.
Si vous voulez d’abord voir Ollama sur le Mac mini M4 le moins cher, celui de 16 Go, ce test (en espagnol) le fait tourner dessus et regarde quels modèles il fait tourner et quand il commence à utiliser le swap. Ses chiffres viennent de sa machine et de ses versions, pas de celles de cette page.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Ce que seul mlx-lm sait faire : affinage et versions sur mesure
Là, mlx-lm joue dans une autre catégorie. mlx_lm.lora affine un modèle avec LoRA sur votre Mac et mlx_lm.fuse fusionne le résultat avec le modèle. mlx_lm.convert compresse les poids d’origine, et mlx_lm.dwq, mlx_lm.awq et mlx_lm.gptq sont d’autres façons de compresser qui cherchent à perdre moins de qualité. mlx_lm.evaluate, mlx_lm.perplexity et mlx_lm.benchmark mesurent le résultat. Ollama n’entraîne rien, et la 0.40.13 n’accepte plus non plus de nouveaux adaptateurs LoRA : ollama create répond « LoRA adapters are no longer supported ».
Les deux savent accélérer une réponse avec un petit modèle brouillon qui devine la suite. mlx-lm accepte n’importe quel modèle compatible avec --draft-model. Ollama 0.40.13 peut aussi en utiliser un sur son moteur MLX, si l’étiquette l’apporte ou si vous l’ajoutez avec une ligne DRAFT dans ollama create ; nous n’avons pas vérifié quelles étiquettes de sa bibliothèque en ont un. Et Ollama garde le confort : une application de bureau, une bibliothèque où 1 commande télécharge et lance un modèle, et une API que peuvent appeler les applications écrites pour Ollama, OpenAI ou Anthropic.
Pour la version d’Apple, sa session de la WWDC26 « Run local agentic AI on the Mac using MLX » est la source officielle (en anglais). Elle a été enregistrée avec ses propres versions : là où elle et cette page divergent sur une option, cette page suit mlx-lm 0.32.2.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
La vitesse, et ce que chacun envoie
Nous aimerions vous donner un chiffre, et nous n’allons pas l’inventer. Les deux partagent la charpente d’Apple mais ni la version ni le code des modèles : le seul test honnête est le vôtre, même modèle, même compression, même prompt. ollama run qwen3.6:27b --verbose affiche après chaque réponse la vitesse de lecture du prompt et d’écriture en tokens par seconde, et mlx_lm.generate le fait de lui-même. Choisissez une étiquette qui apporte une version MLX, sinon vous chronométrerez llama.cpp : dans le code de la 0.40.13, ollama show ajoute une ligne runner quand une étiquette a 2 versions.

Côté réseau, mlx-lm ne fait aucun appel de lui-même ; la bibliothèque Hugging Face qui télécharge demande à huggingface.co si un modèle a changé chaque fois que vous le chargez par son nom, jusqu’à ce que vous définissiez HF_HUB_OFFLINE=1. Ollama, avec le seul ollama serve, fait 2 types d’appel à ollama.com, que OLLAMA_NO_CLOUD=1 coupe ; avec l’application de bureau, 4, et la vérification des mises à jour ne se coupe pas. Chaque destination, avec sa source et sa date, figure sur nos fiches MLX et Ollama. Les deux sont open source sous licence MIT : chacun peut relire ce que nous avons lu.
Lequel nous utiliserions, selon votre profil
- Premiers pas sur Mac, et vous voulez discuter aujourd’hui : Ollama. Vous avez MLX sans le demander dès que l’étiquette le propose. Notre guide d’installation d’Ollama vous accompagne.
- Une application ou un agent qui parle l’API d’Ollama ou celle d’Anthropic : Ollama, sur le port 11434.
- Phi-4, gpt-oss, Qwen3 Coder 30B, Mistral Small ou Granite en MLX : mlx-lm. Le moteur MLX d’Ollama ne les connaît pas ; dans Ollama, ils tournent avec llama.cpp si sa bibliothèque les propose (vérifié pour
phi4:14b,gpt-oss:20betqwen3-coder:30b). - Flint, Qwen3.8 Flash Next ou Nemotron 3.5 Super en MLX : Ollama, dont le moteur a le code ; mlx-lm 0.32.2 ne l’a pas.
- Affinage, compressions maison ou une version mlx-community précise : mlx-lm ; notre guide d’installation de MLX vous mène de l’installation au serveur.
- Les deux : ils s’installent côte à côte et écoutent sur des ports différents (8080 et 11434), mais chacun garde sa propre copie de chaque modèle, et 2 modèles chargés s’additionnent en mémoire.
Si quelque chose coince en route, nous avons des guides pour quand MLX ne fonctionne pas et quand Ollama ne fonctionne pas. Vous hésitez encore avec d’autres programmes ? Nos comparatifs LM Studio vs Ollama et llama.cpp vs Ollama font le tour de la question. Vous hésitez entre mlx-lm et llama.cpp, sans application par-dessus ? Notre comparatif MLX vs llama.cpp vérifie lesquels des modèles de notre catalogue chacun connaît.