Prenez LM Studio si vous voulez tout voir à l’écran : chercher un modèle, le charger et discuter sans terminal. Prenez Ollama pour un serveur où se branchent d’autres logiciels, du code ouvert et une commande par modèle. Les deux utilisent le même moteur, llama.cpp : sur une même machine, les mêmes modèles tiennent.
Cette dernière phrase, c’est le rebondissement de ce comparatif. Ollama 0.40.10, la version stable depuis le 23 octobre 2026, embarque la compilation b11803 de llama.cpp ; LM Studio 0.4.26 fournit son moteur llama.cpp 2.50.0, construit sur la b11337. Et sur un Mac Apple Silicon, les deux savent aussi passer par MLX. Le même moteur sous deux carrosseries. Nous ne les avons pas fait courir l’un contre l’autre au chronomètre, et avec le même fichier GGUF sur le même llama.cpp, la vitesse dépend de la compilation du moteur et des réglages que choisit chaque logiciel (la taille du contexte, le nombre de couches envoyées à la carte graphique) : nous ne couronnerons donc personne sur la vitesse. Là où ils se séparent vraiment, c’est sur ce que vous pouvez lire, sur les portes ouvertes d’origine et sur ce que chacun envoie dehors sans vous demander. Le code d’Ollama, nous l’avons lu partout où il touche au réseau ; celui de LM Studio est fermé, et pour lui nous ne pouvons rapporter que ce que déclare son éditeur.
 LM StudioFiche logiciel
 OllamaFiche logiciel
| LM Studio | Ollama | |
|---|---|---|
| Ce que c’est | Une application de bureau : recherche, téléchargement, discussion et serveur dans la même fenêtre | Un serveur local en ligne de commande ; application de bureau sur macOS et Windows seulement |
| Version au 24 octobre 2026 | 0.4.26 | 0.40.10 |
| Code | Fermé (conditions de licence), gratuit à la maison comme au travail ; sa ligne de commande lms est sous MIT |
Ouvert, MIT |
| Moteurs | llama.cpp (GGUF) et MLX sur Apple Silicon | llama.cpp (GGUF) et MLX, celui par défaut sur Apple Silicon |
| Tourne sur | Windows x64 (AVX2) et ARM64, Mac Apple Silicon (macOS 14 ou plus), Linux x64 et ARM64. Pas de Mac Intel | Windows 10 22H2 ou plus x64 et ARM64, macOS 14 ou plus (Mac Intel sur le processeur seulement), Linux amd64 et arm64 |
| D’où viennent les modèles | De la recherche intégrée (Hugging Face), en GGUF et MLX | De la bibliothèque d’Ollama (ollama pull), ou d’un GGUF ou safetensors que vous importez |
| Écoute sur | 127.0.0.1:1234 |
127.0.0.1:11434 |
| Mot de passe sur l’API locale | Aucun par défaut ; jetons d’API avec permissions si vous activez Require Authentication | Aucun, et le serveur local n’a aucune clé à vérifier |
| CORS d’origine | Désactivé ; --cors ou l’interrupteur Enable CORS l’activent |
Ouvert aux pages sur localhost, 127.0.0.1 et 0.0.0.0 sur n’importe quel port |
| API | Compatible OpenAI (/v1), compatible Anthropic (/v1/messages) et une API REST maison |
La sienne (/api), compatible OpenAI (/v1) et compatible Anthropic (/v1/messages) |
| Sans fenêtre | Le démon llmster (lms daemon up) |
ollama serve |
| Contexte par défaut | Le sien, qu’il ne publie pas ; vous pouvez le fixer pour chaque modèle au chargement | Selon la mémoire graphique : 4 096, 32 768 ou 262 144 jetons |
| Contacte de lui-même | 2 choses, selon son éditeur (code fermé) | 4 types d’appel avec l’application de bureau, 2 avec ollama serve seul (lu dans son code) |
| Dossier des modèles | ~/.lmstudio/models |
~/.ollama/models |
Même moteur, mêmes modèles : ce qui tient ne dépend pas du logiciel
Un modèle pèse ce qu’il pèse. Un GGUF quantifié en Q4_K_M occupe les mêmes octets de mémoire dans LM Studio et dans Ollama, puisque dans les deux un GGUF est normalement chargé par llama.cpp. Ce qui fait varier la note, c’est le contexte : plus la conversation que le modèle doit garder en tête est longue, plus le cache qu’il réserve à côté des poids grossit. Et c’est là que les deux logiciels font des choix différents à votre place, comme on le verra un peu plus bas, dans la partie sur le contexte.
Sur un Mac Apple Silicon, il existe une deuxième voie. Depuis la version 0.40.0, Ollama fait tourner par défaut avec MLX tout modèle dont l’architecture est prise en charge, et une étiquette de sa bibliothèque peut contenir deux versions : le Mac télécharge la MLX si elle existe, toutes les autres machines la GGUF. LM Studio vous laisse choisir : sa recherche affiche GGUF et MLX côte à côte, et il a son propre moteur MLX. Depuis la 0.4.25, LM Studio annonce en plus un troisième moteur, Splash, pour les Mac M3 ou plus récents sous macOS 26.4 ou ultérieur ; là, c’est la parole de son éditeur, puisque le code est fermé.
Un écueil pratique si vous comptez garder les deux. Ils ne partagent pas de dossier : LM Studio range les modèles dans ~/.lmstudio/models et Ollama dans ~/.ollama/models, dans son propre format par couches. Installez les deux, et chaque modèle voulu des deux côtés atterrit deux fois sur votre disque. Avec un modèle de 20 Go, c’est le genre de détail dont on se souvient le jour où le disque est plein.
Pour voir quels modèles tiennent sur votre machine et avec quel contexte, notre trouveur de modèle fait le calcul avec la même règle, quel que soit le logiciel.
Une application qu’on regarde, ou un serveur à qui l’on parle
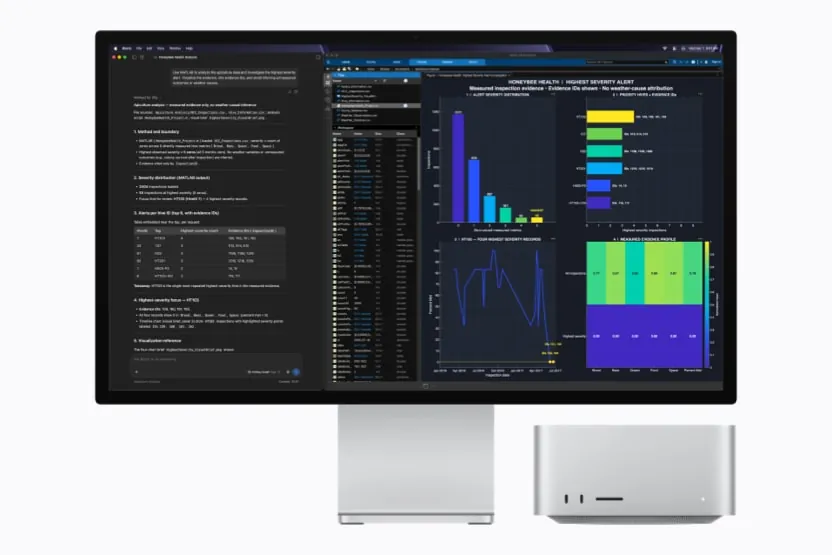
LM Studio est fait pour être vu. Vous l’ouvrez, cherchez un modèle dans l’onglet Discover, le téléchargez, le chargez, et la discussion commence. Le serveur local se trouve sur la page Developer et démarre d’un interrupteur, ou avec lms server start depuis le terminal ; lms est livré avec l’application. Il existe aussi llmster, le cœur de l’application sans la fenêtre, pour une machine Linux ou un serveur : il s’installe avec un script et démarre avec lms daemon up.
Ollama est fait pour qu’on lui parle. ollama run suivi du nom d’un modèle le télécharge et ouvre une discussion dans le terminal, et en arrière-plan un serveur reste à l’écoute de tout logiciel qui veut s’en servir : votre éditeur, une interface de discussion, votre propre script. Sur macOS et Windows, une application de bureau ajoute une fenêtre de discussion et un écran de réglages ; sous Linux, pas d’application de bureau du tout, seulement le serveur et la ligne de commande. Si ollama serve vous intrigue : c’est ce même serveur lancé à la main, et sur la plupart des installations vous n’aurez jamais à le taper.
La première question n’est donc pas lequel est le meilleur, mais comment vous aimez travailler. Si le terminal vous intimide, LM Studio vous paraîtra familier en quelques minutes. Si vous voulez un modèle à disposition pour d’autres logiciels, Ollama sait se faire oublier. L’installation de chacun, pas à pas, est dans notre guide pour démarrer LM Studio et dans celui pour démarrer Ollama en local.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Clé d’API Ollama : le serveur local n’en a pas (LM Studio, si)
La documentation d’Ollama est nette : l’API locale sur http://localhost:11434 ne demande aucune authentification. Si un outil réclame une clé d’API, un client OpenAI par exemple, donnez-lui n’importe quel texte : les exemples d’Ollama utilisent api_key='ollama' et précisent qu’elle est obligatoire mais ignorée. Les clés d’API que vous créez dans un compte ollama.com servent au nuage d’Ollama (https://ollama.com/api et /v1), pas au serveur de votre ordinateur.
Il existe une variable qui ressemble à un cadenas et n’en est pas un. OLLAMA_AUTH fait seulement signer ses requêtes au client Ollama ; dans le code, le serveur ne vérifie rien. Si vous avez besoin d’un mot de passe devant un Ollama local, il doit venir de quelque chose que vous placez devant, comme un proxy inverse avec sa propre connexion.
LM Studio l’intègre depuis la version 0.4.0. Sur la page Developer, dans Server Settings, activez Require Authentication ; avec Manage Tokens, vous créez des jetons, chacun avec ses permissions. Dès lors, chaque requête doit porter Authorization: Bearer suivi du jeton, et le point d’accès façon Anthropic, /v1/messages, accepte aussi x-api-key. D’origine, c’est désactivé : un LM Studio fraîchement installé ne demande rien non plus.

Longueur de contexte d’Ollama, et la méthode de LM Studio
Ollama choisit le contexte par défaut selon la mémoire graphique qu’il détecte au démarrage du serveur. Dans le code de la 0.40.7 : sous 23 Gio, 4 096 jetons ; dès 23 Gio, 32 768 ; dès 47 Gio, 262 144. La documentation arrondit à 24 et 48 Gio. Le serveur inscrit le résultat dans son journal, sur une ligne qui contient vram-based default context, et ollama ps affiche le contexte de chaque modèle chargé dans sa colonne CONTEXT.
4 096 jetons, c’est quelques pages de texte. Une longue discussion ou un gros fichier de code dépasse vite, et à partir de là le modèle ne voit plus le début. Ollama recommande lui-même au moins 64 000 jetons pour les agents, la recherche web et les outils de programmation. 3 façons de l’augmenter : le curseur de contexte dans les réglages de l’application de bureau, la variable OLLAMA_CONTEXT_LENGTH au démarrage du serveur (par exemple OLLAMA_CONTEXT_LENGTH=32768 ollama serve), ou l’option num_ctx dans chaque requête.
LM Studio vous laisse décider. Si vous cochez Manually choose model load parameters au chargement, ou utilisez lms load avec --context-length, vous fixez le contexte de chaque modèle ; sinon, il charge avec une valeur à lui qu’il ne publie pas. Et --estimate-only affiche la mémoire que prendrait le chargement sans rien charger. Une étape de plus, et une surprise de moins.
Accès à distance : OLLAMA_HOST=0.0.0.0 et le Serve on Local Network de LM Studio
Les deux arrivent à l’écoute de votre seul ordinateur : Ollama sur 127.0.0.1:11434, LM Studio sur 127.0.0.1:1234. Pour les joindre depuis un autre appareil, il faut les ouvrir exprès.
Dans Ollama, le réglage, c’est la variable OLLAMA_HOST=0.0.0.0:11434 : sous Linux dans la ligne Environment= du service, sur macOS avec launchctl setenv, sous Windows comme variable d’environnement de votre compte. L’application de bureau propose aussi un réglage qui fait la même chose, désactivé d’origine. Sachez ce qui vient avec : aucun mot de passe, et la vérification de l’en-tête Host que fait Ollama sur chaque requête ne s’applique que lorsqu’il écoute sur votre propre machine. Quiconque atteint le port 11434 peut s’en servir, modèles compris.
Dans LM Studio, l’interrupteur s’appelle Serve on Local Network, ou bien lms server start avec --bind 0.0.0.0. Sa documentation prévient que toute adresse autre que 127.0.0.1 expose le serveur au-delà de votre machine et recommande d’activer l’authentification.

Le CORS est l’autre porte, et ici ils partent de deux extrêmes. Le CORS décide quelles pages web peuvent utiliser le serveur depuis votre navigateur. Ollama accepte d’origine les pages servies depuis localhost, 127.0.0.1 et 0.0.0.0 sur n’importe quel port, plus quelques schémas d’application (app://, file://, tauri://, vscode-webview://, vscode-file://), et répond 403 à toute autre origine ; les extensions du navigateur doivent être ajoutées avec OLLAMA_ORIGINS, qui ajoute des origines à cette liste et ne retire jamais celles qui y sont d’office. LM Studio laisse le CORS désactivé sauf si vous activez Enable CORS ou lancez le serveur avec --cors ; son code étant fermé, impossible de savoir s’il refuse ces requêtes ou s’il cache seulement la réponse. Dans tous les cas, le cadenas, c’est Require Authentication, pas le CORS.
Ce que chacun envoie dehors de lui-même
C’est la partie que nous avons lue dans le code, et là Ollama se révèle le plus bavard des deux. Avec son application de bureau ouverte sur macOS ou Windows, Ollama fait 4 types d’appel à ollama.com sans que vous fassiez rien : il cherche des mises à jour toutes les heures (le réglage de mise à jour automatique n’empêche que le téléchargement, jamais la vérification), récupère un catalogue de modèles recommandés toutes les 4 heures, précharge les fiches de ses modèles cloud au démarrage du serveur et interroge ollama.com sur votre compte à l’ouverture de l’application, que vous en ayez un ou non. Avec ollama serve seul, comme sous Linux, restent les 2 liés au cloud, et OLLAMA_NO_CLOUD=1 les coupe ; avec l’application de bureau, la vérification horaire des mises à jour et l’appel au compte restent, quels que soient vos réglages. Aucune bibliothèque d’analytique à l’intérieur. Nous l’avons compté sur le code de la 0.40.2 et vérifié à chaque version depuis, jusqu’à la 0.40.7 : aucune ne le change.
LM Studio affirme ne pas avoir de télémétrie, et d’après son éditeur 2 choses partent toutes seules : l’application cherche des mises à jour (sa politique de confidentialité indique qu’elle reçoit la version et le build de l’application, le système d’exploitation et l’adresse IP), et les moteurs d’inférence se mettent à jour seuls, activé d’origine depuis la version 0.3.9 et désactivable dans les réglages de l’application. La recherche dans Discover interroge Hugging Face, mais seulement quand vous l’utilisez. Est-ce tout ? Impossible de vous le dire : le code est fermé, et personne hors de l’entreprise ne peut le lire pour vérifier. C’est le prix à payer.

La licence suit la même ligne. Ollama est sous MIT : vous pouvez le lire, le modifier et le redistribuer. LM Studio est gratuit à la maison comme au travail selon ses conditions, qui interdisent de le revendre en tant que service ; sa ligne de commande lms, ses SDK et son moteur MLX sont sous MIT. Le détail complet, chaque destination avec sa source, est sur nos fiches Ollama et LM Studio.
Et llama.cpp ou vLLM ?
llama.cpp est le moteur que les deux ont sous le capot. L’utiliser directement vous donne toutes les options et la compilation la plus récente le jour de sa sortie, et il ne contacte personne de lui-même : pas de recherche de mises à jour, rien. Son serveur écoute sur 127.0.0.1:9931 depuis la v0.7.0 (8080 jusqu’à la v0.6.0). Le prix à payer : le terminal, et trouver la bonne compilation pour votre carte. Si Ollama ou LM Studio deviennent trop justes, c’est l’étape suivante, et notre guide pour démarrer llama.cpp vous accompagne.
 llama.cppFiche logiciel
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
vLLM joue dans une autre catégorie. Il est conçu pour servir beaucoup d’utilisateurs à la fois depuis une machine Linux équipée de cartes NVIDIA ; sous Windows il ne tourne que dans WSL, et sur Mac il est expérimental et limité au processeur. Pour une personne et un portable, ce n’est pas l’alternative à ces deux-là. Si vous montez un serveur partagé, commencez par notre guide pour démarrer vLLM. Et pour le comparer à Ollama, notre comparatif vLLM vs Ollama met les deux face à face.
vLLMFiche logiciel
Lequel nous installerions, selon votre profil
- Vous n’avez jamais ouvert un terminal : LM Studio. Chercher, télécharger et discuter dans la même fenêtre.
- Vous voulez un modèle pour votre éditeur, vos scripts ou d’autres logiciels : Ollama. Une commande, un serveur toujours à l’écoute et une API compatible OpenAI.
- Vous voulez un mot de passe sur l’API locale sans pièce en plus : LM Studio, avec Require Authentication.
- Vous voulez savoir exactement ce qui sort de votre ordinateur : Ollama, dont le code se lit, en
ollama serveavecOLLAMA_NO_CLOUD=1; ou llama.cpp, qui ne contacte personne. - Vous avez un Mac à puce Intel : Ollama, sur le processeur seulement selon Ollama. LM Studio n’a pas de version pour lui.
- Vous avez un serveur Linux sans écran : l’un ou l’autre, avec le serveur d’Ollama ou le
llmsterde LM Studio.
Si quelque chose coince après l’installation, les erreurs exactes et leur solution sont dans LM Studio ne fonctionne pas et Ollama ne fonctionne pas.