Accueil›Matériel›Mac mini avec M5 Pro et 64 Go unifiés
Mac mini avec M5 Pro et 64 Go unifiés
Puce Apple64 GiB307 GB/s9,2 TFLOPS
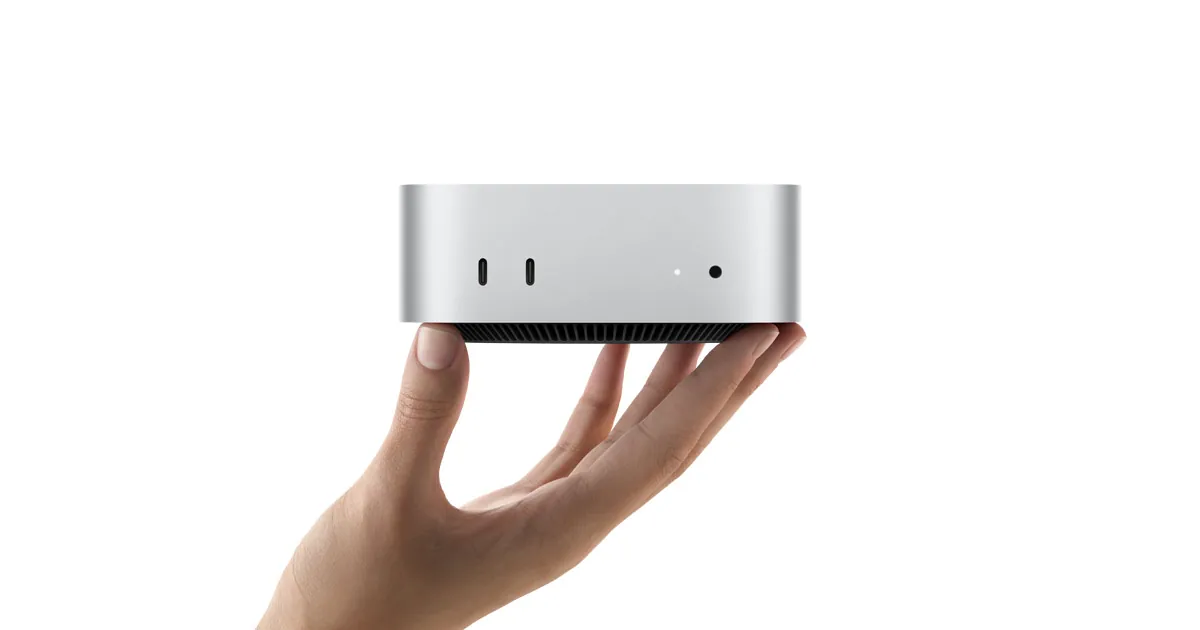
Cette machine laisse 61,00 Gio au modèle une fois que le système a pris sa part, et elle accepte 16 des 20 modèles que nous mesurons à la compression de référence. Ce qui décide de sa vitesse de réponse n’est pas la puce : ce sont les 307 GB/s de bande passante mémoire.
Reste pour le modèle
Estimation maison
Bande passante mémoire
Déclaré par le fabricant
Modèles qui tiennent
Mesuré par Local AI Scope
Vidéos : Mac mini avec M5 Pro et 64 Go unifiés 3
Les images officielles et les meilleures démonstrations que nous avons trouvées. Appuyez et la vidéo s’ouvre ici.
Les vidéos sont sur YouTube et rien ne se charge depuis YouTube tant que vous n’appuyez pas (mode sans cookies). La miniature est servie par nous.
La mémoire réellement utilisable
La mémoire unifiée est partagée avec le système d’exploitation et tout ce que vous avez ouvert. La réserve indiquée ici est volontairement prudente ; vous pouvez la modifier dans l’outil.
| Mémoire | Gio |
|---|---|
| Mémoire de la machine | 64 |
| Réservée au système | −3,00 |
| Reste pour le modèle | 61,00 |
Bande passante mémoire
Ce sont deux limites différentes, et on les confond sans cesse. Pendant que le modèle écrit sa réponse, c’est la bande passante qui commande : chaque token oblige à relire tous les poids, si bien que les tokens par seconde valent à peu près la bande passante divisée par la taille du modèle. Pendant que le modèle lit votre document, c’est le calcul qui commande : l’entrée est traitée d’un seul coup. D’où un portable sans GPU qui met des minutes avant le premier mot puis écrit à un rythme acceptable.
307 GB/s — Déclaré par le fabricant · vérifié sur la page du fabricant le 2026-09-19 (Source).
Les 307 Go/s valent pour les deux variantes du M5 Pro et pour les trois mémoires : Apple ne publie qu’un seul chiffre, contrairement au M6 du même tableau. Ce qui change en montant de puce, c’est le GPU : 16 cœurs de série et 20 dans la variante sur laquelle cette fiche est calculée, la seule qu’Apple vende avec 64 Go montés. Ce palier déplace la vitesse estimée de lecture, pas ce qui tient.
Calcul: 9,2 TFLOPS (estimation pour cette classe de machine) — Estimé · le fabricant ne publie ce chiffre nulle part ; le nôtre est une estimation prudente, pas une spécification. Les chiffres de cette ligne ne proviennent pas tous de la même mesure selon la machine, car chaque fabricant en publie une différente. Comparez-les d’une machine à l’autre en le sachant.
Quels modèles tiennent ici, et lesquels non
Tenir signifie que trois choses tiennent à la fois dans la mémoire restante : le fichier du modèle, sa mémoire de contexte et la marge de travail du runtime. La mémoire de contexte est calculée à partir du schéma d’attention que chaque modèle déclare, couche par couche, et non de la formule générique : c’est pourquoi des modèles que d’autres calculateurs jugent impossibles tiennent ici.
| Modèle | Compression affichée | Taille du modèle | 8k | 32k | 128k | Plus grand contexte qui tient |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | oui | oui | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | oui | oui | oui | 256k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | oui | oui | oui | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | oui | oui | oui | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | oui | oui | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | oui | oui | oui | 128k |
| gemma4-12b | Q4_K_M |
6,63 GiB | oui | oui | oui | 256k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | oui | oui | oui | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | oui | oui | oui | 128k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | oui | oui | oui | 256k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | oui | oui | oui | 256k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | oui | oui | oui | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | oui | oui | oui | 128k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | oui | oui | oui | 256k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | oui | oui | oui | 256k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | oui | oui | non | 32k |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | non | non | non | — |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | non | non | non | — |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | non | non | non | — |
| glm-5.2 | Q4_K_M |
433,83 GiB | non | non | non | — |
Les tailles sont celles des fichiers réellement publiés à la compression de référence, un palier par ligne : Q4_K_M lorsque l’auteur la publie, le voisin le plus proche sinon. Chaque ligne indique laquelle elle affiche. Q4_K_M est notre plancher de qualité : en dessous, la perte s’entend dans les réponses. Un modèle qui ne tiendrait ici qu’avec une compression plus agressive est classé comme ne tenant pas, à dessein. Un tiret dans une colonne de contexte signifie que le modèle n’offre pas ce contexte, il n’y a donc rien à faire tenir.
Modèles qui tiennent — 16 sur les 20 modèles mesurés
- qwen3-1.7b
Q4_K_M— contexte 32k tokens - qwen3-4b-2507
Q4_K_M— contexte 256k tokens - gemma4-e2b
Q4_K_M— contexte 128k tokens - gemma4-e4b
Q4_K_M— contexte 128k tokens - qwen3-8b
Q4_K_M— contexte 32k tokens - granite-4.2-8b
Q4_K_M— contexte 128k tokens - gemma4-12b
Q4_K_M— contexte 256k tokens - gpt-oss-20b
Q4_K_M— contexte 128k tokens - mistral-small-24b
Q4_K_M— contexte 128k tokens - qwen3.8-27b
Q4_K_M— contexte 256k tokens - qwen3.6-27b
Q4_K_M— contexte 256k tokens - gemma4-26b-a4b
Q4_K_M— contexte 256k tokens - gemma4-31b
Q4_K_M— contexte 128k tokens - qwen3-coder-30b
Q4_K_M— contexte 256k tokens - qwen3.6-35b-a3b
Q4_K_M— contexte 256k tokens - gpt-oss-120b
Q4_K_M— contexte 32k tokens
Modèles qui ne tiennent pas — 4 sur les 20 modèles mesurés
- llama4-scout-17b
Q4_K_M— il manque 1,30 GiB - qwen3.8-flash-next
IQ4_XS— il manque 27,02 GiB - deepseek-v4-flash
IQ4_XS— il manque 67,29 GiB - glm-5.2
Q4_K_M— il manque 388,13 GiB
Les machines voisines
- Serveur avec 2× RTX 3090 (48 Go) — 47,20 Gio pour le modèle, 15 / 20 modèles
- Mac avec M4 Max et 64 Go — 61,00 Gio pour le modèle, 16 / 20 modèles
- Xiaomi AI Cube, 80 Go — prototype d’ingénierie — 77,00 Gio pour le modèle, 17 / 20 modèles
- PC avec Ryzen AI Max+ 395 et 128 Go unifiés — 96,00 Gio pour le modèle, 18 / 20 modèles
Prix et disponibilité
Ce que coûte une machine pèse autant que ce qui y tient : le prix a donc sa place sur cette page. Ci-dessous, uniquement ce que publie le fabricant, avec le marché concerné et le jour de la lecture.
À partir de 2.899 $ (États-Unis), publié le 2026-09-23 (Source). Déclaré par le fabricant
C’est le prix de cette configuration exacte : 64 Go avec le disque d’entrée de 512 Go. L’annonce ne cite que 1 699 $, ceux de la base de 24 Go avec le GPU 16 cœurs ; les 64 Go sur lesquels cette fiche est calculée coûtent donc 1 200 $ de plus, et la même machine avec 1 To de stockage vaut 3 199 $. Apple ne publie pas de prix en euros : ce chiffre est en dollars des États-Unis.
Ce que nous gagnons sur cette page
Rien, aujourd’hui. Cette page ne contient aucun lien d’affiliation, et aucun accord commercial ne se cache derrière ses chiffres. Si un lien d’achat y apparaît un jour, il sera signalé comme tel et la commission sera déclarée dans ce même bloc. Deux règles ne changeront pas ce jour-là : le classement de ce site est calculé avant toute disponibilité commerciale, et « meilleur » ne veut jamais dire « paie le plus ».