phi-4
Arquitectura denso40 CapasLicencia mitContexto máximo 16kVocabulario 100.352
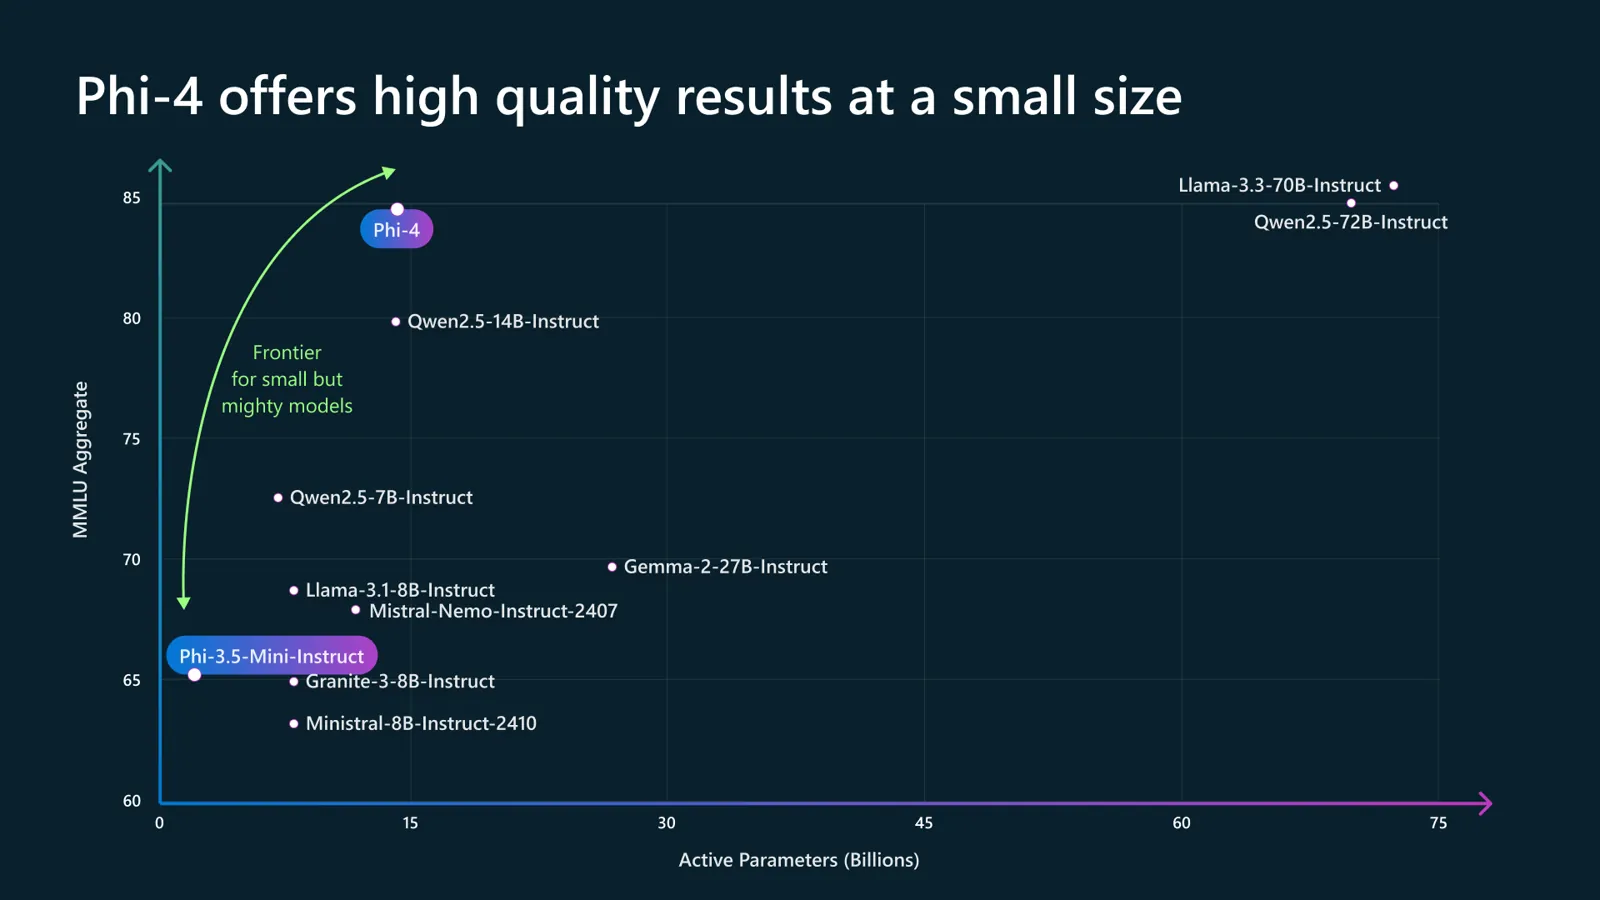
En Q4_K_M es un fichero de 8,43 GiB y entra en 17 de los 18 equipos que medimos (los de menos memoria: PC con RTX 3060 12 GB · PC con RTX 4070 12 GB). Aquí lo que llena la memoria es el fichero: incluso con su contexto máximo de 16k tokens, el contexto suma 3,12 GiB — y el mismo contenido, en tokens, cuesta en español ×1,33 lo que en inglés (en alemán, ×1,63).
Tamaño del modelo en Q4_K_M
Medido por Local AI Scope
Memoria de contexto a 8k tokens
Medido por Local AI Scope
Lo que cuesta el alemán frente al inglés
Medido por Local AI Scope
Vídeos: phi-4 1
Las mejores pruebas que hemos encontrado. Pulsa y se abre aquí mismo.
Los vídeos están en YouTube y no se carga nada de allí hasta que pulsas (modo sin cookies). La miniatura la servimos nosotros.
Tamaños de los ficheros publicados
Son los tamaños de los ficheros que publica su autor, sumados cuando el modelo viene partido en trozos. No es una estimación a partir del número de parámetros.
| Compresión | Tamaño del modelo |
|---|---|
Q8_0 |
14,51 GiB |
Q6_K |
11,20 GiB |
Q5_K_M |
9,88 GiB |
Q5_K_S |
9,45 GiB |
Q4_K_M |
8,43 GiB |
Q4_K_S |
7,86 GiB |
IQ4_XS |
7,40 GiB |
Q3_K_M |
6,86 GiB |
Memoria de contexto
Calculada con el patrón de atención que este modelo declara capa a capa, no con la fórmula genérica. Por eso la cifra suele ser bastante menor que la que dan otras calculadoras. El config.json de este modelo no dice cuánto mide cada cabeza de atención, y ese número es de lo que está hecha la memoria de contexto. Lo derivamos de dos cifras que sí declara, 5.120 unidades ocultas entre 40 cabezas de atención, que es lo que significa el tamaño de una cabeza y lo que la biblioteca de referencia da por supuesto: 128. Todas las cifras de esta sección se apoyan en esa derivación, así que se etiqueta aquí en vez de darse por sabida.
- 8k tokens → 1,56 GiB
Lo que cuesta en cada idioma
Medido ejecutando el tokenizador de este modelo sobre el mismo contenido en cuatro idiomas. Los tokens son lo que se paga en contexto, en memoria y en la factura de la nube.
| Tipo de texto | EN | ES | FR | DE |
|---|---|---|---|---|
| Código | — | ×1,28 | ×1,48 | ×1,68 |
| Contratos | — | ×1,40 | ×1,46 | ×1,77 |
| Correo de empresa | — | ×1,27 | ×1,38 | ×1,48 |
| Tickets de soporte | — | ×1,39 | ×1,59 | ×1,55 |
El inglés es la referencia: cada cifra es cuántas veces más tokens cuesta el mismo contenido en ese idioma. Media sobre todo el corpus: DE ×1,63.
Dónde cabe
Que quepa significa que caben el modelo, su memoria de contexto y el margen de trabajo al contexto indicado, dejándole al sistema lo suyo. 17 de los 18 equipos probados (Q4_K_M, 8k tokens).
Antes de darle a descargar: empezamos por lo bueno: a 29 de octubre de 2026, los cinco programas que seguimos abren Phi-4, porque su arquitectura (phi3) lleva mucho tiempo soportada. llama.cpp lo mueve en su última estable, la v0.8.0 (del 28 de octubre de 2026), y en cualquier compilación diaria actual. ollama run phi4 (sin guion) descarga un GGUF Q4_K_M de 8,43 GiB, del mismo tamaño que el de la tabla, también en un Mac: no hay versión MLX en la lista. Ollama tiene además phi4:14b-q8_0 (14,51 GiB). LM Studio lo ofrece con el GGUF de su programa de comunidad (lmstudio-community), también de 8,43 GiB en Q4_K_M. mlx-lm lo abre en la 0.32.2 (la versión MLX de 4 bits de mlx-community pesa 7,68 GiB), y vLLM en su estable, la 0.32.0. Dos cosas a tener en cuenta. El contexto se queda en 16k tokens: es lo que declara su config.json y ninguna fila de la tabla pasa de ahí, tengas la memoria que tengas (en las tarjetas de 12 GB la memoria lo para antes, en 8k). Y el idioma: Microsoft lo entrenó sobre todo en inglés (los datos multilingües son en torno al 8 %) y dice que no está pensado para usarlo en otros idiomas. Nosotros medimos lo que cuesta cada idioma en tokens, no lo bien que responde.