Ein Modell passt, wenn seine Gewichtsdatei, sein Kontextspeicher und der Puffer des ausführenden Programms zusammen in das passen, was übrig bleibt, nachdem das System seinen Anteil genommen hat. Auf einer 12-GB-Karte passen bei einem Vertrag von 12.000 Wörtern auf Englisch 8 der 26 gemessenen Modelle, auf Deutsch 4.
Deutsch ist unter den vier gemessenen Sprachen der Ausreißer, und zwar durchgehend.
Wie viel Speicher bleibt wirklich übrig
Eine 16-GB-Maschine bietet keine 16 GB. Das System bedient sich immer zuerst. Wir ziehen 0,8 GiB bei dedizierten Grafikkarten ab und 3 GiB bei Unified Memory oder Systemspeicher. Bei den PCs mit Ryzen AI Max+ gilt eine andere Grenze: AMD lässt die GPU höchstens 96 GiB von 128 GB und 160 GiB von 192 GB nutzen.
 PC mit Ryzen AI Max+ 395 und 128 GB Unified MemoryHardware-Datenblatt
- PC mit RTX 4060 8 GB: 7,20 GiB für das Modell, 7 von 26 Modellen bei 8k Kontext
- PC mit RTX 3060 12 GB: 11,20 GiB, 8 von 26
- PC mit RTX 4070 12 GB: 11,20 GiB, 8 von 26
- Mac mit M4 und 16 GB Unified Memory: 13,00 GiB, 9 von 26
- Büro-Notebook, nur CPU, 16 GB: 13,00 GiB, 9 von 26
- Mac mini mit M6 und 16 GB Unified Memory: 13,00 GiB, 9 von 26
- Mac mit M4 Pro und 24 GB: 21,00 GiB, 16 von 26
- Workstation mit RTX 4090 24 GB: 23,20 GiB, 17 von 26
- Mini-PC mit NPU und 32 GB LPDDR5X: 29,00 GiB, 19 von 26
- Mac mini mit M6 und 32 GB Unified Memory: 29,00 GiB, 19 von 26
- Server mit 2× RTX 3090 (48 GB): 47,20 GiB, 19 von 26
- Mac mit M4 Max und 64 GB: 61,00 GiB, 20 von 26
- Mac mini mit M5 Pro und 64 GB Unified Memory: 61,00 GiB, 20 von 26
- Xiaomi AI Cube, 80 GB — Technikprototyp: 77,00 GiB, 22 von 26
- PC mit Ryzen AI Max+ 395 und 128 GB Unified Memory: 96,00 GiB, 23 von 26
- Mac Studio mit M5 Max und 128 GB Unified Memory: 125,00 GiB, 23 von 26
- PC mit Ryzen AI Max+ PRO 495 und 192 GB Unified Memory: 160,00 GiB, 24 von 26
- Mac Studio mit M5 Ultra und 512 GB Unified Memory: 509,00 GiB, 26 von 26
Berechnet von Local AI Scope. „Passt” = Gewichte + Kontextspeicher + Programmpuffer ≤ verfügbarer Speicher, mit der Datei in Q4_K_M oder der nächstliegenden vom Autor veröffentlichten Kompression. Q4_K_M als Untergrenze ist ein erklärtes redaktionelles Kriterium, keine Messung: darunter sinkt die Qualität, um wie viel, haben wir nicht gemessen.
Nur eine Maschine erreicht 26: der Mac Studio mit M5 Ultra und 512 GB, der auch bei 32k 26 hält. glm-5.2 und glm-5.3-flash (187,04 GiB) passen auf keine andere, und deepseek-v4-flash (127,28 GiB) passt unter 192 GB nirgends: die Obergrenze einer 128-GB-Maschine liegt bei 23 von 26.
Der Sprung von 8 auf 12 GB fügt genau ein Modell hinzu, gemma4-12b. Was er wirklich kauft, ist Puffer. Der Sprung, der etwas ändert, liegt bei 24 GB: dort geht es von 8 auf 17.
Diesen letzten Sprung gibt es auch als Video (auf Englisch): derselbe PC erst mit der großen Karte, dann mit einer Einsteigerkarte, getestet vor allem mit Stimmen und Bildern. Die große ist überall schneller, doch bei Sprachmodellen bestimmt der Speicher, wie groß das Modell sein darf.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Warum Deutsch die Rechnung verschiebt
Kontext wird in Tokens reserviert, und derselbe Text ist auf Deutsch nicht dieselbe Anzahl Tokens wie auf Englisch: je nach Modell das 1,29- bis 1,62-Fache, gemessen mit dem echten Tokenizer jedes Modells auf einem eigenen parallelen Korpus (sha256[:16] 2f6c96b6ea0b161f).
| Maschine | Englisch | Spanisch | Französisch | Deutsch |
|---|---|---|---|---|
| PC mit RTX 4060 8 GB | 3 | 3 | 3 | 2 |
| PC mit RTX 3060 12 GB | 8 | 8 | 8 | 4 |
| PC mit RTX 4070 12 GB | 8 | 8 | 8 | 4 |
| Mac mit M4 und 16 GB | 9 | 9 | 9 | 5 |
| Büro-Notebook, 16 GB | 9 | 9 | 9 | 5 |
| Mac mini mit M6 und 16 GB | 9 | 9 | 9 | 5 |
| Mac mit M4 Pro und 24 GB | 14 | 14 | 14 | 12 |
| Workstation RTX 4090 24 GB | 17 | 17 | 17 | 14 |
| Mini-PC mit NPU und 32 GB | 19 | 19 | 19 | 17 |
| Mac mini mit M6 und 32 GB | 19 | 19 | 19 | 17 |
| Server 2× RTX 3090 (48 GB) | 19 | 19 | 19 | 17 |
| Mac mit M4 Max und 64 GB | 20 | 20 | 20 | 18 |
| Mac mini mit M5 Pro und 64 GB | 20 | 20 | 20 | 18 |
| Xiaomi AI Cube, 80 GB (Prototyp) | 22 | 22 | 22 | 20 |
| PC mit Ryzen AI Max+ 395 und 128 GB | 23 | 23 | 23 | 21 |
| Mac Studio mit M5 Max und 128 GB | 23 | 23 | 23 | 21 |
| PC mit Ryzen AI Max+ PRO 495 und 192 GB | 24 | 24 | 24 | 22 |
| Mac Studio mit M5 Ultra und 512 GB | 26 | 26 | 26 | 24 |
Gemessen von Local AI Scope. Vertragstext mit 12.000 Wörtern, mit derselben Antwortreserve, die der Modellfinder ansetzt: 10 % des Dokuments, mindestens 300 Wörter, hier also 1.200. Der Kontext wird mit der realen Fertilität jedes Modells berechnet, auf die Stufe des Programms aufgerundet und durch den vom Modell deklarierten Maximalkontext gedeckelt: qwen3-1.7b und qwen3-8b deklarieren 40k, auf Deutsch verlangt dieses Dokument 64k — sie fallen daher aus der deutschen Spalte. Gleiches Passt-Kriterium wie oben.
Deutsch verliert Modelle in allen 18 Zeilen. Deutsche Gründlichkeit eben. Spanisch und Französisch in keiner einzigen: bei 12.000 Wörtern ist das Dokument so lang, dass beide bereits auf derselben Kontextstufe landen wie Englisch. Und Deutsch beginnt viel früher: in 100-Wörter-Schritten von 100 bis 20.000 gemessen — mehr lässt der Modellfinder nicht zu — über die 18 Maschinen des Katalogs und mit dessen Antwortreserve, nimmt Deutsch ab 2.800 Wörtern Modelle weg und hört danach nicht mehr auf. Spanisch kostet erst ab 4.200 ein Modell, und nur zwischen 4.200 und 5.700, wieder zwischen 8.500 und 11.600 und ab 16.800; Französisch ab 4.200 nach demselben Muster. Es ist also keine Steigung, sondern eine Treppe: das Programm reserviert den Kontext in Zweierpotenzen. Bei 3.000 Wörtern verlangt qwen3-8b auf Englisch 8k Kontext und auf Deutsch 16k, während gemma4-12b in beiden Sprachen bei 8k bleibt.
Die Wahl des Tokenizers kostet mehr als die Wahl der Karte
Die Strafe folgt der Größe des Tokenizer-Vokabulars, nicht dem Hersteller. Zwei Modelle desselben Hauses können an entgegengesetzten Enden dieser Tabelle stehen.
| Modell | Vokabular | Deutsch | Größe (Referenz) |
|---|---|---|---|
gpt-oss-20b |
201.088 | 1,29 | 10,83 GiB |
llama4-scout-17b |
202.048 | 1,30 | 60,87 GiB |
qwen3.8-27b |
248.320 | 1,31 | 15,33 GiB |
gemma4-12b |
262.144 | 1,33 | 6,63 GiB |
mistral-small-24b |
131.072 | 1,40 | 13,35 GiB |
glm-5.2 |
154.880 | 1,49 | 433,83 GiB |
qwen3-8b |
151.936 | 1,62 | 4,68 GiB |
qwen3-coder-30b |
151.936 | 1,62 | 17,28 GiB |
Gemessen von Local AI Scope, dasselbe Korpus. Größe in Q4_K_M bzw. der nächstliegenden veröffentlichten Kompression.
Dieselbe deutsche Arbeit kostet auf qwen3-8b 26 % mehr Tokens als auf gpt-oss-20b, bevor über Qualität gesprochen wurde. Bei Quelltext mit deutschen Kommentaren teilen sich vier Modelle mit je 353 Tokens den vorletzten Platz, weil sie denselben Tokenizer verwenden: qwen3-1.7b, qwen3-4b-2507, qwen3-8b und qwen3-coder-30b; nur granite-4.2-8b braucht mit 381 noch mehr. Von diesen vieren ist qwen3-coder-30b das einzige, das ausdrücklich fürs Programmieren gebaut wurde, und mit 17,28 GiB auch das mit Abstand größte. Der ausführliche Fall steht auf Englisch.
Gemeinsame Tokenizer gibt es auch über Herstellergrenzen hinweg: Die beiden Nemotron-3.5-Modelle von NVIDIA in unserem Katalog, nemotron-3.5-super-120b und nemotron-3.5-lightning-30b, kommen auf Deutsch auf genau dieselben 1,40 wie mistral-small-24b und beim Quelltext mit deutschen Kommentaren auf dieselben 327 Tokens, weil alle drei denselben Tokenizer verwenden: Tekken von Mistral, mit 131.072 Einträgen.
Worauf vor dem Kauf zu achten ist

- Die Speichermenge, nicht die Kartennummer. Eine RTX 4070 mit 12 GB und eine RTX 3060 mit 12 GB lassen exakt dieselben 8 Modelle passen. Die 4070 führt sie schneller aus, sie lässt keines zusätzlich passen.
- Die tatsächliche Dateigröße, nicht die Parameterzahl.
gemma4-12bbelegt 6,63 GiB,qwen3-coder-30bbelegt 17,28 GiB. Das zweite passt in keine 12-GB-Maschine, egal was „30B” nahelegt. - Bei deutschen Dokumenten eine Stufe höher rechnen, und zwar früher als erwartet. Schon ab 2.800 Wörtern Vertragstext fällt auf dem PC mit RTX 4060 das erste Modell weg; bei Quelltext mit deutschen Kommentaren passiert es bereits ab 2.000.
- Unified Memory ist kein Grafikspeicher. Ein Mac mit 16 GB lässt 13 GiB übrig und damit 9 Modelle passen, 2 mehr als eine 4060 mit 8 GB, deutlich langsamer.
- Die Bandbreite entscheidet über das Tempo, nicht über das Passen. Das Notebook ohne Grafikkarte lässt dieselben 9 Modelle passen wie der Mac M4 mit 16 GB, bei 83 GB/s statt 120 GB/s.
Was hier nicht gemessen wird
Gemessen werden die Kosten der Sprache in Tokens und was daraus an Reservierung folgt. Nicht gemessen wird die Qualität der Antworten auf Deutsch: dafür müssten die Modelle ausgeführt und ihre Ausgaben bewertet werden, wofür eine GPU nötig ist, über die wir nicht verfügen. Eine Formel „Benchmark” zu nennen ist genau der Fehler, den diese Seite vermeiden soll.
Die Geschwindigkeiten neben jedem Ergebnis sind geschätzt, aus der vom Hersteller angegebenen Bandbreite. Sie entscheiden nie darüber, ob etwas passt.
Mit der eigenen Maschine nachrechnen
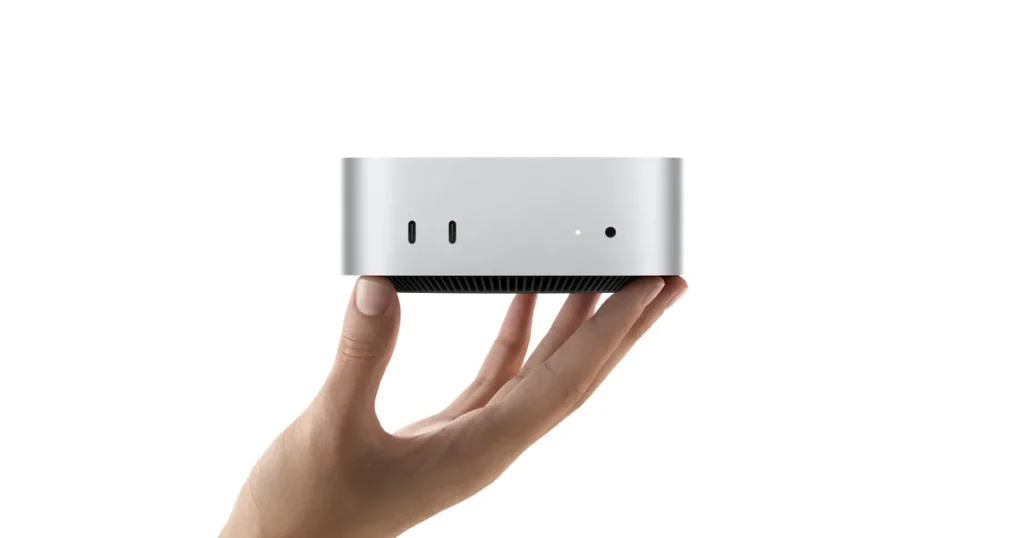
Ein Modell, das zu Hause antwortet, macht süchtig: Da lohnt es sich, gleich richtig zu kaufen. Der Modellfinder rechnet das für Ihre Maschine, Ihr Dokument und Ihre Sprache über alle 26 Modelle, vollständig im Browser: was Sie beschreiben, verlässt ihn nicht. Wer von der Hardware aus startet, findet in den Maschinenprofilen (etwa dem des Mac mini auf dem Foto) beide Listen. Das ausführende Programm zählt ebenfalls: siehe die Programm-Profile.