Un modelo cabe cuando entran a la vez su fichero de pesos, la memoria de contexto y el margen del programa que lo ejecuta, en lo que queda después de que el sistema coja lo suyo. Con 8 GB de tarjeta gráfica caben 7 de los 26 modelos que medimos a 8k de contexto, y bajan a 3 con un contrato de 12.000 palabras en español —los mismos 3 que en inglés, porque a esa extensión los dos idiomas ya caen en el mismo escalón de contexto—. En alemán bajan a 2.
La segunda cifra es la que no viene al lado del precio. El resto de esta página explica de dónde sale.
Cuánta memoria te queda de verdad
Un equipo de 16 GB no ofrece 16 GB. Reservamos 0,8 GiB en tarjetas gráficas dedicadas y 3 GiB en memoria unificada o de sistema, que es lo que se lleva el sistema operativo. En los PC con Ryzen AI Max+ manda otro límite: AMD solo deja a la gráfica 96 GiB de 128 GB y 160 GiB de 192 GB.
 PC con Ryzen AI Max+ 395 y 128 GB unificadosFicha del equipo
| Equipo | Memoria para el modelo | Caben a 8k | Caben a 32k |
|---|---|---|---|
| PC con RTX 4060 8 GB | 7,20 GiB | 7 de 26 | 3 de 26 |
| PC con RTX 3060 12 GB | 11,20 GiB | 8 de 26 | 8 de 26 |
| PC con RTX 4070 12 GB | 11,20 GiB | 8 de 26 | 8 de 26 |
| Mac con M4 y 16 GB unificados | 13,00 GiB | 9 de 26 | 9 de 26 |
| Portátil de oficina, solo CPU y 16 GB | 13,00 GiB | 9 de 26 | 9 de 26 |
| Mac mini con M6 y 16 GB unificados | 13,00 GiB | 9 de 26 | 9 de 26 |
| Mac con M4 Pro y 24 GB | 21,00 GiB | 16 de 26 | 14 de 26 |
| Estación con RTX 4090 24 GB | 23,20 GiB | 17 de 26 | 17 de 26 |
| Mini-PC con NPU y 32 GB LPDDR5X | 29,00 GiB | 19 de 26 | 19 de 26 |
| Mac mini con M6 y 32 GB unificados | 29,00 GiB | 19 de 26 | 19 de 26 |
| Servidor con 2× RTX 3090 (48 GB) | 47,20 GiB | 19 de 26 | 19 de 26 |
| Mac con M4 Max y 64 GB | 61,00 GiB | 20 de 26 | 20 de 26 |
| Mac mini con M5 Pro y 64 GB unificados | 61,00 GiB | 20 de 26 | 20 de 26 |
| Xiaomi AI Cube, 80 GB — prototipo de ingeniería | 77,00 GiB | 22 de 26 | 22 de 26 |
| PC con Ryzen AI Max+ 395 y 128 GB unificados | 96,00 GiB | 23 de 26 | 23 de 26 |
| Mac Studio con M5 Max y 128 GB unificados | 125,00 GiB | 23 de 26 | 23 de 26 |
| PC con Ryzen AI Max+ PRO 495 y 192 GB unificados | 160,00 GiB | 24 de 26 | 24 de 26 |
| Mac Studio con M5 Ultra y 512 GB unificados | 509,00 GiB | 26 de 26 | 26 de 26 |
Calculado por Local AI Scope. «Cabe» = pesos + memoria de contexto + margen del programa ≤ memoria disponible, con el fichero en Q4_K_M o en la compresión más cercana que publique el autor. Q4_K_M como suelo es un criterio editorial declarado, no una medición: por debajo la calidad se degrada, pero cuánto no lo hemos medido.
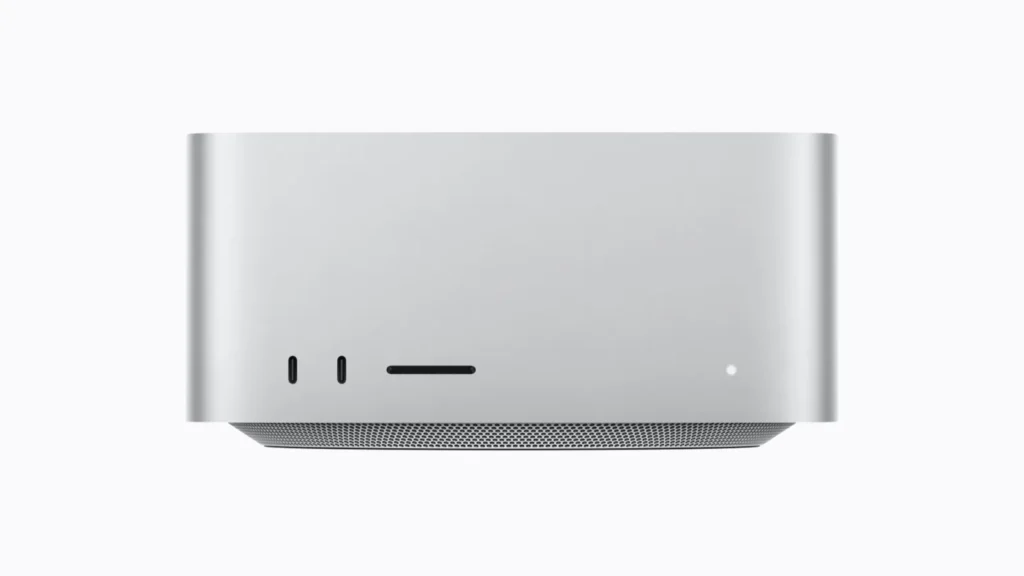
Solo una máquina llega a 26: el Mac Studio con M5 Ultra y 512 GB, que a 32k sigue con 26. glm-5.2 y glm-5.3-flash (187,04 GiB) no caben en ninguna otra, y deepseek-v4-flash (127,28 GiB) no cabe por debajo de 192 GB: el techo de un equipo de 128 GB es 23 de 26.
El salto de 8 a 12 GB añade exactamente un modelo, gemma4-12b: la lista de 12 GB contiene la de 8 GB y uno más. Lo que de verdad compra ese salto es margen, no variedad. El salto que cambia la película es el de 24 GB, donde se pasa de 8 a 17.
Ese último salto, en vídeo (en inglés): el mismo PC con la tarjeta grande y con una de gama de entrada, sobre todo con voz e imagen. La grande gana siempre en velocidad; en modelos de lenguaje, el tamaño lo marca la memoria.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
Dónde deja de servir la comparación en inglés
El contexto se reserva en tokens, y el mismo texto no son los mismos tokens en español que en inglés: entre 1,16 y 1,35 veces más según el modelo, medido con el tokenizador real de cada uno sobre un corpus paralelo propio (sha256[:16] 2f6c96b6ea0b161f).
Con un contrato de 12.000 palabras, así queda el recuento:
| Equipo | Inglés | Español | Francés | Alemán |
|---|---|---|---|---|
| PC con RTX 4060 8 GB | 3 | 3 | 3 | 2 |
| PC con RTX 3060 12 GB | 8 | 8 | 8 | 4 |
| PC con RTX 4070 12 GB | 8 | 8 | 8 | 4 |
| Mac con M4 y 16 GB | 9 | 9 | 9 | 5 |
| Portátil sin GPU, 16 GB | 9 | 9 | 9 | 5 |
| Mac mini con M6 y 16 GB | 9 | 9 | 9 | 5 |
| Mac con M4 Pro y 24 GB | 14 | 14 | 14 | 12 |
| Estación con RTX 4090 24 GB | 17 | 17 | 17 | 14 |
| Mini-PC con NPU y 32 GB | 19 | 19 | 19 | 17 |
| Mac mini con M6 y 32 GB | 19 | 19 | 19 | 17 |
| Servidor con 2× RTX 3090 (48 GB) | 19 | 19 | 19 | 17 |
| Mac con M4 Max y 64 GB | 20 | 20 | 20 | 18 |
| Mac mini con M5 Pro y 64 GB | 20 | 20 | 20 | 18 |
| Xiaomi AI Cube, 80 GB (prototipo) | 22 | 22 | 22 | 20 |
| PC con Ryzen AI Max+ 395 y 128 GB | 23 | 23 | 23 | 21 |
| Mac Studio con M5 Max y 128 GB | 23 | 23 | 23 | 21 |
| PC con Ryzen AI Max+ PRO 495 y 192 GB | 24 | 24 | 24 | 22 |
| Mac Studio con M5 Ultra y 512 GB | 26 | 26 | 26 | 24 |
Medido por Local AI Scope. Documento tipo contrato de 12.000 palabras con la misma reserva de respuesta que aplica el buscador: el 10 % del documento con un mínimo de 300 palabras, aquí 1.200. El contexto se calcula con la fertilidad real de cada modelo, se redondea al escalón del programa y se topa con el contexto máximo que el modelo declara: qwen3-1.7b y qwen3-8b declaran 40k y en alemán este documento pide 64k, así que quedan fuera de la columna alemana. Mismo criterio de encaje que la tabla anterior.
A 12.000 palabras el español da exactamente la misma lista que el inglés, y el francés también: el documento es tan largo que los tres idiomas ya caen en el mismo escalón de contexto. El alemán no, y pierde modelos en las 18 máquinas. Que el español empate aquí no significa que salga gratis: significa que a esta extensión concreta ha dejado de notarse. La sección siguiente enseña dónde sí se nota.
Por qué esto es una escalera y no una cuesta
Con documentos cortos el idioma no mueve nada. Midiendo en pasos de 100 palabras sobre los 18 equipos del catálogo, con un documento tipo contrato el español no quita ningún modelo hasta las 4.200 palabras; el alemán empieza mucho antes, a las 2.800.
Y a partir de ahí el sobrecoste no crece: aparece y desaparece, como el Guadiana. La razón es el escalón. El programa reserva el contexto en potencias de dos, así que la diferencia se absorbe hasta que cruza un umbral, salta de golpe, y se vuelve a absorber en cuanto el inglés alcanza ese mismo escalón:
| Idioma | Primer modelo que se pierde | Tramos en los que cuesta al menos un modelo |
|---|---|---|
| Español | 4.200 palabras | 4.200–5.700 · 8.500–11.600 · desde 16.800 |
| Francés | 4.200 palabras | 4.200–5.700 · 8.700–11.600 · desde 16.600 |
| Alemán | 2.800 palabras | desde 2.800, sin un solo tramo de descanso |
Documento tipo contrato, barrido en pasos de 100 palabras de 100 a 20.000 —el máximo que admite el buscador— sobre los 18 equipos, con su misma reserva de respuesta. «Cuesta un modelo» = al menos una de las 18 máquinas hace caber menos modelos que en inglés. A 5.000 palabras, por ejemplo, qwen3-8b pide 8k de contexto en inglés y 16k en español, mientras gemma4-12b se queda en 8k en los dos: por eso el sobrecoste aparece y se va. Doblar el contexto reservado no dobla la memoria total, pero en un equipo justo es lo que decide.
Conclusión práctica para comprar: si tu trabajo son correos y notas, el idioma da igual. Si son contratos o expedientes en español, mira tu extensión real antes de decidir: entre 4.200 y 5.700 palabras, otra vez entre 8.500 y 11.600 y de nuevo desde 16.800, el español cuesta un modelo; fuera de esos tramos, no. En alemán no hay tramo de descanso a partir de las 2.800.
Qué mirar antes de pagar

- La memoria de la tarjeta, no el modelo de la tarjeta. Una RTX 4070 de 12 GB y una RTX 3060 de 12 GB hacen caber exactamente los mismos 8 modelos. La 4070 los ejecuta más rápido; no hace caber ninguno más.
- El tamaño real del fichero publicado, no el número de parámetros.
gemma4-12bocupa 6,63 GiB yqwen3-coder-30bocupa 17,28 GiB: el segundo no entra en ninguna máquina de 12 GB por mucho que la ficha diga «30B». - La memoria unificada del Mac no es memoria de gráfica. Un Mac de 16 GB deja 13 GiB y hace caber 9 modelos, 2 más que una 4060 de 8 GB, a bastante menos velocidad.
- El ancho de banda decide la velocidad, no el encaje. El portátil sin GPU de la tabla hace caber los mismos 9 modelos que el Mac M4 de 16 GB, y son exactamente los mismos 9, a 83 GB/s frente a 120 GB/s.
¿Y un Mac pequeño? Este vídeo en español carga un modelo tras otro en el Mac mini más básico: con soltura mientras cabe en la memoria; cuando la desborda de largo, tira del disco y se arrastra.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
Lo que aquí no se mide
Se mide el coste del idioma en tokens y lo que eso obliga a reservar. No se mide la calidad de la respuesta en español: eso exige ejecutar los modelos y evaluar lo que contestan, hace falta una GPU que no tenemos, y llamar «benchmark» a una fórmula es exactamente el error que este sitio existe para no cometer.
Las velocidades que aparecen junto a cada encaje son estimadas, a partir del ancho de banda del fabricante y de eficiencias supuestas. No deciden si algo cabe.
Calcúlalo con tu equipo
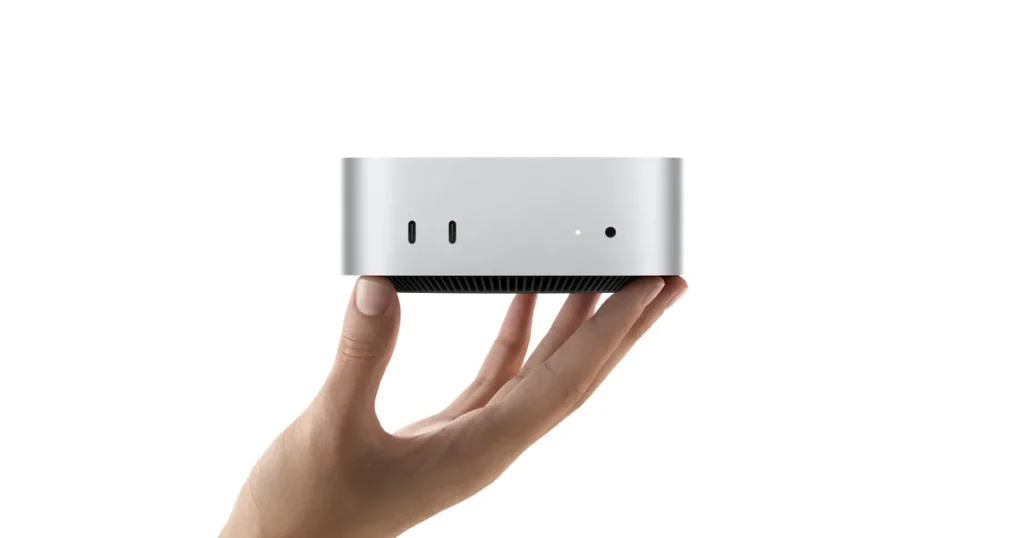
Un modelo que te contesta en casa engancha: mejor acertar a la primera. El buscador de modelos hace esta cuenta con tu máquina, tu documento y tu idioma para los 26 modelos, y funciona entero en tu navegador: lo que describas no sale de él. Si prefieres empezar por la máquina, las fichas de equipo (como la del Mac mini de la foto) traen las dos listas, la de lo que cabe y la de lo que no. Y el programa con el que lo vas a ejecutar también decide: está en las fichas de programas.