Nehmen Sie llama.cpp, wenn ein Modell auf Ihrem eigenen Rechner laufen soll, egal welcher: Mac, Windows oder Linux, mit oder ohne Grafikkarte. Nehmen Sie vLLM, wenn viele Menschen gleichzeitig von einem Linux-Rechner mit NVIDIA- oder AMD-Karte bedient werden sollen. Beide haben Code für alle 28 unserer Modelle: die stabile Version von llama.cpp seit v0.9.0 (4. November), die von vLLM seit 0.34.0 (16. November). Die Hardware entscheidet.
Das ist die Kurzfassung, und sie stammt aus dem Code, nicht aus dem Bauchgefühl. Am 4. November 2026 haben wir die stabilen Versionen beider Projekte genommen, vLLM 0.33.0 und llama.cpp v0.8.0, sie mit den 28 Modellen unseres Modellfinders und den 18 Rechnern unserer Liste abgeglichen und Dateien, Server, Speicher und das, was jedes von sich aus sendet, nebeneinandergelegt. Am 17. November haben wir uns den Code von vLLM für die neue Version 0.34.0 noch einmal angesehen, die Mistral Large 4 mitbringt und anders mit dem Speicher umgeht. Mit der Stoppuhr haben wir sie nicht gemessen: Einen Tempo-Sieger gibt es hier also nicht, dafür am Ende den Weg zu Ihrer eigenen Zahl.
vLLMProgramm-Datenblatt llama.cppProgramm-Datenblatt
| vLLM | llama.cpp | |
|---|---|---|
| Gelesene stabile Versionen | 0.34.0 (16. November); davor 0.33.0 (2. November) | v0.9.0 (4. November, 13:08 UTC), Build b12110; davor v0.8.0 (b11960) |
| Was es ist | Ein Python-Server, gebaut, um Modelle für viele Nutzer bereitzustellen | Eine Engine in C und C++ mit Kommandozeile, Server und Chat-Seite |
| Modelle unseres Katalogs, die sein Code kennt (28) | 28 in 0.34.0 (27 in 0.33.0) | 28 in v0.9.0 (27 in v0.8.0) |
| Unsere 18 Rechner, auf denen es den Grafikchip nutzt | 6, laut seiner Dokumentation | 15 |
| Systeme | Linux; Windows nur über WSL; Mac nur auf dem Prozessor, experimentell | Windows, macOS und Linux, mit fertigen Downloads |
| Dateiformat | safetensors (das Originalmodell) und Formate wie AWQ, GPTQ oder FP8; GGUF nur über ein eigenes Plugin | GGUF; safetensors erst nach dem Konvertieren |
| Lokaler Server | 0.0.0.0:8000 (das ganze Netz), ohne Schlüssel |
127.0.0.1:9931 (nur Ihr Rechner), ohne Schlüssel |
| Gleichzeitige Anfragen (Server, ab Werk) | Bis zu 256 auf einer Karte unter 70 GB | 4 Slots |
| Grafikspeicher | Seit 0.34.0 den nach dem Aufwärmen freien Speicher, abzüglich einer Sicherheitsreserve (davor 92 % der Karte) | So viel, wie Modell und Kontext brauchen |
| Was es von sich aus sendet | Nutzungsstatistiken beim Start und alle 10 Minuten, sofern Sie sie nicht abschalten | Nichts (keine Telemetrie, keine Update-Prüfung) |
| Lizenz | Apache 2.0 | MIT |
Dieselben 28 Modelle, zwei ganz verschiedene Aufgaben
Bei dieser Zahl hatten wir einen klaren Sieger erwartet, und es gibt keinen. Wir haben die Architektur, die jedes unserer 28 Modelle in seiner eigenen config.json angibt, im Modellregister von vLLM 0.33.0 und im Konverter von llama.cpp v0.8.0 nachgeschlagen. Ergebnis (im Code gelesen am 4. November 2026): je 27 von 28, und es sind dieselben 27, von Qwen3 1.7B bis gpt-oss-120b, über Gemma 4, DeepSeek V4 Flash und Flint. Am selben Tag hat llama.cpp v0.9.0 veröffentlicht, die das 28. hinzufügt. Und am 16. November hat vLLM 0.34.0 es ebenfalls ergänzt: Wir haben sein Modellregister am 17. November gelesen, und jetzt kennen beide alle 28.
Ehrlicherweise: Das ist Unterstützung im Code, keine 28 Modelle, die wir einzeln gestartet haben. Wenn beide dieselben Modelle kennen, was trennt sie dann? Wofür sie gebaut wurden. llama.cpp entstand, um ein Modell auf gewöhnliche Hardware zu bringen. vLLM entstand, um ein Modell auf großen Karten einer ganzen Menge bereitzustellen, und alles andere folgt daraus.
Auf welchen unserer 18 Rechner jedes läuft
Hier fällt die Wahl meist von selbst. llama.cpp veröffentlicht fertige Builds für Windows, macOS und Linux, mit CUDA für NVIDIA, Metal für Apple Silicon und ROCm oder Vulkan für AMD. Von den 18 Rechnern in unserem Modellfinder nutzt es auf 15 den Grafikchip: die 5 PCs mit NVIDIA-Karte, die 8 Macs und die 2 PCs mit Ryzen AI Max. Auf den übrigen 3 läuft es auf dem Prozessor.
Die Liste von vLLM ist kürzer. Es braucht eine NVIDIA-Karte mit Compute Capability 7.5 oder höher (unsere RTX 3060, 4060, 4070, 4090 und die 2 RTX 3090 erfüllen das) oder einen AMD-Chip aus seiner ROCm-Liste, die die Serie Ryzen AI MAX / AI 300 nennt: Unser Ryzen AI Max+ 395 ist dabei, der PRO 495 nicht, denn er gehört zur Serie Max PRO 400, die dort noch nicht steht. Macht 6 von 18 mit Grafikchip laut Dokumentation; auf den übrigen der Prozessor (auf dem Mac zusätzlich das Community-Plugin vLLM-Metal). Es läuft unter Linux; unter Windows über WSL. Seit 0.33.0 sind seine fertigen Pakete nur noch für CUDA 13.0 gebaut.
Und der Mac? vLLM nennt seine macOS-Unterstützung experimentell, nur auf dem Prozessor und mit FP32 und FP16. Seine Installationsseite sagt weiterhin, man müsse es selbst kompilieren, obwohl die Veröffentlichung 0.34.0, wie schon 0.33.0, sehr wohl ein fertiges CPU-Paket für Apple Silicon mitbringt. Für den Grafikchip eines Macs gibt es vLLM-Metal, ein von der Community gepflegtes Plugin, das MLX nutzt und MLX-Modelle erwartet. Wenn Sie am Mac sitzen, ist MLX vs. llama.cpp der Vergleich, der zählt.
Dateien: GGUF auf der einen Seite, das Originalmodell auf der anderen
llama.cpp verarbeitet GGUF, das Ein-Datei-Format, das dieses Projekt erfunden hat, mit Gewichten, die bereits auf 1 bis 8 Bit verkleinert sind (einige Versionen bleiben bei 16). Unser Katalog führt 559 fertige GGUF-Versionen der 28 Modelle, zwischen 2 und 27 pro Modell, sodass llama-server -hf plus Repository-Name oft schon genügt.
vLLM liest das Modell so, wie sein Hersteller es veröffentlicht, in safetensors, dazu eine lange Liste von Formaten für Grafikkarten: AWQ, GPTQ, FP8, MXFP4 und weitere. GGUF ist nicht mehr eingebaut: Es steckt in einem eigenen Plugin, vllm-gguf-plugin, das die vLLM-Dokumentation selbst als hochexperimentell bezeichnet. In der Praxis braucht vLLM auf einer Heimkarte eine 4- oder 8-Bit-Fassung in einem seiner Formate, denn die Originalgewichte eines 27B-Modells passen nicht in 24 GB.

1 Person oder 256: wie jedes bedient
Das ist die Paradedisziplin von vLLM. Es nimmt Anfragen an, wie sie eintreffen, und schiebt jede neue in den laufenden Stapel, sobald ein Platz frei wird, statt auf die langsamste Antwort zu warten. Auf einer Karte unter 70 GB verarbeitet sein Server ab Werk bis zu 256 Anfragen gleichzeitig (1.024 auf den größten Rechenzentrumskarten). Sein Speichersystem, PagedAttention, legt den Gesprächs-Cache in kleinen Seiten ab, damit nichts verschwendet wird.
llama-server ist bescheidener: v0.9.0 öffnet wie v0.8.0 ab Werk 4 Slots, die sich einen Cache teilen. Für Sie, Ihre Familie oder ein kleines Team reicht das locker; für eine App mit Hunderten Nutzern zieht vLLM genau hier davon.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Das Erklärvideo von IBM Technology, das wir über seine Untertitel angesehen haben, erzählt dieselbe Geschichte in rund 10 Minuten: llama.cpp bringt Modelle mit Quantisierung, GGUF und Prozessor auf gewöhnliche Hardware; vLLM ist zum Skalieren da, und das kontinuierliche Batching wird mit Pfannkuchen auf der Grillplatte erklärt (wir sind dafür). Beide sprechen, so erinnert das Video, dieselbe API im OpenAI-Stil, Ihr Code ändert sich beim Wechsel also kaum.
Speicher: die ganze Karte auf einen Schlag oder so viel, wie das Modell braucht
vLLM ist absichtlich gierig, und seit 0.34.0 noch mehr. Bis 0.33.0 reservierte es beim Start 92 % des Kartenspeichers, für das Modell und einen großen Cache für all die parallelen Gespräche. Im Quellcode von 0.34.0 (gelesen am 17. November 2026, nicht gemessen) steigt der Standard auf NVIDIA und AMD auf die ganze Karte: Nach dem Laden des Modells und dem Aufwärmen gibt vLLM seinem Cache den noch freien Speicher, abzüglich einer Sicherheitsreserve von mindestens 1 GiB (3 GiB bei AMD) und des Platzes, den sein eigener Arbeitsspeicher braucht. Auf einem Server, der nur das macht, ideal. Auf einem Desktop-PC behält, was schon auf der Karte lag, Ihr Bildschirm eingeschlossen, seinen Platz; ein Programm, das Sie danach öffnen, findet die Karte voll vor.
llama.cpp fordert, was Modell und Kontext brauchen. Ab Werk nimmt es den Kontext, mit dem das Modell trainiert wurde, und kürzt ihn bei Speichermangel, bis alles passt, nie unter 4.096 Token. Und ist das Modell größer als die Karte, kann es einige Schichten im Arbeitsspeicher lassen und auf dem Prozessor rechnen: langsamer, aber es startet.
Offene Türen und was jedes sendet
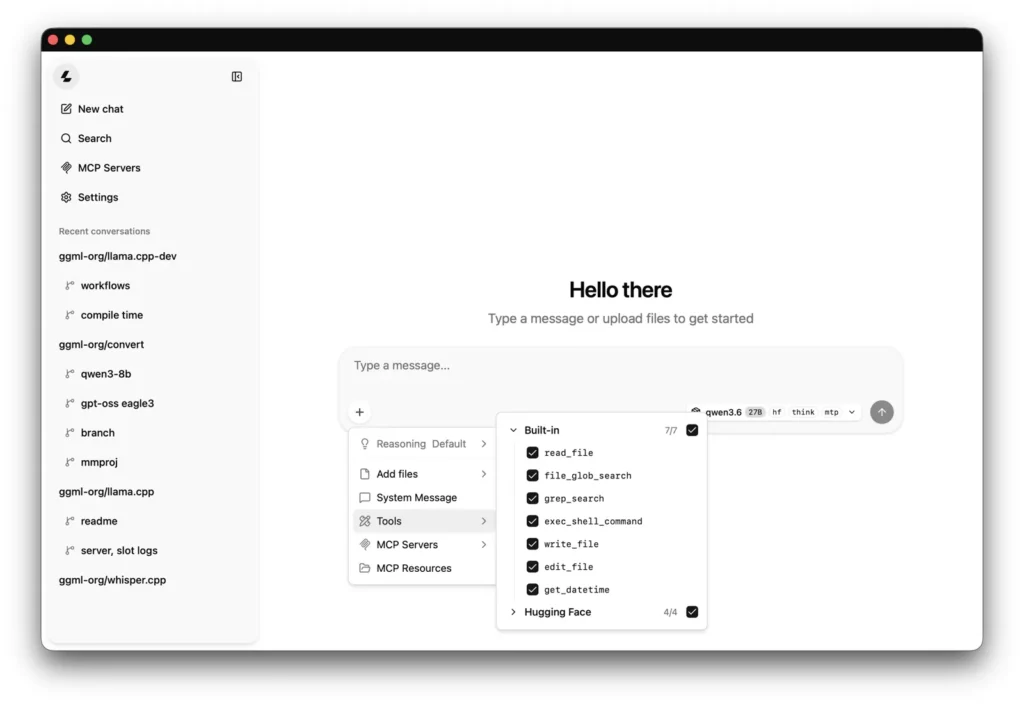
Das ist der Teil, der uns auf dieser Website am wichtigsten ist. llama.cpp lauscht nur auf Ihrem eigenen Rechner (127.0.0.1), auf Port 9931, hat keine Telemetrie und keine Update-Prüfung und verbindet sich nur, wenn Sie es darum bitten: um ein Modell herunterzuladen oder ein Bild über seine Webadresse zu holen. Sein Server liefert unter derselben Adresse auch eine Chat-Seite und nimmt ab Werk Aufrufe von jeder Webseite an, mit einer Warnung in der Konsole, wenn Sie keinen Schlüssel gesetzt haben.
vLLM sammelt ab Werk anonyme Nutzungsdaten und sagt das auch: Es sendet sie beim Start und danach alle 10 Minuten an stats.vllm.ai und legt eine Kopie in ~/.config/vllm/usage_stats.json ab, damit Sie genau nachlesen können, was hinausging. Eine Zeile schaltet das ab: VLLM_NO_USAGE_STATS=1 (es gibt 3 weitere Wege). Aufrufe von Webseiten sind gesperrt, bis Sie sie erlauben. Jede Verbindung mit ihrer Quelle steht auf den Seiten zu vLLM und llama.cpp.
Was wir nehmen würden, und was wir nicht wissen
- Ein Modell auf Ihrem eigenen Rechner, für Sie: llama.cpp. Es läuft auf allen 18 unserer Rechner und nutzt auf 15 den Grafikchip.
- Ein Mac: llama.cpp, mit Metal. vLLM läuft auf dem Mac nur auf dem Prozessor und experimentell.
- Eine App oder ein Team, das gleichzeitig dasselbe Modell nutzt, unter Linux mit NVIDIA-Karte: vLLM. Bis zu 256 gleichzeitige Anfragen ab Werk sind sein ganzer Daseinszweck.
- Das Originalmodell oder GPU-Formate wie FP8 oder AWQ: vLLM. Für fertige 4-Bit-Dateien, die auf eine Heimkarte passen, GGUF und llama.cpp.
Was wir nicht wissen: welches auf Ihrem Rechner mit Ihrem Modell schneller ist. Wir haben es nicht gemessen, und es hängt von Karte, Modell, Format und davon ab, wie viele gleichzeitig fragen. Beide bringen einen Benchmark mit: vllm bench serve und llama-bench. Gleiches Modell, ähnliche Größe, gleicher Prompt, und Sie haben Ihre eigene Zahl.
Lust loszulegen? Unsere Anleitungen begleiten Sie dabei, llama.cpp einzurichten und vLLM einzurichten, und wenn etwas hakt, helfen llama.cpp funktioniert nicht und vLLM funktioniert nicht. Wenn Sie eines davon gegen Ollama abwägen, machen vLLM vs. Ollama und llama.cpp vs. Ollama dort weiter, wo dieser Vergleich aufhört, und der Modellfinder zeigt Ihnen, welche der 28 in den Speicher Ihres Rechners passen.