Sur un Mac Apple Silicon, les deux font tourner les modèles sur la puce graphique via Metal. Prenez llama.cpp pour le choix le plus large : sa version 0.8.0 a du code pour 27 des 28 modèles de notre catalogue, mlx-lm 0.32.2 pour 22, et les 28 ont un GGUF prêt. Prenez mlx-lm pour les versions MLX, Python et l’affinage LoRA.
Voilà la réponse courte, et elle nous plaît parce qu’elle vient de la lecture du code, pas d’une intuition. Le 30 octobre 2026, nous avons lu les versions stables des deux projets, confronté à leur code les 27 modèles que comptait ce jour-là notre trouveur de modèle, et mis côte à côte serveurs, réglages d’usine et ce que chacun envoie de lui-même. Nous ne les avons pas chronométrés : pas de vainqueur en vitesse sur cette page, mais vers la fin, de quoi trancher sur votre propre Mac.
 MLX (mlx-lm)Fiche logiciel
 llama.cppFiche logiciel
| mlx-lm | llama.cpp | |
|---|---|---|
| Version stable au 30 octobre 2026 | 0.32.2 (16 octobre), qui installe mlx 0.32.4 | v0.8.0 (28 octobre), compilation b11960 |
| Ce que c’est | Le paquet Python d’Apple pour exécuter et affiner des modèles de langage avec MLX | Un moteur en C et C++ avec ligne de commande, serveur et page de discussion |
| Modèles de notre catalogue connus de son code (27 au 30 octobre 2026) | 22 | 27 |
| Format de fichier | Dossiers MLX (safetensors) ; ne lit pas le GGUF | GGUF ; les safetensors seulement après conversion |
| Installation sur Mac | pip install mlx-lm (Python 3.11 ou plus, natif ARM) |
brew install llama.cpp ou le téléchargement macOS ARM64 |
| Serveur local | mlx_lm.server sur 127.0.0.1:8080 |
llama-server sur 127.0.0.1:9931 |
| Longueur de réponse si la requête ne la précise pas | 512 tokens | Sans limite |
| Requêtes simultanées (serveur) | Regroupe celles qui peuvent l’être ; 1 modèle chargé | 4 emplacements d’office |
| Affinage | LoRA avec mlx_lm.lora |
Un exemple que son propre README dit en chantier |
| Ce qu’il envoie de lui-même | Rien ; il ne sort que sur demande (téléchargements et leur vérification de changements, images par URL, calibrage) | Rien (ni télémétrie ni vérification de mises à jour) ; il ne sort que sur demande (téléchargements, images par URL) |
| Licence | MIT | MIT |
Deux moteurs, aucune fenêtre
Aucun des deux n’est une application à lancer d’un double-clic. mlx-lm est le paquet Python que l’équipe MLX d’Apple maintient au-dessus de son framework mlx : vous l’installez avec pip et vous lui parlez par des commandes comme mlx_lm.chat, mlx_lm.generate ou mlx_lm.server. llama.cpp est le moteur en C et C++ qui se cache sous une foule de logiciels d’IA locale ; sur Mac, vous l’obtenez avec Homebrew (qui sert la 0.8.0 depuis le 28 octobre) ou en téléchargement précompilé pour macOS ARM64. Les deux sont open source sous licence MIT, et c’est pour cela que nous avons pu lire chaque ligne citée ici.
Si ce que vous cherchez vraiment, c’est une fenêtre avec une zone de discussion, ce match n’est pas le vôtre : notre comparatif LM Studio vs llama.cpp couvre l’application qui embarque les deux moteurs, et MLX vs Ollama le serveur qui fait aussi tourner des modèles MLX. Cette page sert au moment où vous descendez d’un étage pour choisir le moteur vous-même.
Les 27 que nous avons vérifiés : llama.cpp les connaît tous, mlx-lm 22
Voici le chiffre que nous étions venus chercher. Nous avons pris l’architecture que déclare chacun des 27 modèles dans son propre config.json sur Hugging Face, puis nous l’avons cherchée dans le code des deux : le registre de conversion de llama.cpp v0.8.0, résolu comme le fait son convertisseur, et le dossier des modèles de mlx-lm 0.32.2. Résultat (lu dans le code, 30 octobre 2026) : llama.cpp a du code pour 27 sur 27, mlx-lm pour 22. Les 22 que connaît mlx-lm, llama.cpp les connaît aussi. Aucun modèle de notre catalogue ne tourne seulement avec mlx-lm.
Depuis cette lecture, Mistral Large 4 est entré dans notre catalogue comme 28e modèle, et c’est l’exception : son code se trouve dans les compilations quotidiennes de llama.cpp depuis la b11998 (30 octobre 2026), pas dans la v0.8.0, qui restait la dernière version stable le 1er novembre (le canal stable l’ouvre depuis la v0.9.0, compilation b12110, publiée le 4 novembre 2026) ; mlx-lm 0.32.2 n’a pas de code pour lui, et la demande de fusion qui l’ajoute (#2018) était encore ouverte ce jour-là. Avec 591,21 Gio en Q4_K_M, il ne tient sur aucune machine de notre catalogue, pas même sur le Mac Studio de 512 Go.
Deux précisions honnêtes. Il s’agit de prise en charge dans le code, pas de 27 modèles lancés un par un ; et le code peut arriver dans mlx-lm à sa prochaine version, d’où la date partout. L’autre précision est un bonus pour llama.cpp : pour 15 des 27 vérifiés, son convertisseur a aussi une classe pour la partie image ou audio du modèle, ce fichier séparé qu’il appelle projecteur.

Fichiers : le GGUF d’un côté, les dossiers MLX de l’autre
Aucun ne lit le format de l’autre. mlx-lm ne demande même pas de fichiers .gguf à Hugging Face : il télécharge des dossiers MLX, comme ceux de mlx-community, ou convertit lui-même le modèle d’origine avec mlx_lm.convert. llama.cpp n’exécute que du GGUF ; pour partir des safetensors d’origine, vous les convertissez d’abord avec le script convert_hf_to_gguf.py qu’il fournit.
En pratique, llama.cpp part avec une longueur d’avance : notre catalogue recense un dépôt GGUF pour chacun des 28 modèles, avec 2 à 27 quantifications prêtes chacun (559 au total), si bien que llama-server -hf suivi du nom du dépôt suffit souvent. Côté mlx-lm, nous n’avons pas compté modèle par modèle les versions MLX déjà prêtes ; quand il n’y en a pas, la conversion tient en une commande, et la session d’Apple ci-dessous la montre.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
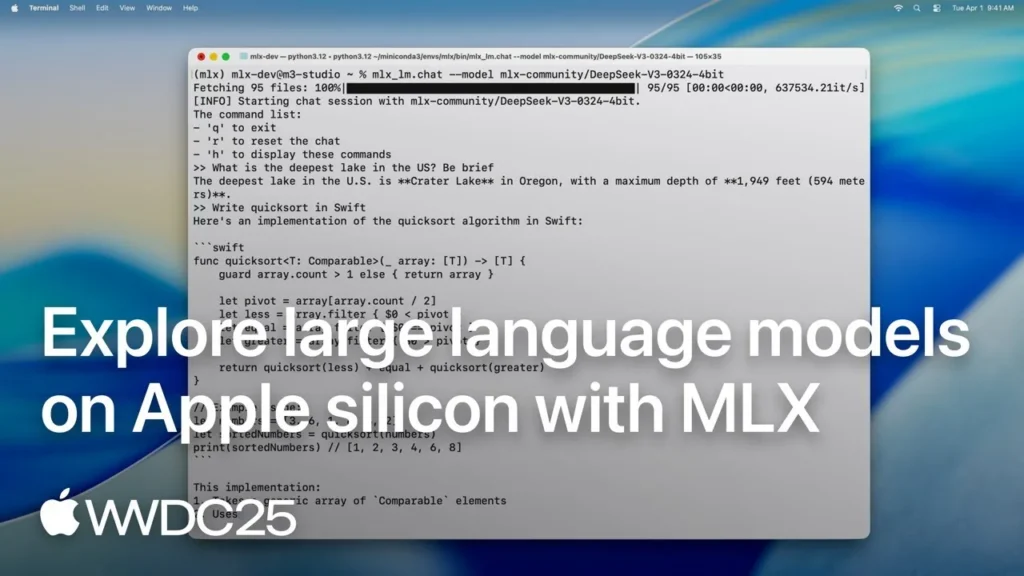
C’est la session d’Apple à la WWDC25 sur les modèles de langage avec MLX, en anglais. Nous l’avons regardée via ses sous-titres : elle montre mlx_lm.generate, la conversion et la quantification d’un modèle avec mlx_lm.convert, et l’entraînement d’un adaptateur LoRA sur un modèle en 4 bits. Ses modèles datent de 2025 ; les versions de cette page, d’aujourd’hui. Si c’est le poids des fichiers qui vous préoccupe, notre comparatif MLX vs GGUF pèse les mêmes modèles dans les deux formats.
Quantification : moins de réglages ou plus de fichiers
mlx-lm peut quantifier pendant la conversion : ajoutez -q. Par défaut, c’est son mode affine en 4 bits par groupes de 64 ; l’option --q-mode accepte aussi mxfp4, nvfp4 et mxfp8, et 4 recettes mixtes toutes faites (mixed_2_6, mixed_3_4, mixed_3_6 et mixed_4_6) gardent plus de bits pour les parties sensibles. Il existe aussi des voies plus fines (DWQ, AWQ, GPTQ), si ce genre de soirée vous tente.
llama.cpp fait l’inverse : son convertisseur écrit le modèle en 16 bits par défaut (ou en 32, en 8 ou en ternaire), puis llama-quantize produit les noms habituels, comme Q4_K_M, Q5_K_M ou la famille IQ. La bonne nouvelle, c’est que vous le faites rarement vous-même, car ces fichiers sont déjà dans les dépôts. Le hic, c’est de choisir : un seul dépôt peut proposer jusqu’à 27 quantifications.
Serveurs : 8080 contre 9931, et la surprise des 512 tokens
Les deux vous donnent un serveur local avec des routes à la manière d’OpenAI, qui n’écoute que sur votre propre Mac (127.0.0.1) et ne demande aucune clé. C’est dans les détails qu’ils divergent :
- mlx_lm.server écoute sur le port 8080. Si la requête ne dit pas jusqu’où peut aller la réponse, il s’arrête à 512 tokens ; température 0 par défaut ; un seul modèle chargé à la fois (demandez-en un autre et il le remplace). Il accepte les appels de n’importe quelle page web (CORS ouvert) et rappelle à chaque démarrage qu’il n’est pas fait pour la production.
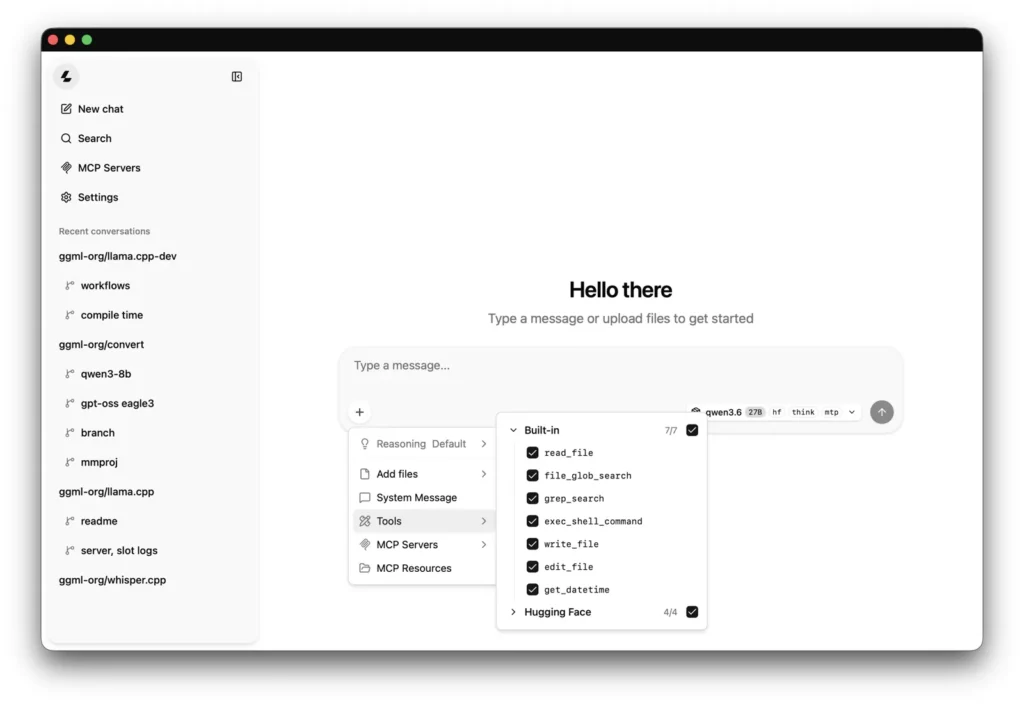
- llama-server écoute sur le port 9931 depuis la v0.7.0 (8080 avant). Par défaut, il ne limite pas la réponse, prend le contexte avec lequel le modèle a été entraîné et le réduit si la mémoire manque (jamais sous 4 096 tokens), et ouvre 4 emplacements pour 4 requêtes simultanées. Il sert aussi sa propre page de discussion à la même adresse et, par défaut, renvoie l’origine de n’importe quelle page web, avec un avertissement dans la console si vous n’avez pas défini de clé.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
La vidéo explicative d’IBM Technology, en anglais et elle aussi regardée via ses sous-titres, présente posément ce qu’est llama.cpp : GGUF, quantification, Metal, CUDA et llama-server. Quand elle lance le serveur, elle fixe elle-même le port 8080, donc sa commande fonctionne telle quelle ; sans cette option, vous tomberiez sur le 9931.
Mémoire et Metal sur Apple Silicon
Sur un Mac Apple Silicon, les deux passent par Metal pour utiliser la puce graphique, chacun avec son code, et les deux suivent la même règle : le processeur et la puce graphique partagent une seule mémoire, donc le modèle, son contexte et vos autres applications puisent dans la même réserve. mlx-lm demande à macOS quelle part devrait revenir à la puce graphique et fixe cette limite au chargement. Les deux savent réduire le cache de la conversation : mlx-lm avec --kv-bits, llama.cpp avec ses options de type de cache (16 bits par défaut).
Sur un Mac Intel, l’histoire est courte. La compilation officielle de llama.cpp pour macOS sur Intel est livrée sans Metal, elle tourne donc sur le processeur, et mlx-lm exige un Python natif ARM. Si votre Mac a une puce Intel, c’est llama.cpp qui fonctionne encore.
Ce que chacun envoie de lui-même
C’est la partie qui nous tient le plus à cœur sur ce site, et les deux se tiennent bien. llama.cpp n’a ni télémétrie ni vérification de mises à jour ; nous avons compté ses connexions le 25 août et relu le code de la v0.8.0 le 30 octobre : les 2 nouvelles sorties qu’elle apporte (un tunnel pair-à-pair, --connect, et un interrupteur « Discover Models » dans la page de discussion) sont toutes deux désactivées par défaut. Il ne se connecte que si vous le lui demandez : pour télécharger un modèle (avec -hf et options voisines au lancement, ou via une requête à /models si vous lancez llama-server sans modèle) ou récupérer une image, un audio ou une vidéo qu’une requête lui passe par son adresse web.
mlx-lm n’envoie rien de lui-même non plus (revérifié sur la 0.32.2 le 17 octobre). Il ne sort que sur demande : pour télécharger des modèles, via la bibliothèque de Hugging Face, qui vérifie aussi si le modèle a changé quand vous le chargez par son nom (HF_HUB_OFFLINE=1 coupe cela dès que vos modèles sont sur le disque) ; pour récupérer une image qu’une requête de discussion lui passe par son adresse web ; et pour télécharger des données de calibrage si vous quantifiez avec AWQ, GPTQ, DWQ ou la quantification dynamique. Chaque connexion de mlx-lm, avec sa source, figure sur sa fiche MLX, et celle de llama.cpp indique comment l’installer et ses versions.
Lequel nous utiliserions, et ce que nous ne savons pas
- Vous voulez le plus large choix de modèles : llama.cpp. Sa version stable couvre les 6 modèles de notre catalogue qui manquent encore à mlx-lm ; le sixième, Mistral Large 4, depuis la v0.9.0 (4 novembre 2026), et, avec 591,21 Gio en Q4_K_M, il ne tient sur aucune de nos machines.
- Vous vivez dans Python ou voulez affiner : mlx-lm.
mlx_lm.loraentraîne des adaptateurs même sur des modèles en 4 bits, et le README d’entraînement de llama.cpp qualifie lui-même son affinage de « very much WIP », très en chantier. - Votre Mac a une puce Intel : llama.cpp, sur le processeur.
- Votre application a besoin de plusieurs requêtes à la fois : llama-server démarre avec 4 emplacements ; mlx_lm.server regroupe ce qu’il peut, avec un modèle chargé.
Ce que nous ne savons pas : lequel est le plus rapide sur votre Mac avec votre modèle. Nous ne l’avons pas mesuré, et cela change avec la puce, le modèle et la version. La vérification est rapide : mlx_lm.generate affiche les tokens par seconde de la lecture et de la réponse, et les deux fournissent un banc d’essai : mlx_lm.benchmark et llama-bench. Même modèle, même taille, même prompt, et vous avez votre propre chiffre.
Si vous hésitez entre l’un des deux et Ollama, nos comparatifs llama.cpp vs Ollama et MLX vs Ollama reprennent là où celui-ci s’arrête, et le trouveur de modèle vous dit lesquels des 28 tiennent dans la mémoire de votre Mac.