Startseite›Modelle›phi-4
phi-4
Architektur dicht40 SchichtenLizenz mitMaximaler Kontext 16kVokabular 100.352
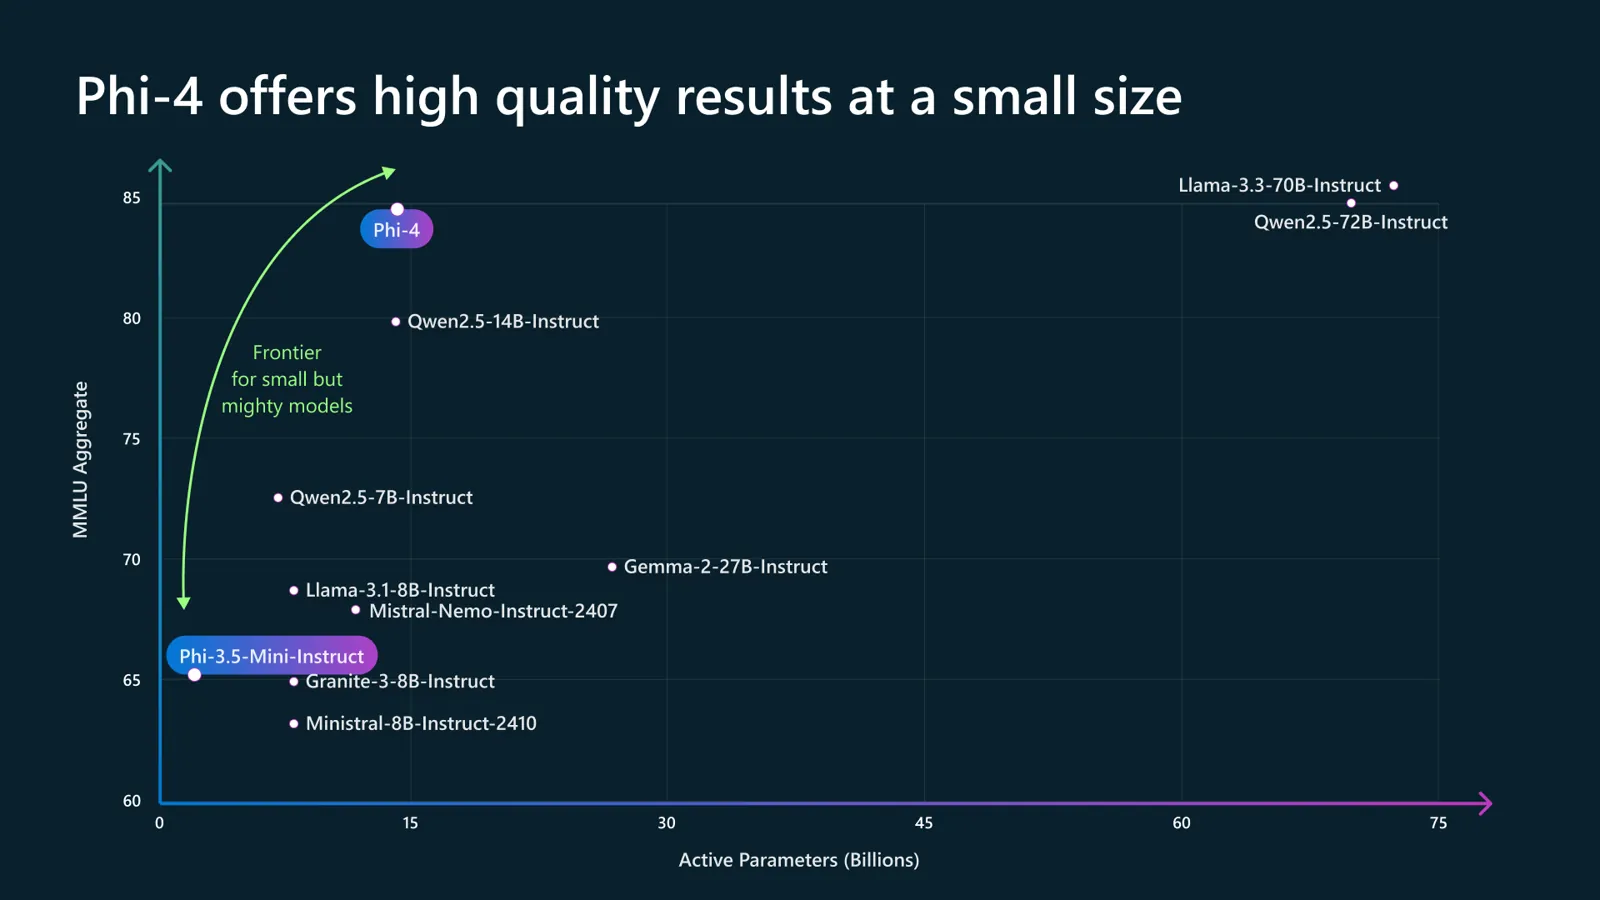
Bei Q4_K_M ist das eine Datei von 8,43 GiB, und sie passt auf 17 der 18 Rechner, die wir durchrechnen (die mit dem wenigsten Speicher: PC mit RTX 3060 12 GB · PC mit RTX 4070 12 GB). Hier füllt die Datei den Speicher: Selbst beim maximalen Kontext von 16k Tokens kommen 3,12 GiB hinzu — und derselbe Inhalt braucht auf Deutsch 1,63-mal so viele Tokens wie auf Englisch.
Modellgröße bei Q4_K_M
Von Local AI Scope gemessen
Kontextspeicher bei 8k Tokens
Von Local AI Scope gemessen
Was Deutsch gegenüber Englisch kostet
Von Local AI Scope gemessen
Videos: phi-4 1
Die besten Vorführungen, die wir gefunden haben. Drücken Sie auf Play, und es läuft direkt hier.
Die Videos liegen bei YouTube, und von dort wird nichts geladen, bevor Sie auf Play drücken (Modus ohne Cookies). Das Vorschaubild kommt von uns.
Größen der veröffentlichten Dateien
Das sind die Größen der tatsächlich vom Autor veröffentlichten Dateien, addiert, wenn das Modell in Teilen ausgeliefert wird. Keine Schätzung aus der Parameterzahl.
| Kompression | Modellgröße |
|---|---|
Q8_0 |
14,51 GiB |
Q6_K |
11,20 GiB |
Q5_K_M |
9,88 GiB |
Q5_K_S |
9,45 GiB |
Q4_K_M |
8,43 GiB |
Q4_K_S |
7,86 GiB |
IQ4_XS |
7,40 GiB |
Q3_K_M |
6,86 GiB |
Kontextspeicher
Berechnet aus dem Aufmerksamkeitsmuster, das dieses Modell Schicht für Schicht angibt, nicht aus der generischen Formel. Deshalb liegt der Wert oft deutlich unter dem anderer Rechner. Die config.json dieses Modells nennt nicht die Größe jedes Aufmerksamkeitskopfes, und aus dieser Zahl besteht der Kontextspeicher. Wir leiten sie aus zwei Angaben ab, die sehr wohl dort stehen: 5.120 verborgene Einheiten geteilt durch 40 Aufmerksamkeitsköpfe, was die Größe eines Kopfes gerade bedeutet und was die Referenzbibliothek voreinstellt: 128. Alle Zahlen dieses Abschnitts ruhen auf dieser Ableitung, deshalb wird sie hier gekennzeichnet und nicht stillschweigend übergangen.
- 8k Tokens → 1,56 GiB
Was es in jeder Sprache kostet
Gemessen, indem der Tokenizer dieses Modells über denselben Inhalt in vier Sprachen läuft. Tokens sind das, was man im Kontext, im Speicher und auf der Cloud-Rechnung zahlt.
| Textsorte | EN | ES | FR | DE |
|---|---|---|---|---|
| Code | — | ×1,28 | ×1,48 | ×1,68 |
| Verträge | — | ×1,40 | ×1,46 | ×1,77 |
| Geschäftliche E-Mails | — | ×1,27 | ×1,38 | ×1,48 |
| Support-Tickets | — | ×1,39 | ×1,59 | ×1,55 |
Englisch ist die Referenz: Jede Zahl gibt an, um wie viel mehr Tokens derselbe Inhalt in dieser Sprache kostet. Durchschnitt über das gesamte Korpus: DE ×1,63.
Wo es passt
Passt heißt: Modell, Kontextspeicher und Arbeitsreserve passen beim angegebenen Kontext gemeinsam hinein und lassen dem System seinen Anteil. 17 von den 18 getesteten Rechnern (Q4_K_M, 8k Tokens).
Bevor Sie auf Download klicken: Zuerst die gute Nachricht: Stand 29. Oktober 2026 öffnen alle fünf Programme, die wir verfolgen, Phi-4, denn seine Architektur (phi3) wird seit Langem unterstützt. llama.cpp führt es in seiner jüngsten stabilen Version v0.8.0 (vom 28. Oktober 2026) und in jedem aktuellen täglichen Build aus. ollama run phi4 (ohne Bindestrich) lädt ein GGUF in Q4_K_M mit 8,43 GiB, genauso groß wie das in der Tabelle, auch auf dem Mac: Eine MLX-Version gibt es in der Liste nicht. Ollama bietet außerdem phi4:14b-q8_0 (14,51 GiB). LM Studio bietet es mit dem GGUF aus seinem Community-Programm (lmstudio-community) an, ebenfalls 8,43 GiB in Q4_K_M. mlx-lm öffnet es in Version 0.32.2 (die 4-Bit-MLX-Version von mlx-community ist 7,68 GiB groß), vLLM in seiner stabilen Version 0.32.0. Zwei Dinge sollten Sie wissen. Der Kontext endet bei 16k Tokens: So steht es in seiner config.json, und keine Zeile der Tabelle geht darüber hinaus, egal wie viel Speicher Sie haben (auf den 12-GB-Karten ist wegen des Speichers schon bei 8k Schluss). Und die Sprache: Microsoft hat es vor allem auf Englisch trainiert (etwa 8 % mehrsprachige Daten) und schreibt, dass es nicht für den Einsatz in anderen Sprachen gedacht ist. Wir messen, was jede Sprache in Tokens kostet, nicht wie gut es antwortet.