Wir verstehen das. Sie haben Xiaomis AI Cube gesehen, eine kleine Box mit 80 GB Speicher, gebaut, um große Sprachmodelle zu Hause laufen zu lassen, und sind sofort bei der naheliegenden Frage gelandet: Was kostet er, und wo ist der Kaufen-Knopf? Wir haben uns genau dasselbe gefragt, mit demselben leicht zu schnellen Puls. Die Antwort ist kurz und ein bisschen ernüchternd: Es gibt keinen Preis, und es gibt keinen Knopf. Also haben wir stattdessen das Nützliche getan. Wir haben den Cube und die 4 Rechner mit 64 bis 192 GB Unified Memory genommen, für die es schon einen Herstellerpreis gibt, und alle fünf durch dieselbe Rechnung geschickt, die wir für jeden Rechner auf dieser Website verwenden, mit denselben 26 Modellen.
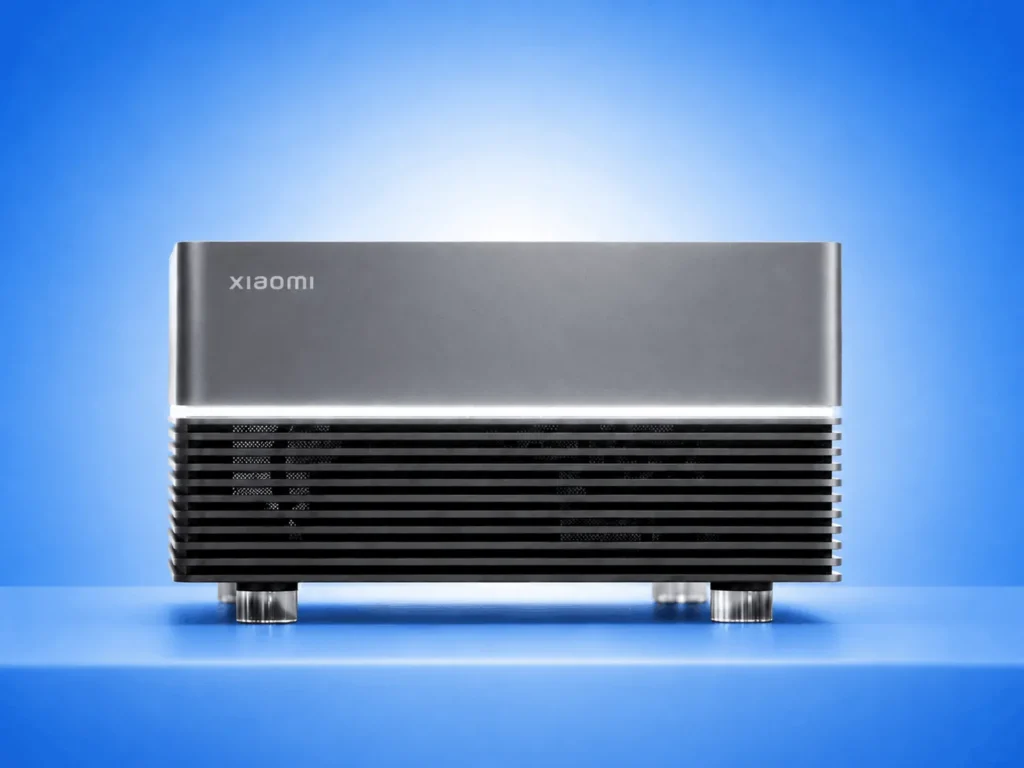
 Xiaomi AI Cube, 80 GB — TechnikprototypPrototyp · Hardware-Datenblatt
Die gute Nachricht: Das, was der Cube verspricht – eine kleine Box, die ein Modell fasst, das für eine Gaming-Grafikkarte zu groß ist –, hat längst einen Preis, und zwar in 4 Varianten, von 2.899 $ bis 6.799 $. Welche sich lohnt, hängt davon ab, welche Modelle Sie laufen lassen wollen, wie viel Text Sie ihnen zu lesen geben und wie lange Sie bereit sind, auf die Antwort zu warten. Gehen wir sie der Reihe nach durch.
Die fünf Rechner im direkten Vergleich
Ob ein Modell läuft, entscheidet nicht der Speicher auf dem Karton, sondern der Speicher, der für das Modell übrig bleibt, nachdem sich das System seinen Anteil genommen hat. Bei Apple ist das die Gesamtmenge minus die 3 GiB, die wir für das Betriebssystem reservieren. Bei Rechnern mit AMD Ryzen AI Max kommt eine zweite Grenze hinzu, und die übersieht man leicht: AMD begrenzt, wie viel dieses Speichers die Grafikeinheit nutzen darf.
| Rechner | Speicher | Frei für das Modell | Speicherbandbreite | Herstellerpreis (USA) | Modelle, die bei 32k passen | Kontextgrenze für gpt-oss-120b |
|---|---|---|---|---|---|---|
| Mac mini, M5 Pro, 64 GB | 64 GB | 61,00 GiB | 307 GB/s (Apple) | 2.899 $ | 20 von 26 | 32k Tokens |
| Xiaomi AI Cube, 80 GB | 80 GB | 77,00 GiB | 341 GB/s (unsere Schätzung) | keiner: Prototyp | 22 von 26 | 128k Tokens |
| PC, Ryzen AI Max+ 395, 128 GB | 128 GB | 96,00 GiB | 256 GB/s (abgeleitet) | 3.449 $ | 23 von 26 | 128k Tokens |
| Mac Studio, M5 Max, 128 GB | 128 GB | 125,00 GiB | 614 GB/s (Apple) | 5.099 $ | 23 von 26 | 128k Tokens |
| PC, Ryzen AI Max+ PRO 495, 192 GB | 192 GB | 160,00 GiB | 273 GB/s (abgeleitet) | 6.799 $ | 24 von 26 | 128k Tokens |
Gezählt werden die Modelle in der Referenzkompression (Q4_K_M oder die nächstliegende, die der Autor veröffentlicht), und 128k ist das Maximum, das gpt-oss-120b selbst annimmt; auf 4 der 5 Rechner setzt also das Modell die Grenze, nicht die Box. Drei Dinge springen sofort ins Auge, und um sie geht es im Rest dieses Artikels. Der Mac mit 64 GB fasst bereits gpt-oss-120b. Die beiden Rechner mit 128 GB nehmen trotz 29 GiB Unterschied exakt dieselben Modelle. Und der Cube, den man nicht kaufen kann, landet in der Mitte der Tabelle, nicht an der Spitze.
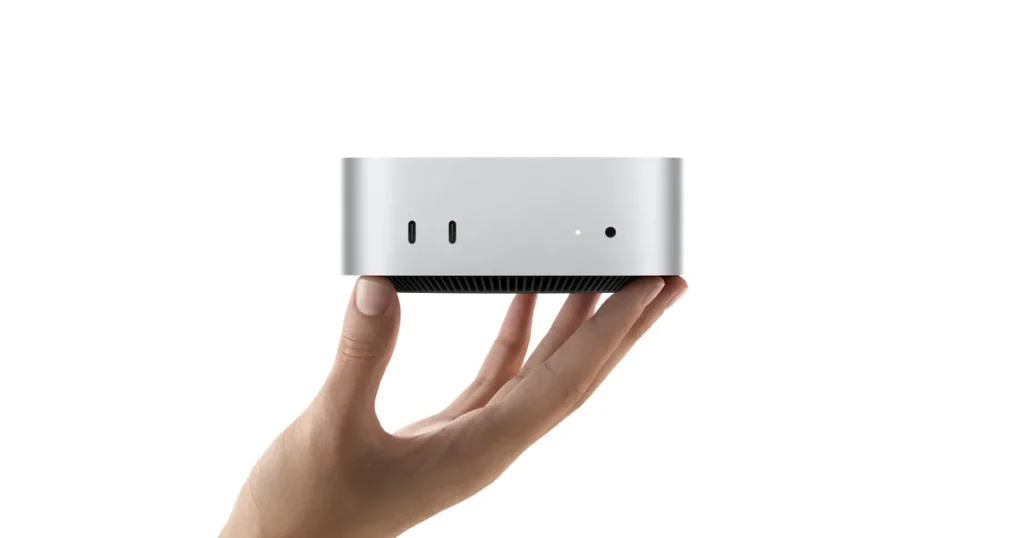
Mac mini mit M5 Pro, 64 GB: die günstigste Eintrittskarte zu einem 120B
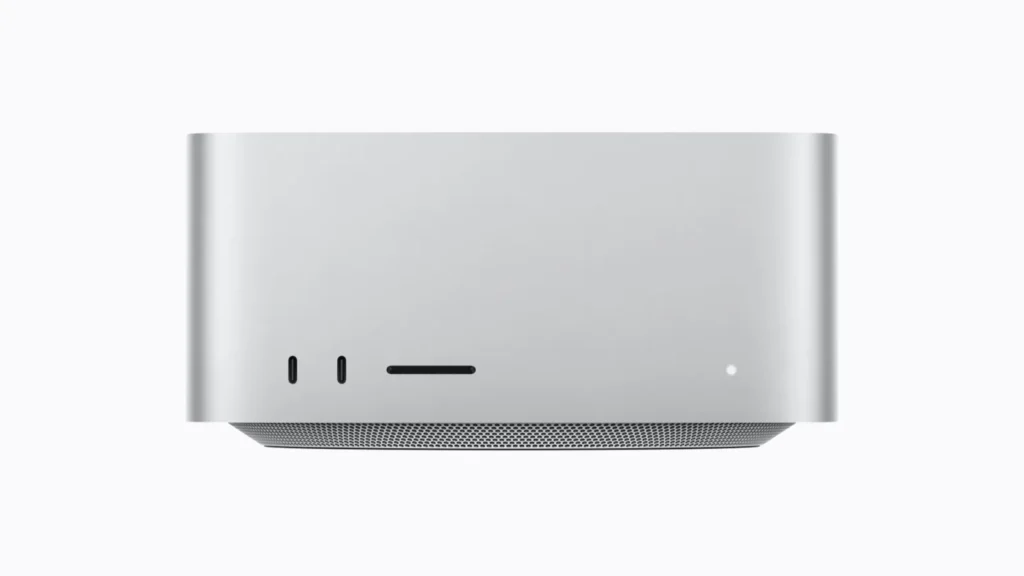
 Mac mini mit M5 Pro und 64 GB Unified MemoryHardware-Datenblatt
Er ist der kleinste käufliche Rechner in diesem Vergleich, der gpt-oss-120b ausführt, und allein das macht ihn interessant. Apple verlangt in seinem US-Store 2.899 $ für die Konfiguration mit 64 GB und 512 GB Speicherplatz (Preis abgelesen am 1. Oktober 2026). Das sind 1.200 $ mehr als die 1.699 $, ab denen der Mac mini mit M5 Pro startet, denn das Einstiegsmodell hat 24 GB, und mit 24 GB kommen Sie an diese Liste nicht einmal in die Nähe.
Mit 61,00 GiB für das Modell nimmt er 20 unserer 26 Modelle bei 32k Kontext. Die 6, die draußen bleiben, sind die 6 schwersten Dateien im Katalog: llama4-scout-17b (allein 60,87 GiB Gewichte, es scheitert also um Haaresbreite, sobald der Cache und der Arbeitsspeicher der Laufzeitumgebung dazukommen), nemotron-3.5-super-120b (65,29 GiB: hier sind schon die Gewichte allein zu viel), qwen3.8-flash-next, deepseek-v4-flash, glm-5.3-flash und glm-5.2.
Der Haken ist die Obergrenze. gpt-oss-120b ist eine Datei mit 58,46 GiB, und in 61,00 GiB passt sie bei 32k Kontext und keinen Schritt weiter. Stellen Sie sich einen Koffer vor, der nur zugeht, wenn Sie sich draufsetzen: Er geht zu, aber für Souvenirs ist kein Platz mehr. Zum Chatten und für die meisten Dokumente reichen 32k völlig. Wer dem Modell eine ganze Codebasis zu lesen geben will, kommt damit nicht aus.
Ryzen AI Max+ 395, 128 GB: warum 128 in Wahrheit 96 sind
 PC mit Ryzen AI Max+ 395 und 128 GB Unified MemoryHardware-Datenblatt
Hier kommt die Zahl, die uns am meisten überrascht hat. Ein PC mit AMDs Ryzen AI Max+ 395 und 128 GB Unified Memory gibt dem Modell nicht 125 GiB, wie es ein Mac mit gleich viel Speicher täte. AMD selbst schreibt, diese Generation „topped out at 128GB of total memory with up to 96GB reserved for GPU workloads“: Schluss war bei 128 GB Gesamtspeicher, von denen bis zu 96 GB für die GPU reserviert sind. Deshalb rechnet unsere Engine mit 96,00 GiB, und aus dieser Zahl ergibt sich jedes Urteil auf seinem Datenblatt.
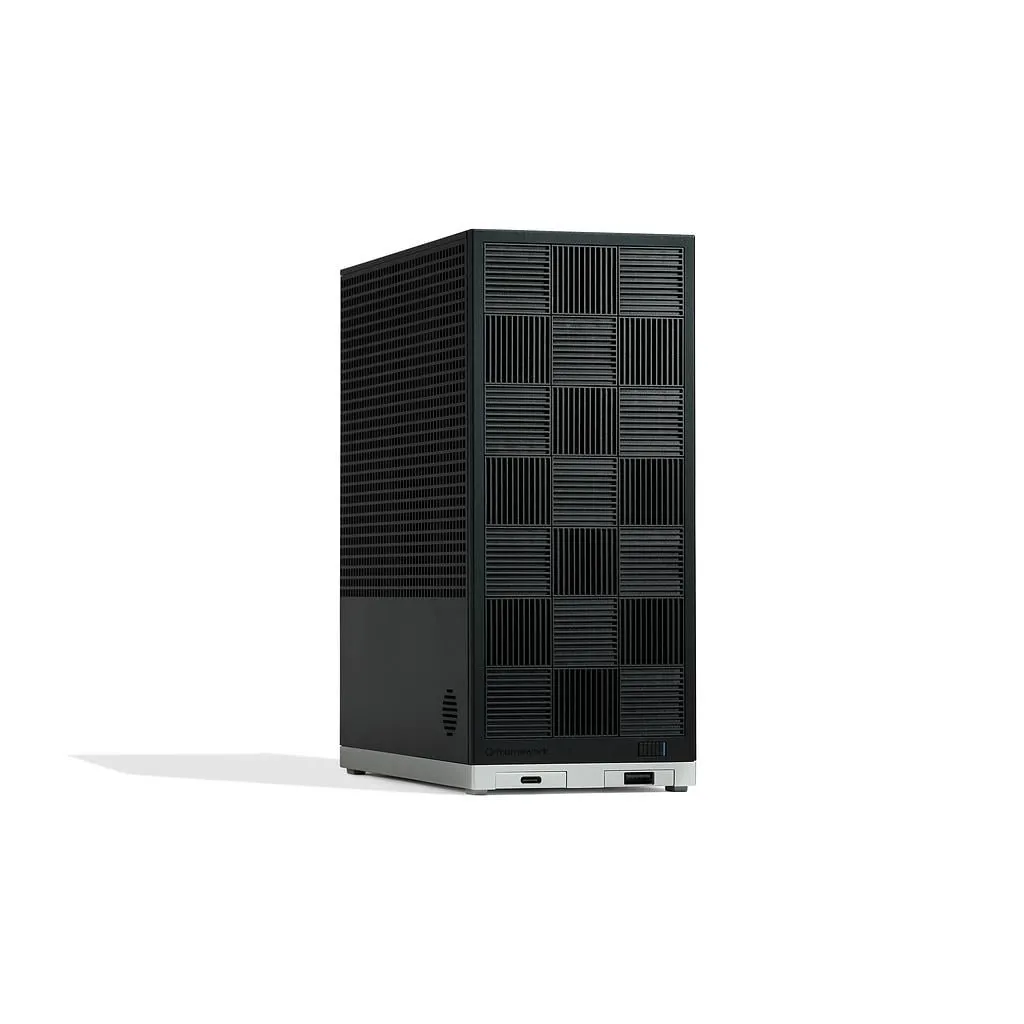
Und trotzdem: 96 GiB sind eine Menge. Er nimmt 23 der 26 Modelle bei 32k und 21 bei 128k. Er fasst gpt-oss-120b bei 128k, also bei dessen vollem angegebenem Maximum, dazu llama4-scout-17b bis 256k, das 87,25 GiB große qwen3.8-flash-next bis 128k und nemotron-3.5-super-120b bis zu dessen eigenem angegebenem Maximum. Die 3, die er nicht schafft, sind deepseek-v4-flash (127,28 GiB), glm-5.3-flash (187,04 GiB) und glm-5.2 (433,83 GiB).
Beim Preis führt Framework seinen Desktop mit dem Max+ 395 und 128 GB für 3.449 $ vor Steuern, und die Seite zeigte diese Konfiguration als ausverkauft an, als wir am 30. September 2026 nachgesehen haben. Im Mai 2026 nannte AMD 3.999 $ als Verkaufspreis seines eigenen 395-Rechners mit 128 GB, des Ryzen AI Halo. So oder so ist er in diesem Vergleich der günstigste Weg zum 87-GiB-Modell.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Mac Studio mit M5 Max, 128 GB: dieselbe Liste, doppeltes Tempo
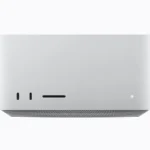 Mac Studio mit M5 Max und 128 GB Unified MemoryHardware-Datenblatt
Dieselben 128 GB auf dem Karton, und diesmal 125,00 GiB für das Modell, weil Apple keine eigene GPU-Grenze veröffentlicht; macOS hält eine Standardgrenze, die sich mit einer Einstellung anheben lässt (iogpu.wired_limit_mb), und unsere Zahl setzt voraus, dass Sie sie anheben. Man würde erwarten, dass diese 29 GiB mehr auch mehr Modelle bringen. Tun sie nicht.
Davonziehen kann der Mac Studio beim Tempo. Apple gibt für diesen Chip 614 GB/s Speicherbandbreite an, gegenüber 256 GB/s beim 395, und wenn ein Modell seine Antwort schreibt, muss es für jedes Token die Gewichte, die es nutzt, erneut lesen. Unsere Engine schätzt für gpt-oss-120b etwa 36 Tokens pro Sekunde auf dem Mac Studio und etwa 14 auf dem 395. Für qwen3.6-35b-a3b sind es etwa 102 gegenüber etwa 39. Diese Geschwindigkeiten sind Schätzungen nach einer öffentlichen Formel, keine Messungen, und sie entscheiden nie darüber, ob ein Modell passt; aber einen 2,4-fachen Unterschied in der Bandbreite denkt sich keine Schätzung aus.
Die Rechnung: 5.099 $ in Apples US-Store für den M5 Max mit 128 GB und 512 GB Speicherplatz (abgelesen am 1. Oktober 2026). Das sind 1.650 $ mehr als das Framework-Angebot für dieselbe Modellliste. Sie bezahlen für Antworten, die nach unserer Schätzung mehr als doppelt so schnell kommen, und dafür, dass sich qwen3.8-flash-next und llama4-scout-17b doppelt so weit strecken dürfen.
Ryzen AI Max+ PRO 495, 192 GB: der einzige, der deepseek-v4-flash lädt
 PC mit Ryzen AI Max+ PRO 495 und 192 GB Unified MemoryHardware-Datenblatt
Er ist der letzte der fünf, der bei Käufern ankommt, und der größte. AMDs Ryzen AI Max+ PRO 495 nimmt bis zu 192 GB auf, davon in AMDs Worten „up to 160GB dedicated to the GPU“, also bis zu 160 GB allein für die GPU. Unsere Engine rechnet mit 160,00 GiB für das Modell: 29 weniger, als ein Mac mit 192 GB übrig ließe, und trotzdem 35 mehr als der Mac Studio oben.
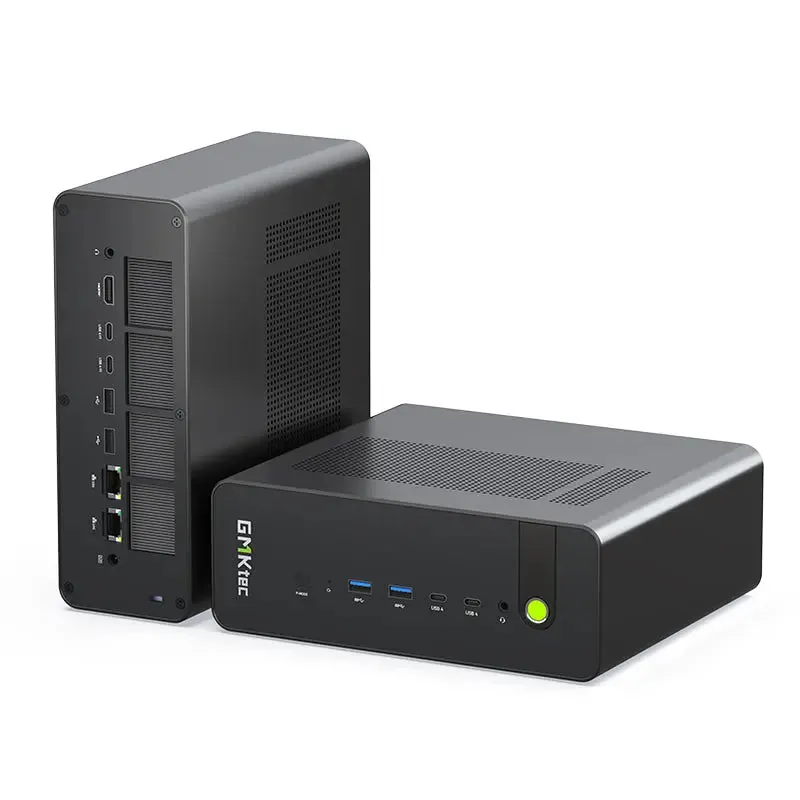
Diese 160 GiB erlauben ihm das Einzige, was kein anderer Rechner in diesem Vergleich schafft: deepseek-v4-flash zu fassen, eine Datei mit 127,28 GiB in ihrer Referenzkompression, und zwar bis 256k Kontext. Er nimmt 24 der 26 Modelle bei 32k und 22 bei 128k. Draußen bleiben glm-5.3-flash, dessen 187,04 GiB selbst diese 160 sprengen, und glm-5.2, das mit 433,83 GiB nach keiner Rechnung der Welt ein Modell für den Rechner zu Hause ist.
GMKtec verkauft seinen EVO-X5 Pro mit diesem Chip, 192 GB und 2 TB Speicherplatz für 6.799 $ im eigenen Shop (bis Anfang Oktober waren es 6.599 $; erneut geprüft am 9. Oktober 2026), und am 30. September wurde er bereits ausgeliefert. Damit ist er die teuerste Box hier und die einzige, die man aus einem einzigen Grund kauft: ein Modell, das nicht in die 125 GiB des Mac Studio passt, wohl aber in 160, und das ist in unserem Katalog heute deepseek-v4-flash.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken. Mehr Videos im Datenblatt →
Und der AI Cube? Genau in der Mitte
Jetzt legen wir den Cube wieder auf den Tisch. Mit 80 GB und 77,00 GiB für das Modell nimmt er 22 der 26 Modelle bei 32k: 2 mehr als der Mac mini mit 64 GB und 1 oder 2 weniger als alle anderen hier. Gegenüber dem Mac mini kommen llama4-scout-17b (bis 128k) und nemotron-3.5-super-120b hinzu (bis 256k; mit 65,29 GiB die größte Datei, die der Cube fasst), und gpt-oss-120b bekommt deutlich mehr Platz: von 32k auf 128k. Gegenüber dem PC mit 395 und dem Mac Studio liegt er schlicht zurück: kein qwen3.8-flash-next, weniger Reichweite für llama4-scout-17b (128k gegen 256k und 512k) und dieselbe Obergrenze von 128k bei gpt-oss-120b.
Ein ehrlicher Vorbehalt. Das Tempo des Cube ist die eine Zahl auf dieser Seite, die wir überhaupt nicht festnageln können: Xiaomi hat die Bandbreite seiner 80 GB nicht veröffentlicht, die 341 GB/s auf seinem Datenblatt sind also unsere eigene Schätzung und als solche gekennzeichnet. Die 1,22 TB/s, die mit dem Cube in Verbindung gebracht werden, gehören zu dem Speicher, der auf einem seiner Chips gestapelt ist, nicht zu den 80 GB, in denen ein Modell tatsächlich liegt; das haben wir in unserem Vergleich Mac mini M6 vs. AI Cube (auf Englisch) auseinandergenommen. Der Speicher dagegen entscheidet, was passt, und 80 GB ist die Zahl, von der jedes Urteil oben ausgeht.
Was wir nicht überprüfen konnten
- AMD veröffentlicht keine Bandbreite in GB/s. Die 256 und 273 GB/s ergeben sich aus Speichertyp und Speichertakt, die AMD sehr wohl veröffentlicht (ein 256-Bit-Bus mit 8.000 und 8.533 MT/s). Das ist Rechnung, keine Messung, und die Datenblätter sagen das auch so.
- Die GPU-Grenzen bei AMD sind die Zahlen, die AMD veröffentlicht. Unter Linux lässt sich die Grenze verstellen, und AMD nennt dafür kein Maximum; wir verwenden die 96 und 160 GB, die AMD angibt, ein optimierter Rechner könnte also mehr hergeben, um einen Betrag, den AMD nicht beziffert.
- Auf dem Mac setzt der Speicher für das Modell eine Einstellung voraus. macOS hält eine Standardgrenze dafür, wie viel Speicher die GPU fest belegen darf, und
iogpu.wired_limit_mbhebt sie an; die 61,00 und 125,00 GiB oben setzen voraus, dass Sie sie anheben, was vor allem fürgpt-oss-120bauf dem Mac mini mit 64 GB ins Gewicht fällt. - Jede Geschwindigkeit auf dieser Seite ist eine Schätzung. Ob ein Modell passt, wird aus den echten Dateigrößen und dem Cache berechnet, den die Architektur des jeweiligen Modells braucht; die Tokens pro Sekunde stammen aus einer Bandbreitenformel, beim Cube sogar aus einer Bandbreite, die selbst eine Annahme ist.
- Die Preise sind die US-Preise, die der jeweilige Hersteller veröffentlicht, in Dollar, zu den genannten Daten. Für keinen der AMD-Rechner ist ein Euro-Preis veröffentlicht.
Welchen sollten Sie also kaufen?
Steht keines der 6 großen Modelle auf Ihrer Liste, nehmen alle 5 Rechner dieselben 20 bei 32k, von qwen3-1.7b bis gpt-oss-120b. Dann geht es um Tempo, um den Preis und darum, ob Ihnen macOS oder ein PC lieber ist. Spaß haben Sie so oder so reichlich.
Welches der 26 Modelle auf Ihren Rechner passt, bei dem Kontext, den Ihre Arbeit braucht, und in der Sprache, in der Sie arbeiten, beantwortet der Modellfinder, und die vollständige Liste mit 18 Rechnern führt jede Zahl mit ihrer Evidenzkennzeichnung. Steht die Box erst auf Ihrem Schreibtisch, startet unsere Anleitung zur Einrichtung von llama.cpp ein Modell mit 1 Befehl, und auf dem Mac ist die MLX-Anleitung der andere Weg, den man kennen sollte.