Lo entendemos. Viste el AI Cube de Xiaomi, una cajita con 80 GB de memoria pensada para mover modelos de lenguaje grandes en casa, y te fuiste derecho a la pregunta obvia: cuánto cuesta y dónde está el botón de «comprar». Nosotros nos preguntamos lo mismo, con el pulso igual de acelerado. La respuesta es corta y algo decepcionante: no hay precio y no hay botón. Así que hicimos lo útil. Cogimos el Cube y los 4 equipos con 64 a 192 GB de memoria unificada que ya tienen precio del fabricante, y pasamos los cinco por la misma aritmética que aplicamos a cada equipo de esta web, frente a los mismos 26 modelos.
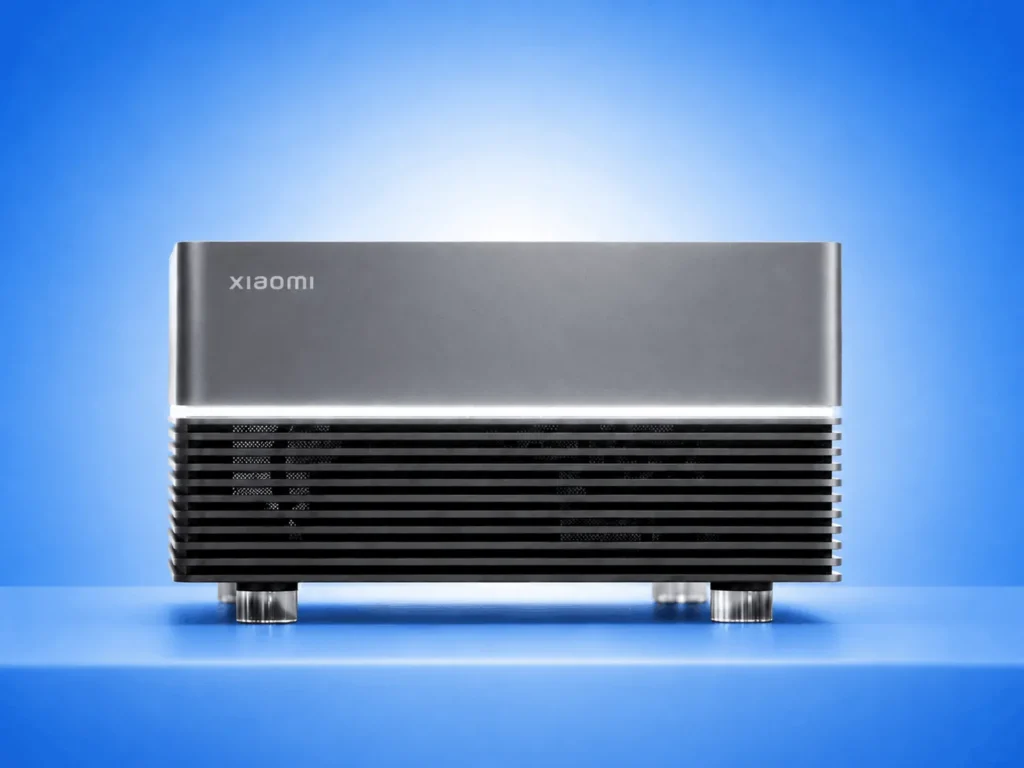
 Xiaomi AI Cube, 80 GB — prototipo de ingenieríaPrototipo · Ficha del equipo
La buena noticia es que lo que promete el Cube (una sola caja pequeña capaz de alojar un modelo que no cabe en una tarjeta gráfica de gaming) ya tiene precio, en 4 versiones, de 2.899 $ a 6.799 $. Cuál compensa depende de los modelos que quieras mover, de cuánto texto les des de comer y de cuánto estés dispuesto a esperar la respuesta. Vamos uno por uno.
Los cinco equipos, uno al lado del otro
La cifra que decide si un modelo arranca no es la memoria que pone en la caja: es la que le queda al modelo cuando el sistema ya se ha llevado su parte. En los equipos de Apple es el total menos los 3 GiB que reservamos para el sistema operativo. En los equipos con AMD Ryzen AI Max hay un segundo límite, y se pasa por alto con facilidad: AMD pone un tope a la parte de esa memoria que puede usar la gráfica.
| Equipo | Memoria | Libre para el modelo | Ancho de banda de memoria | Precio del fabricante (EE. UU.) | Modelos que caben a 32k | Techo de contexto de gpt-oss-120b |
|---|---|---|---|---|---|---|
| Mac mini, M5 Pro, 64 GB | 64 GB | 61,00 GiB | 307 GB/s (Apple) | 2.899 $ | 20 de 26 | 32k tokens |
| Xiaomi AI Cube, 80 GB | 80 GB | 77,00 GiB | 341 GB/s (supuesto nuestro) | ninguno: prototipo | 22 de 26 | 128k tokens |
| PC, Ryzen AI Max+ 395, 128 GB | 128 GB | 96,00 GiB | 256 GB/s (derivado) | 3.449 $ | 23 de 26 | 128k tokens |
| Mac Studio, M5 Max, 128 GB | 128 GB | 125,00 GiB | 614 GB/s (Apple) | 5.099 $ | 23 de 26 | 128k tokens |
| PC, Ryzen AI Max+ PRO 495, 192 GB | 192 GB | 160,00 GiB | 273 GB/s (derivado) | 6.799 $ | 24 de 26 | 128k tokens |
Los modelos se cuentan con la compresión de referencia (Q4_K_M, o la más cercana que publique su autor), y 128k es lo máximo que admite el propio gpt-oss-120b, así que en 4 de los 5 equipos el límite lo pone el modelo, no la máquina. Saltan a la vista tres cosas, y de ellas va el resto del artículo. El Mac de 64 GB ya carga un 120B. Los dos equipos de 128 GB admiten exactamente los mismos modelos, pese a 29 GiB de diferencia. Y el Cube, el que no se puede comprar, queda en mitad de la tabla, no arriba.
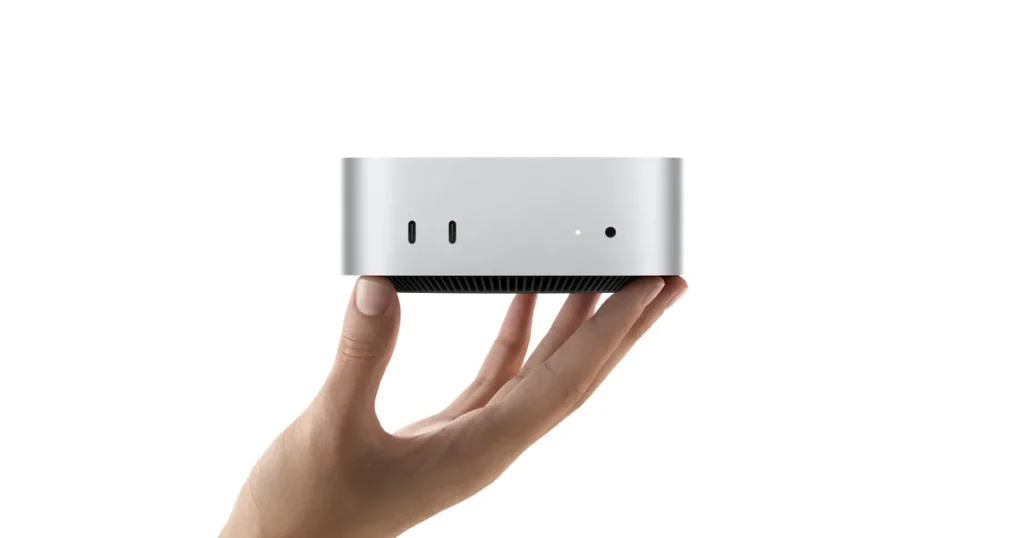
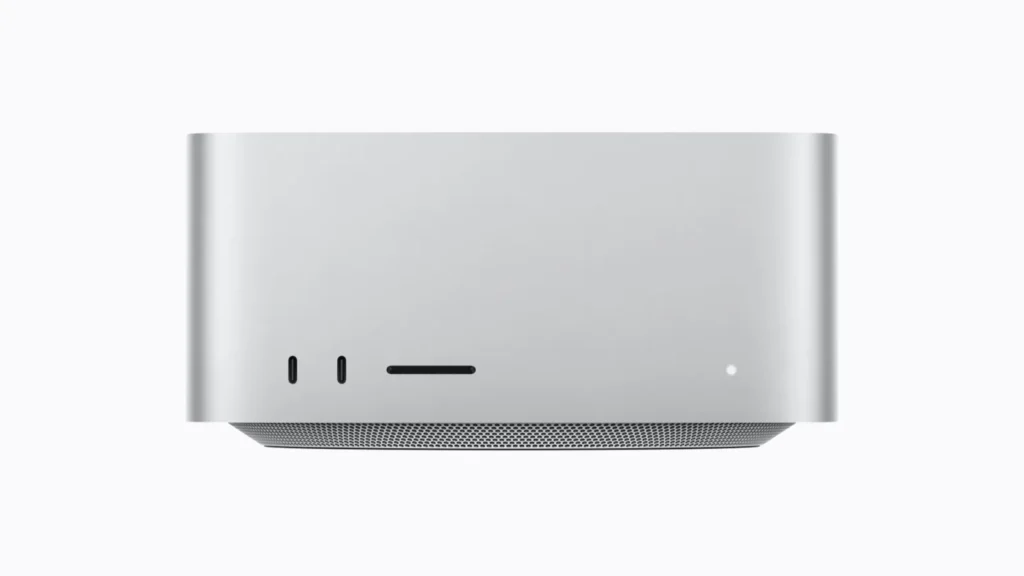
Mac mini con M5 Pro y 64 GB: la entrada más barata a un 120B
 Mac mini con M5 Pro y 64 GB unificadosFicha del equipo
Es el equipo más pequeño a la venta de esta comparativa que mueve gpt-oss-120b, y solo por eso ya merece atención. Apple pide 2.899 $ en su tienda de EE. UU. por la configuración con 64 GB y 512 GB de almacenamiento (precio leído el 1 de octubre de 2026). Son 1.200 $ más que los 1.699 $ con los que arranca el Mac mini con M5 Pro, porque el modelo de partida trae 24 GB, y con 24 GB no te acercas ni de lejos a esta lista.
Con 61,00 GiB libres para el modelo, admite 20 de nuestros 26 modelos a 32k de contexto. Los 6 que se quedan fuera son los 6 archivos más pesados del catálogo: llama4-scout-17b (60,87 GiB solo de pesos, así que se queda fuera por un pelo cuando se suman la caché y la memoria de trabajo del runtime), nemotron-3.5-super-120b (65,29 GiB: aquí ya no entran ni los pesos), qwen3.8-flash-next, deepseek-v4-flash, glm-5.3-flash y glm-5.2.
La pega es el techo. gpt-oss-120b es un archivo de 58,46 GiB, y en 61,00 GiB cabe a 32k de contexto y ni un escalón más. Piensa en una maleta que solo cierras sentándote encima: cierra, sí, pero los recuerdos del viaje se quedan fuera. Para charlar y para la mayoría de documentos, 32k sobran. Para pasarle un repositorio de código entero, se quedan cortos.
Ryzen AI Max+ 395 con 128 GB: por qué 128 son en realidad 96
 PC con Ryzen AI Max+ 395 y 128 GB unificadosFicha del equipo
Aquí está la cifra que más nos sorprendió. Un PC con el Ryzen AI Max+ 395 de AMD y 128 GB de memoria unificada no le deja al modelo 125 GiB, como haría un Mac con la misma memoria. La propia AMD lo resume así para esta generación: «topped out at 128GB of total memory with up to 96GB reserved for GPU workloads», es decir, como mucho 128 GB en total, de los que la GPU puede reservarse hasta 96. Por eso nuestro motor cuenta 96,00 GiB, y de esa cifra sale cada veredicto de su ficha.
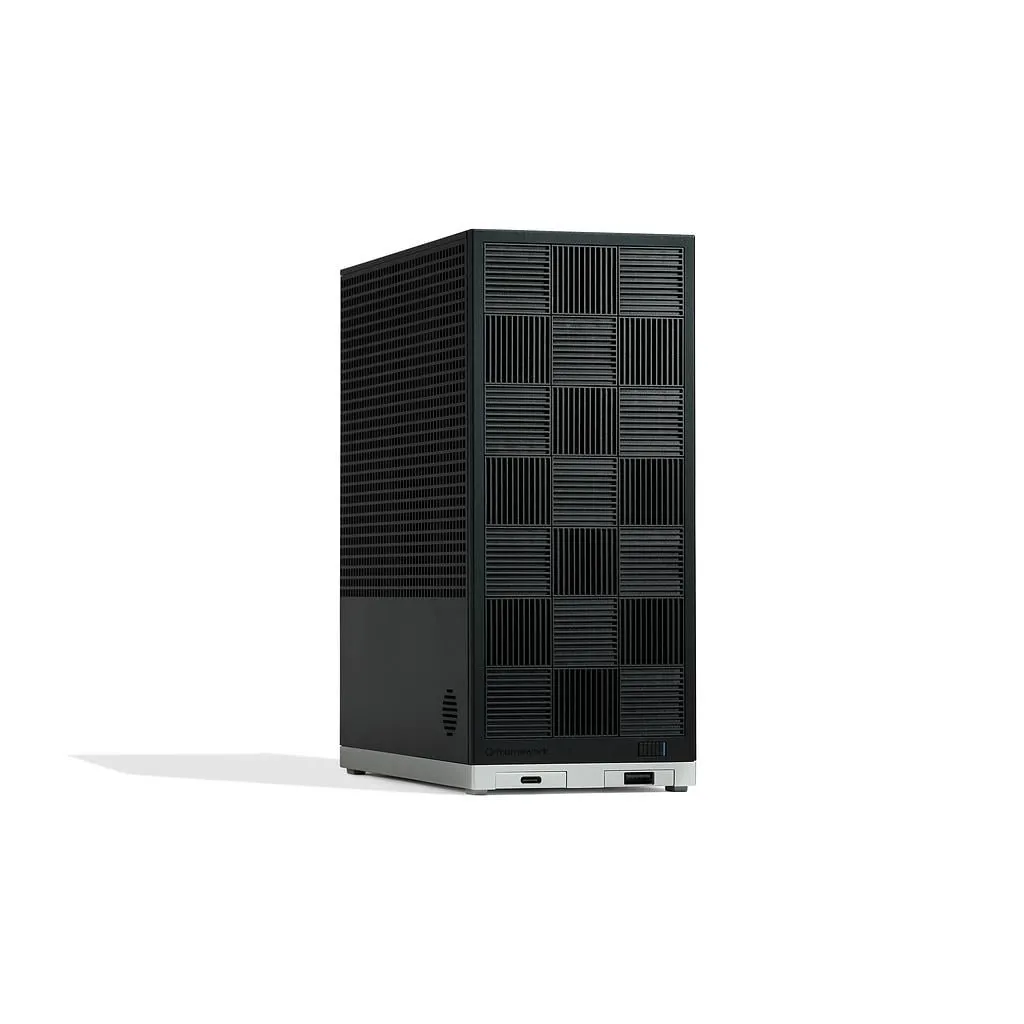
Y aun así, 96 GiB dan para mucho. Admite 23 de los 26 modelos a 32k y 21 a 128k. Carga gpt-oss-120b a 128k, el máximo que declara el modelo, llama4-scout-17b hasta 256k, qwen3.8-flash-next (87,25 GiB) hasta 128k y nemotron-3.5-super-120b hasta el máximo que declara. Los 3 que se le resisten son deepseek-v4-flash (127,28 GiB), glm-5.3-flash (187,04 GiB) y glm-5.2 (433,83 GiB).
En precio, Framework anuncia su Desktop con el Max+ 395 y 128 GB a 3.449 $ sin impuestos, y su página marcaba esa configuración como agotada cuando la miramos el 30 de septiembre de 2026. En mayo de 2026, AMD daba 3.999 $ como precio de venta de su propio equipo con el 395 y 128 GB, el Ryzen AI Halo. Con uno u otro, es la vía más barata de esta comparativa para llegar al modelo de 87 GiB.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
Mac Studio con M5 Max y 128 GB: la misma lista, el doble de rápido
 Mac Studio con M5 Max y 128 GB unificadosFicha del equipo
Los mismos 128 GB en la caja, y esta vez 125,00 GiB para el modelo, porque Apple no publica un tope aparte para la GPU; macOS mantiene un límite por defecto que se sube con un ajuste (iogpu.wired_limit_mb), y nuestra cifra da por hecho que lo subes. Lo lógico sería que esos 29 GiB de más te dieran más modelos. Pues no.
Donde el Mac Studio se escapa es en velocidad. Apple declara 614 GB/s de ancho de banda de memoria para este chip, frente a los 256 GB/s del 395, y cuando un modelo escribe su respuesta tiene que volver a leer los pesos que usa por cada token. Nuestro motor estima unos 36 tokens por segundo para gpt-oss-120b en el Mac Studio y unos 14 en el 395. Para qwen3.6-35b-a3b, unos 102 frente a unos 39. Son estimaciones con una fórmula pública, no mediciones, y nunca deciden si un modelo cabe; pero una diferencia de 2,4 veces en ancho de banda no se la inventa ninguna estimación.
La factura: 5.099 $ en la tienda de Apple de EE. UU. por el M5 Max con 128 GB y 512 GB de almacenamiento (leído el 1 de octubre de 2026). Son 1.650 $ más que el precio de Framework para la misma lista de modelos. Lo que pagas son respuestas que llegan más del doble de rápido, según nuestra estimación, y qwen3.8-flash-next y llama4-scout-17b estirándose el doble.
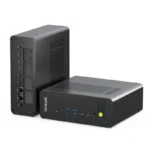
Ryzen AI Max+ PRO 495 con 192 GB: el único que carga deepseek-v4-flash
 PC con Ryzen AI Max+ PRO 495 y 192 GB unificadosFicha del equipo
Es el último de los cinco en llegar a los compradores, y el más grande. El Ryzen AI Max+ PRO 495 de AMD admite hasta 192 GB, y de ellos, en palabras de AMD, «up to 160GB dedicated to the GPU»: hasta 160 GB dedicados a la gráfica. Nuestro motor cuenta 160,00 GiB para el modelo: 29 menos de los que dejaría un Mac de 192 GB, y aun así 35 más que el Mac Studio de arriba.
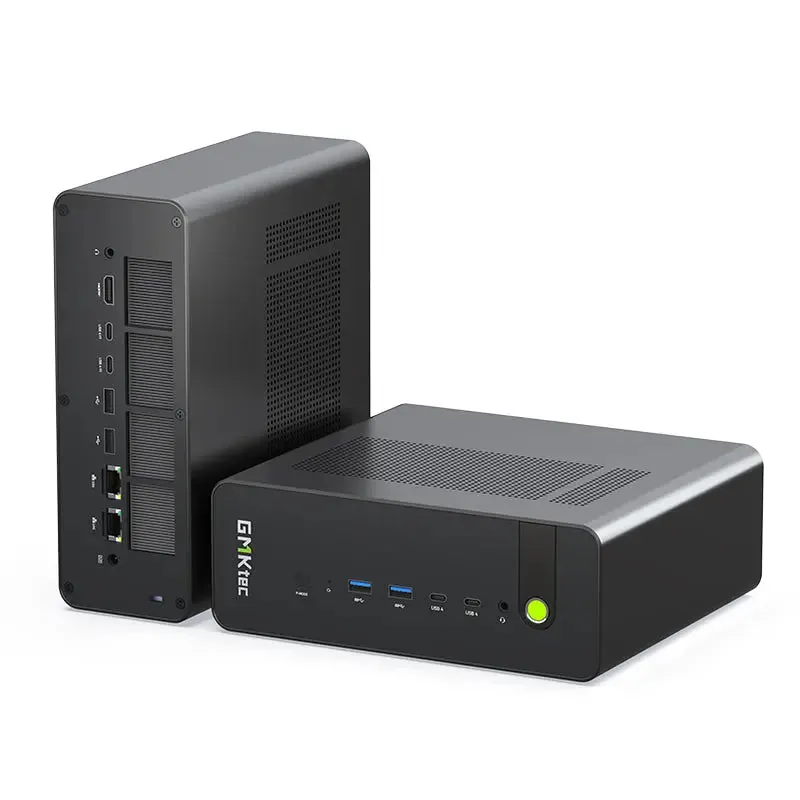
Esos 160 GiB son los que le permiten hacer lo que no hace ningún otro equipo de esta comparativa: cargar deepseek-v4-flash, un archivo de 127,28 GiB con su compresión de referencia, hasta 256k de contexto. Admite 24 de los 26 modelos a 32k y 22 a 128k. Los 2 que se quedan fuera son glm-5.3-flash, cuyos 187,04 GiB desbordan incluso estos 160, y glm-5.2, que con 433,83 GiB no es un modelo para un equipo doméstico, se mire como se mire.
GMKtec vende su EVO-X5 Pro con este chip, 192 GB y 2 TB de almacenamiento por 6.799 $ en su propia tienda (costaba 6.599 $ hasta principios de octubre; lo volvimos a mirar el 9 de octubre de 2026), y el 30 de septiembre ya lo estaba enviando. Eso lo convierte en la caja más cara de la comparativa, y en la única que comprarías por una sola razón: un modelo que no cabe en los 125 GiB del Mac Studio pero sí en 160, que en nuestro catálogo hoy es deepseek-v4-flash.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
¿Y el AI Cube? Justo en medio
Ahora vuelve a poner el Cube sobre la mesa. Con 80 GB y 77,00 GiB para el modelo, admite 22 de los 26 modelos a 32k: 2 más que el Mac mini de 64 GB, y 1 o 2 menos que todos los demás. Frente al Mac mini, lo que añade es llama4-scout-17b (hasta 128k), nemotron-3.5-super-120b (hasta 256k; con 65,29 GiB, el archivo más grande que carga el Cube) y un gpt-oss-120b mucho más holgado, que pasa de 32k a 128k. Frente al PC con el 395 y el Mac Studio, sencillamente va por detrás: sin qwen3.8-flash-next, con menos recorrido para llama4-scout-17b (128k frente a 256k y 512k) y con el mismo techo de 128k para gpt-oss-120b.
Una advertencia, por honestidad. La velocidad del Cube es la única cifra de esta página que no podemos concretar en absoluto: Xiaomi no ha publicado el ancho de banda de sus 80 GB, así que los 341 GB/s de su ficha son un supuesto nuestro, y así figura. Los 1,22 TB/s que acompañan al Cube son de la memoria apilada sobre uno de sus chips, no de los 80 GB donde de verdad vive un modelo; lo desmenuzamos en nuestra comparativa Mac mini M6 frente al AI Cube, en inglés. La memoria, en cambio, es la que decide si un modelo cabe, y 80 GB es la cifra de la que parten todos los veredictos de arriba.
Lo que no hemos podido verificar
- AMD no publica el ancho de banda en GB/s. Los 256 y 273 GB/s salen del tipo y la velocidad de memoria que AMD sí publica (un bus de 256 bits a 8.000 y 8.533 MT/s). Es aritmética, no una medición, y las fichas lo dicen.
- Los topes de GPU de AMD son las cifras que publica AMD. En Linux el límite se puede ajustar, y AMD no publica un máximo para eso; usamos los 96 y 160 GB que sí declara, así que un equipo afinado podría dar más, en una cantidad que AMD no indica.
- En un Mac, la memoria para el modelo da por hecho un ajuste. macOS mantiene un límite por defecto de cuánta memoria puede bloquear la GPU, y
iogpu.wired_limit_mblo sube; los 61,00 y 125,00 GiB de arriba dan por hecho que lo subes, y eso pesa sobre todo engpt-oss-120ben el Mac mini de 64 GB. - Todas las velocidades de esta página son estimaciones. Si un modelo cabe o no se calcula con el tamaño real de sus archivos y la caché que necesita su arquitectura; los tokens por segundo salen de una fórmula de ancho de banda y, en el Cube, de un ancho de banda que ya es de por sí un supuesto.
- Los precios son los que publica cada fabricante para EE. UU., en dólares y en las fechas indicadas. Ninguno de los equipos AMD publica precio en euros.
Entonces, ¿cuál compro?
Si ninguno de los 6 grandes está en tu lista, los 5 equipos admiten los mismos 20 a 32k, de qwen3-1.7b a gpt-oss-120b. Entonces la elección va de velocidad, de precio y de si prefieres macOS o un PC. Diversión hay de sobra con cualquiera.
Qué modelos de los 26 caben en tu equipo, con el contexto que pide tu trabajo y en el idioma en que trabajas, te lo dice el Buscador de modelos, y la lista completa de 18 equipos lleva cada cifra con su etiqueta de evidencia. Cuando tengas la caja en la mesa, nuestra guía de llama.cpp arranca un modelo con 1 comando, y en un Mac la guía de MLX es el otro camino que conviene conocer.