Un modèle tient quand son fichier de poids, sa mémoire de contexte et la marge du programme qui l’exécute entrent ensemble dans ce qui reste une fois que le système a pris sa part. Avec une carte de 8 Go, 7 des 26 modèles mesurés tiennent à 8k de contexte, et il n’en reste que 3 avec un contrat de 12 000 mots en français — les mêmes 3 qu’en anglais, car à cette longueur les deux langues tombent déjà sur le même palier de contexte. En allemand, il n’en reste que 2.
C’est cette seconde ligne que cette page calcule, et le reste explique d’où elle sort.
Combien de mémoire reste-t-il réellement ?
Une machine de 16 Go n’offre pas 16 Go. Le système se sert toujours en premier. Nous réservons 0,8 Gio sur les cartes graphiques dédiées et 3 Gio en mémoire unifiée ou système. Sur les PC avec Ryzen AI Max+, c’est une autre limite qui compte : AMD ne laisse au processeur graphique que 96 Gio sur 128 Go et 160 Gio sur 192 Go.
 PC avec Ryzen AI Max+ 395 et 128 Go unifiésFiche matériel
| Machine | Mémoire pour le modèle | Tiennent à 8k | Tiennent à 32k |
|---|---|---|---|
| PC avec RTX 4060 8 Go | 7,20 Gio | 7 sur 26 | 3 sur 26 |
| PC avec RTX 3060 12 Go | 11,20 Gio | 8 sur 26 | 8 sur 26 |
| PC avec RTX 4070 12 Go | 11,20 Gio | 8 sur 26 | 8 sur 26 |
| Mac avec M4 et 16 Go unifiés | 13,00 Gio | 9 sur 26 | 9 sur 26 |
| Portable de bureau, processeur seul, 16 Go | 13,00 Gio | 9 sur 26 | 9 sur 26 |
| Mac mini avec M6 et 16 Go unifiés | 13,00 Gio | 9 sur 26 | 9 sur 26 |
| Mac avec M4 Pro et 24 Go | 21,00 Gio | 16 sur 26 | 14 sur 26 |
| Station avec RTX 4090 24 Go | 23,20 Gio | 17 sur 26 | 17 sur 26 |
| Mini-PC avec NPU et 32 Go LPDDR5X | 29,00 Gio | 19 sur 26 | 19 sur 26 |
| Mac mini avec M6 et 32 Go unifiés | 29,00 Gio | 19 sur 26 | 19 sur 26 |
| Serveur avec 2× RTX 3090 (48 Go) | 47,20 Gio | 19 sur 26 | 19 sur 26 |
| Mac avec M4 Max et 64 Go | 61,00 Gio | 20 sur 26 | 20 sur 26 |
| Mac mini avec M5 Pro et 64 Go unifiés | 61,00 Gio | 20 sur 26 | 20 sur 26 |
| Xiaomi AI Cube, 80 Go — prototype d’ingénierie | 77,00 Gio | 22 sur 26 | 22 sur 26 |
| PC avec Ryzen AI Max+ 395 et 128 Go unifiés | 96,00 Gio | 23 sur 26 | 23 sur 26 |
| Mac Studio avec M5 Max et 128 Go unifiés | 125,00 Gio | 23 sur 26 | 23 sur 26 |
| PC avec Ryzen AI Max+ PRO 495 et 192 Go unifiés | 160,00 Gio | 24 sur 26 | 24 sur 26 |
| Mac Studio avec M5 Ultra et 512 Go unifiés | 509,00 Gio | 26 sur 26 | 26 sur 26 |
Calculé par Local AI Scope. « Tient » = poids + mémoire de contexte + marge du programme ≤ mémoire disponible, avec le fichier en Q4_K_M ou dans la compression la plus proche publiée par l’auteur. Retenir Q4_K_M comme plancher est un critère éditorial déclaré, pas une mesure : en dessous la qualité se dégrade, mais de combien, nous ne l’avons pas mesuré.
Une seule machine atteint 26 : le Mac Studio avec M5 Ultra et 512 Go, qui en garde 26 à 32k. glm-5.2 et glm-5.3-flash (187,04 Gio) ne tiennent sur aucune autre, et deepseek-v4-flash (127,28 Gio) ne tient pas en dessous de 192 Go : le plafond d’une machine de 128 Go est de 23 sur 26.
Passer de 8 à 12 Go ajoute exactement un modèle, gemma4-12b : la liste des 12 Go contient celle des 8 Go plus un. Ce que ce palier achète vraiment, c’est de la marge. Le palier qui change la donne est celui de 24 Go, où l’on passe de 8 à 17.
Ce dernier palier en vidéo (en anglais) : le même PC avec la grande carte, puis avec une carte d’entrée de gamme, testé surtout sur la voix et l’image. La grande va plus vite partout ; sur les modèles de langage, c’est la mémoire qui fixe la taille du modèle.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Où la comparaison en anglais cesse de valoir
Le contexte se réserve en tokens, et le même texte ne fait pas le même nombre de tokens en français qu’en anglais : de 1,27 à 1,47 fois plus selon le modèle, mesuré avec le tokeniseur réel de chacun sur un corpus parallèle propre (sha256[:16] 2f6c96b6ea0b161f).
Avec un contrat de 12 000 mots :
| Machine | Anglais | Français | Allemand |
|---|---|---|---|
| PC avec RTX 4060 8 Go | 3 | 3 | 2 |
| PC avec RTX 3060 12 Go | 8 | 8 | 4 |
| PC avec RTX 4070 12 Go | 8 | 8 | 4 |
| Mac avec M4 et 16 Go | 9 | 9 | 5 |
| Portable sans GPU, 16 Go | 9 | 9 | 5 |
| Mac mini avec M6 et 16 Go | 9 | 9 | 5 |
| Mac avec M4 Pro et 24 Go | 14 | 14 | 12 |
| Station avec RTX 4090 24 Go | 17 | 17 | 14 |
| Mini-PC avec NPU et 32 Go | 19 | 19 | 17 |
| Mac mini avec M6 et 32 Go | 19 | 19 | 17 |
| Serveur 2× RTX 3090 (48 Go) | 19 | 19 | 17 |
| Mac avec M4 Max et 64 Go | 20 | 20 | 18 |
| Mac mini avec M5 Pro et 64 Go | 20 | 20 | 18 |
| Xiaomi AI Cube, 80 Go (prototype) | 22 | 22 | 20 |
| PC avec Ryzen AI Max+ 395 et 128 Go | 23 | 23 | 21 |
| Mac Studio avec M5 Max et 128 Go | 23 | 23 | 21 |
| PC avec Ryzen AI Max+ PRO 495 et 192 Go | 24 | 24 | 22 |
| Mac Studio avec M5 Ultra et 512 Go | 26 | 26 | 24 |
Mesuré par Local AI Scope. Document de type contrat de 12 000 mots, avec la même réserve de réponse que celle qu’applique le trouveur : 10 % du document, minimum 300 mots, soit 1 200 ici. Le contexte est calculé avec la fertilité réelle de chaque modèle, arrondi au palier du programme et plafonné par le contexte maximal que le modèle déclare : qwen3-1.7b et qwen3-8b déclarent 40k et ce document en demande 64k en allemand, ils sortent donc de la colonne allemande. Même critère d’ajustement que le tableau précédent.
À 12 000 mots, le français donne exactement la même liste que l’anglais : le document est si long que les deux langues tombent déjà sur le même palier de contexte. L’allemand, lui, perd des modèles sur les 18 machines. Que le français fasse jeu égal ici ne veut pas dire qu’il est gratuit : cela veut dire qu’à cette longueur précise, il ne se voit plus. En mesurant par pas de 100 mots de 100 à 20 000 — le maximum admis par le trouveur — sur les 18 machines du catalogue et avec sa réserve de réponse, le français ne retire aucun modèle avant 4 200 mots, puis il en coûte un entre 4 200 et 5 700, de nouveau entre 8 700 et 11 600, et à partir de 16 600 ; hors de ces plages, aucun. L’allemand commence dès 2 800 et, lui, ne s’arrête plus. Ce n’est donc pas une pente : c’est un escalier, parce que le programme réserve le contexte en puissances de deux. À 5 000 mots, qwen3-8b demande 8k de contexte en anglais et 16k en français, tandis que gemma4-12b reste à 8k dans les deux.
Un tokeniseur se distingue sur le français
La pénalité suit la taille du vocabulaire du tokeniseur, pas la marque : les grands vocabulaires de 2026 se tiennent entre 1,27 et 1,29 en français, les petits paient de 1,29 à 1,47. Une ligne mérite d’être lue à part, et c’est la plus intéressante ici (spoiler : le chiffre suit le tokeniseur, pas le drapeau du modèle).
| Modèle | Vocabulaire | Français | Allemand |
|---|---|---|---|
gemma4-12b |
262 144 | 1,27 | 1,33 |
gpt-oss-20b |
201 088 | 1,28 | 1,29 |
mistral-small-24b / nemotron-3.5-super-120b / nemotron-3.5-lightning-30b |
131 072 | 1,29 | 1,40 |
glm-5.2 |
154 880 | 1,40 | 1,49 |
qwen3-8b |
151 936 | 1,46 | 1,62 |
Mesuré par Local AI Scope, corpus parallèle sha256[:16] 2f6c96b6ea0b161f.
mistral-small-24b a le plus petit vocabulaire du tableau, 131 072 entrées, et se place pourtant à 1,29 en français, au niveau de modèles au vocabulaire deux fois plus grand. Sur l’allemand, le même modèle retombe à 1,40, derrière les deux grands vocabulaires du tableau. Les deux Nemotron 3.5 de NVIDIA présents dans notre catalogue, nemotron-3.5-super-120b et nemotron-3.5-lightning-30b, donnent exactement les mêmes chiffres, au token près, dans les quatre langues. Ni hasard ni drapeau du modèle : nous avons ouvert les trois fichiers de tokeniseur, et le tekken.json de Mistral, et c’est le même tokeniseur, Tekken, avec le même vocabulaire de 131 072 positions dans le même ordre et les mêmes 269 443 règles de fusion. Seuls quelques tokens de contrôle changent de nom (22 au plus), des balises de conversation, de raisonnement, d’appels d’outils ou d’images par exemple, jamais un morceau de mot. Le 1,29 appartient au tokeniseur, et mistral-small-24b, lui, tient en 13,35 Gio.
 mistral-small-24bFiche modèle
Ce qu’il faut vérifier avant de payer
- La quantité de mémoire, pas le numéro de la carte. Une RTX 4070 12 Go et une RTX 3060 12 Go font tenir exactement les mêmes 8 modèles. La 4070 les exécute plus vite, elle n’en fait tenir aucun de plus.
- La taille réelle du fichier publié, pas le nombre de paramètres.
gemma4-12bpèse 6,63 Gio etqwen3-coder-30bpèse 17,28 Gio : le second n’entre dans aucune machine de 12 Go. - La mémoire unifiée d’un Mac n’est pas de la mémoire graphique. Un Mac de 16 Go laisse 13 Gio et fait tenir 9 modèles, 2 de plus qu’une 4060 de 8 Go, nettement moins vite.
- La bande passante décide de la vitesse, pas de ce qui tient. Le portable sans carte graphique fait tenir les 9 mêmes modèles que le Mac M4 16 Go, à 83 Go/s contre 120 Go/s.
Ce qui n’est pas mesuré ici
Nous mesurons le coût de la langue en tokens et ce qu’il oblige à réserver. Nous ne mesurons pas la qualité des réponses en français : cela exige d’exécuter les modèles et d’évaluer leurs sorties, avec un GPU dont nous ne disposons pas. Appeler « benchmark » une formule est précisément l’erreur que ce site existe pour éviter.
Les vitesses affichées à côté de chaque résultat sont estimées, à partir de la bande passante annoncée par le fabricant. Elles ne décident jamais si un modèle tient.
Calculez avec votre machine
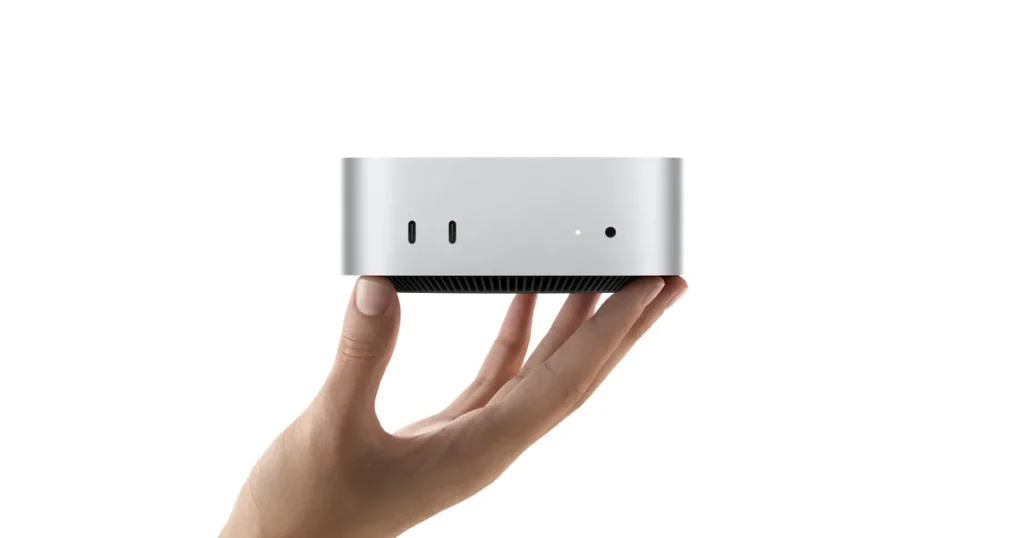
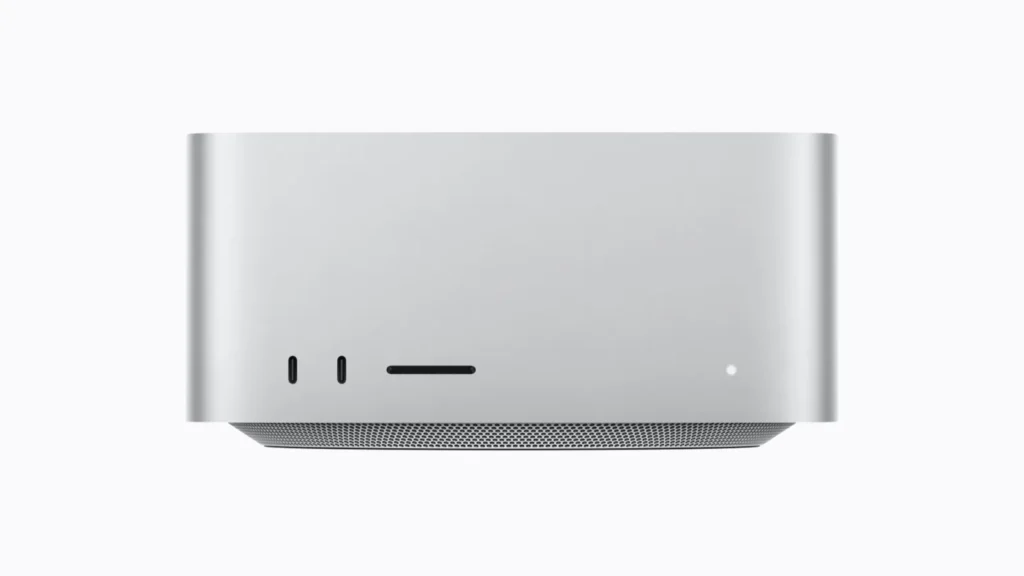
Un modèle qui vous répond depuis chez vous, c’est vite addictif : autant viser juste du premier coup. Le trouveur de modèles refait ce calcul avec votre machine, votre document et votre langue pour les 26 modèles, entièrement dans votre navigateur : ce que vous décrivez n’en sort pas. Pour partir du matériel, les fiches machine (comme celle du Mac mini en photo) donnent les deux listes, ce qui tient et ce qui ne tient pas. Le programme qui exécute le modèle compte aussi : voir les fiches logiciels.