GGUF es el formato de modelo en un solo archivo que leen llama.cpp, Ollama y LM Studio. El Q4_K_M, Q5_K_M o Q8_0 del nombre es la cuantización: cuántos bits conserva cada peso. Q4_K_M es lo habitual: en nuestra prueba pesó el 59 % de Q8_0 y eligió el mismo token siguiente que el original el 89 % de las veces.
El 18 de noviembre de 2026 bajamos los GGUF oficiales de Qwen2.5 1.5B Instruct en 6 versiones (de F16 a Q3_K_M) y los pasamos por llama.cpp (build b12500) en un servidor Linux sin tarjeta gráfica, con un procesador AMD Ryzen 7 7730U y 8 hilos. Medimos cuánto pesa cada archivo, a qué velocidad escribe y cuántas veces su elección del token siguiente difiere de la del modelo sin cuantizar. Después pasamos los 28 modelos de nuestro buscador de modelos por el mismo cálculo que usa la herramienta, para ver qué cabe en 8, 12, 16, 24 y 32 GB con cada nivel. Todo lo que sigue va etiquetado con su origen.
Qué es GGUF y qué significa Q4_K_M en el nombre del archivo
Un archivo GGUF lleva dentro todo lo que un modelo necesita para funcionar, de una pieza: los pesos, el tokenizador, la arquitectura y, normalmente, la plantilla de chat. Por eso puedes bajar un solo archivo y abrirlo tal cual en llama.cpp, LM Studio u Ollama. El formato nació en el proyecto llama.cpp, y esos 3 programas lo leen porque se apoyan en llama.cpp y en su biblioteca ggml.
 llama.cppFicha del programa
La cuantización es la compresión. Un modelo sin cuantizar guarda cada peso en 16 o 32 bits; un archivo cuantizado lo guarda en menos, por bloques que comparten una escala. El nombre te dice cómo:
- El número (Q3, Q4, Q5, Q6, Q8) son los bits de base por peso.
- La K marca la familia «k-quants», que trabaja por bloques agrupados en superbloques. Q8_0 y Q4_0 son la familia antigua, más sencilla.
- La _S, _M o _L es la mezcla: pequeña, mediana o grande. No es el tamaño del modelo, sino cuántos tensores se quedan con más precisión.
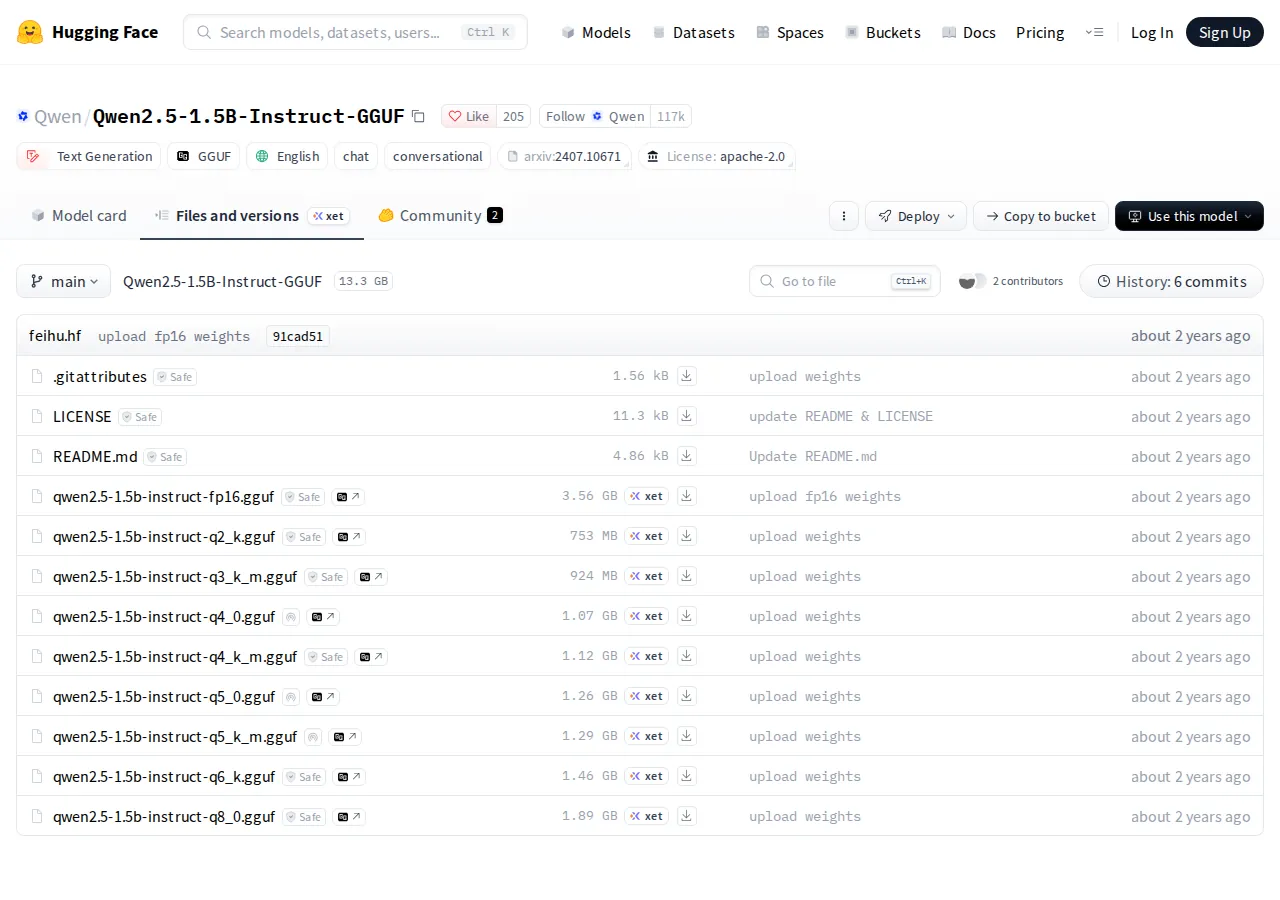
Esto último lo comprobamos abriendo los archivos. Nuestro Q4_K_M tiene 169 tensores a 4 bits (q4_K) y 29 a 6 bits (q6_K); Q5_K_M tiene el mismo reparto 169/29 con 5 bits de base; Q6_K y Q8_0 usan un único tipo para los 198 tensores cuantizados. O sea, cuando eliges Q4_K_M no eliges «todo a 4 bits»: eliges 4 bits con las partes más delicadas protegidas. Por eso llama.cpp informa de 5,00 bits por peso en este Q4_K_M y no de 4.
Si lo que dudas es entre GGUF y los safetensors originales, que son los que cargan vLLM y transformers, esa comparación está en nuestra guía vLLM vs Ollama, y en un Mac, en MLX vs GGUF.
Niveles de cuantización GGUF: cuánto pesa cada uno
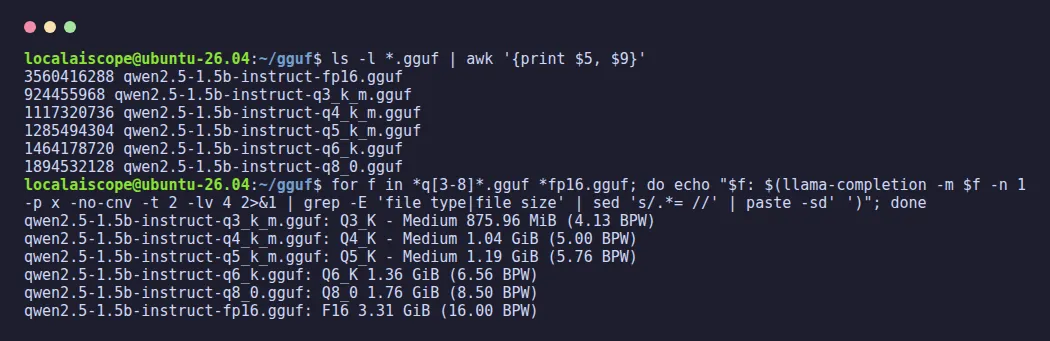
La regla general se cumple: menos bits, archivo más pequeño. Pero no baja en línea recta, por los tensores protegidos y por las partes que nunca se comprimen. Estos son los 6 archivos que medimos, todos del repositorio oficial de Qwen:
| Nivel | Archivo (MB) |
Bits por peso |
vs Q8_0 |
|---|---|---|---|
| F16 | 3.560 | 16,00 | 188 % |
| Q8_0 | 1.895 | 8,50 | 100 % |
| Q6_K | 1.464 | 6,56 | 77 % |
| Q5_K_M | 1.285 | 5,76 | 68 % |
| Q4_K_M | 1.117 | 5,00 | 59 % |
| Q3_K_M | 924 | 4,13 | 49 % |
Este modelo es pequeño y solo su vocabulario tiene 151.936 tokens: eso explica, probablemente, que sus niveles queden tan juntos. En modelos más grandes la escalera se abre: entre los modelos de nuestro catálogo que publican los dos archivos, Q4_K_M pesa de media el 62 % de Q8_0, Q5_K_M el 72 % y Q6_K el 82 %. En Qwen3 8B son 8,11 GiB en Q8_0, 6,26 en Q6_K, 5,45 en Q5_K_M, 4,68 en Q4_K_M y 3,84 en Q3_K_M.
Q4_K_M vs Q5_K_M vs Q8_0: cuánta calidad pierdes
¿Cómo se mide lo que pierde un archivo comprimido? Con el método que trae llama.cpp. Primero, el modelo F16 leyó 10.240 tokens de texto de la Wikipedia en inglés (el conjunto de prueba wikitext-2, 20 bloques de 512 tokens) y guardamos, en cada posición, qué probabilidad daba a cada posible token siguiente. Después cada archivo cuantizado leyó exactamente el mismo texto y llama-perplexity los comparó. Importan dos cifras: cuántas veces el token favorito del modelo cuantizado coincide con el del original, y cuánto sube su perplejidad (PPL) (cuánto le sorprende el texto real; cuanto más baja, mejor).
| Nivel | Misma primera opción (%) |
PPL vs F16 (%) |
KLD medio |
|---|---|---|---|
| Q8_0 | 97,7 | +0,3 | 0,0015 |
| Q6_K | 93,6 | +1,2 | 0,011 |
| Q5_K_M | 91,8 | +1,2 | 0,017 |
| Q4_K_M | 89,0 | +5,6 | 0,042 |
| Q3_K_M | 82,2 | +13,4 | 0,117 |
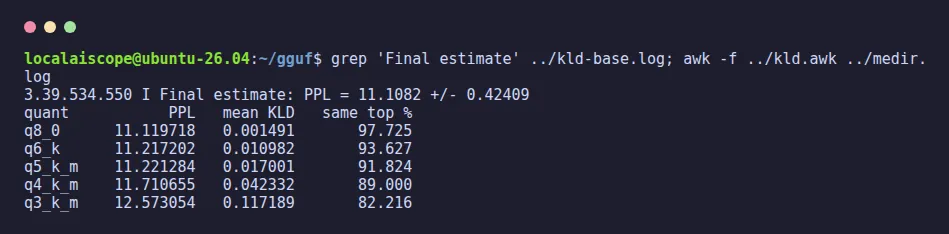
Q8_0 es prácticamente indistinguible del original: la misma primera opción en el 97,7 % de los tokens y un 0,3 % más de perplejidad. Q6_K y Q5_K_M cuestan lo mismo en perplejidad (+1,2 %), aunque Q5_K_M se desvía algo más a menudo en su primera opción. Q4_K_M es el primer escalón de verdad: +5,6 % de perplejidad y una primera opción distinta en más o menos 1 de cada 9 tokens. Eso no quiere decir 1 palabra equivocada de cada 9: una primera opción distinta no es por fuerza una opción equivocada. Q3_K_M es donde empieza a doler: más del doble de pérdida de perplejidad que Q4_K_M y casi 3 veces su desviación (la columna KLD).
Un límite, dicho claro: es 1 modelo de 1.500 millones de parámetros medido sobre 1 texto en inglés. No hemos medido modelos más grandes de esta forma, así que no les ponemos cifra.
Velocidad: el archivo pequeño también escribe más rápido
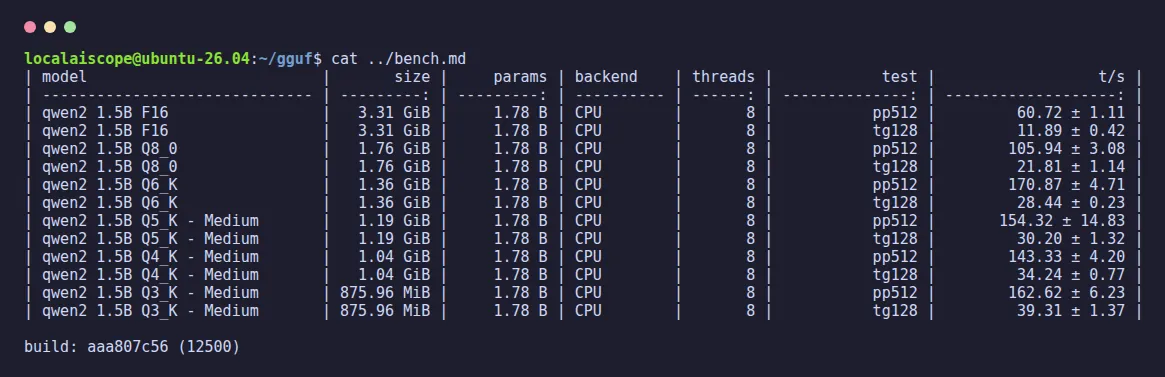
En un ordenador sin tarjeta gráfica, escribir cada token obliga a leer el modelo entero de la memoria, así que menos archivo es más tokens por segundo. Nuestra prueba con llama-bench (128 tokens escritos y un prompt de 512 leído, 3 repeticiones, 8 hilos) lo confirma. Por una vez, ponerse a dieta te hace más rápido:
| CPU 18-11-2026 |
Escribe (tok/s) |
Lee (tok/s) |
|---|---|---|
| F16 | 11,9 | 61 |
| Q8_0 | 21,8 | 106 |
| Q6_K | 28,4 | 171 |
| Q5_K_M | 30,2 | 154 |
| Q4_K_M | 34,2 | 143 |
| Q3_K_M | 39,3 | 163 |
La velocidad de escritura sube en orden según baja el archivo: Q4_K_M escribe un 57 % más rápido que Q8_0 en el mismo procesador. La lectura del prompt no sigue ese orden: ahí el trabajo es sobre todo de cálculo y no de memoria, así que depende de cómo se desempaqueta cada formato en esta CPU. Un matiz: el servidor tenía otros trabajos en marcha a la vez, así que diferencias pequeñas como la de Q6_K frente a Q5_K_M quedan dentro del ruido. En tarjeta gráfica no lo hemos medido.
Qué cabe en 8, 12, 16, 24 y 32 GB con cada cuantización
Aquí es donde la cuantización se gana el sueldo. Contamos, con el mismo cálculo que usa nuestro buscador de modelos (pesos + la caché KV real del modelo + un margen para el programa, con 8.192 tokens de contexto), cuántos de nuestros 28 modelos caben en cada memoria según el nivel que bajes:
| Memoria | Q8_0 | Q5_K |
Q4_K |
Q3_K |
|---|---|---|---|---|
| 8 GB | 3 | 5 | 7 | 8 |
| 12 GB | 7 | 8 | 9 | 9 |
| 16 GB | 9 | 10 | 10 | 12 |
| 24 GB | 10 | 16 | 18 | 18 |
| 32 GB | 14 | 18 | 20 | 18 |
Los equipos son los de nuestro catálogo: un PC con RTX 4060 (8 GB), otro con RTX 3060 (12 GB), un Mac con M4 (16 GB), una estación con RTX 4090 (24 GB) y un Mac mini con M6 (32 GB). Q6_K, fuera de la tabla por espacio, queda en medio: 3, 8, 9, 14 y 17 modelos. Cómo leerla: con 8 GB de VRAM, pasar de Q8_0 a Q4_K_M te lleva de 3 modelos a 7. Con 24 GB, de 10 a 18. La columna de Q3_K_M no siempre crece porque no todos los modelos publican ese nivel: lo tienen 23 de nuestros 28, frente a 26 con Q4_K_M. La memoria que contamos es la que queda para el modelo: 0,8 GiB menos en una tarjeta gráfica para el escritorio y 3 GiB menos en un Mac o en la RAM para el sistema. Otro detalle: la columna de Q3_K_M cuenta lo que cabe, pero el buscador enseña aparte todo lo que queda por debajo de Q4_K_M en vez de contarlo.
Un ejemplo concreto: Qwen3 8B pide 9,99 GiB en Q8_0 con ese contexto, que no caben en la RTX 4060 (7,2 GiB disponibles), y 6,56 GiB en Q4_K_M, que sí. El contexto también cuesta memoria; si vas justo, nuestra guía de longitud de contexto te dice cuánto cuesta cada escalón.
Cómo bajar una cuantización concreta
En Hugging Face, los repositorios oficiales suelen tener un archivo por nivel, y los 3 programas grandes te dejan elegir:
- llama.cpp: el nivel va detrás de dos puntos.
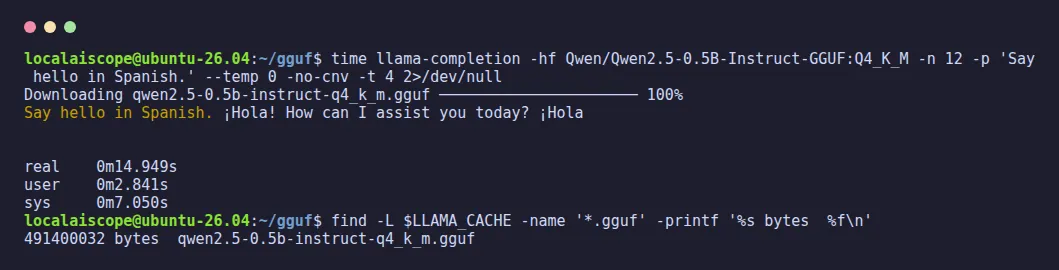
llama-completion -hf Qwen/Qwen2.5-0.5B-Instruct-GGUF:Q4_K_Mbajó el archivo de 491.400.032 bytes y respondió en 14,9 segundos, descarga incluida, en nuestra prueba, aunque el nombre del archivo está en minúsculas. Le pedimos en inglés que saludara en español, contestó «¡Hola!» y, sin que nadie se lo pidiera, se pasó al inglés para ofrecer ayuda: bilingüe sí, obediente no tanto. llama-server acepta la misma opción-hf. - Ollama: con un modelo de Hugging Face, el mismo patrón:
ollama run hf.co/usuario/repositorio:Q4_K_M(esta vía no la probamos hoy). Para cargar un GGUF que ya tienes en disco,FROM ./modelo.ggufen un Modelfile, como contamos en nuestra guía de comandos de Ollama. - LM Studio: al bajar un modelo te enseña los archivos del repositorio con su tamaño y eliges uno (no lo probamos esta vez). Si se queja con «no LM runtime found for model format ‘gguf’», el arreglo está en LM Studio no funciona.
Se abre en YouTube (sin cookies) solo si pulsas.
Un vídeo en español de octubre de 2026 que explica qué es un modelo, qué significan 4B u 8B, la cuantización, el formato GGUF y cuánta memoria necesitas.
Qué cuantización GGUF bajar
- El modelo te cabe con holgura: Q5_K_M o Q6_K. Pierdes casi nada frente a Q8_0 y te queda memoria para el contexto.
- El caso normal: Q4_K_M. Es el nivel que nuestro buscador toma como referencia, el que convierte 3 modelos en 7 en una tarjeta gráfica de 8 GB, y en nuestra medida tuvo la misma primera opción que el original en el 89 % de los tokens.
- Te sobra memoria o estás midiendo: Q8_0, que es prácticamente el modelo original a la mitad de tamaño que F16.
- No te cabe en Q4_K_M: antes de bajar a Q3_K_M, prueba un modelo más pequeño de la misma familia en Q4_K_M o más. Por debajo de Q4_K_M, nuestro buscador te enseña el modelo aparte en vez de contarlo como que cabe.
Si prefieres no hacer las cuentas tú, el buscador de modelos las hace para tu equipo, modelo a modelo, con los mismos números que esta página.