Los comandos de Ollama que vas a usar a diario son ollama pull (bajar un modelo), ollama list (ver los que tienes), ollama run (chatear), ollama ps y ollama stop (qué hay en memoria), ollama rm (borrar), ollama cp y ollama create (copias y modelos propios con un Modelfile). Aquí van todos con su salida real.
Hemos lanzado cada comando de esta chuleta el 14 de noviembre de 2026 con Ollama 0.40.16, la última versión estable en esa fecha, dentro de Docker con la imagen oficial ollama/ollama:0.40.16, en un servidor sin tarjeta gráfica (un procesador AMD Ryzen 7 7730U). Como conejillo de indias elegimos uno de los modelos más pequeños del catálogo, smollm2:135m, para que todo responda en segundos. Los bloques de salida están copiados de nuestra terminal tal cual, errores incluidos: cuando veas uno de esos mensajes en tu pantalla, sabrás exactamente dónde estás.
 OllamaFicha del programa
Todos los comandos de Ollama en una tabla
ollama --help en la v0.40.16 enumera 15 comandos, a 14 de noviembre de 2026. Estos son los que importan para usar modelos en casa:
| Comando | Para qué sirve | Ejemplo |
|---|---|---|
pull |
Descarga un modelo del catálogo | ollama pull smollm2:135m |
list |
Lista los modelos que tienes bajados | ollama list |
run |
Carga un modelo y chatea con él | ollama run smollm2:135m |
ps |
Muestra los modelos cargados en memoria | ollama ps |
stop |
Descarga un modelo de la memoria | ollama stop smollm2:135m |
show |
Enseña los datos y el Modelfile de un modelo | ollama show smollm2:135m --modelfile |
create |
Crea un modelo a partir de un Modelfile | ollama create pirata -f Modelfile |
cp |
Copia un modelo con otro nombre | ollama cp smollm2:135m mi-smollm2 |
rm |
Borra un modelo | ollama rm mi-smollm2 |
serve |
Arranca el servidor de Ollama | ollama serve |
Completan la lista push (subir un modelo a un registro), signin y signout (tu cuenta de ollama.com), launch (el menú de Ollama y sus integraciones) y help. Con -v sale la versión: ollama version is 0.40.16. Y si todavía no tienes Ollama instalado, nuestra guía para instalar Ollama en local te deja listo en unos minutos.
ollama pull y ollama list: bajar modelos y ver cuáles tienes
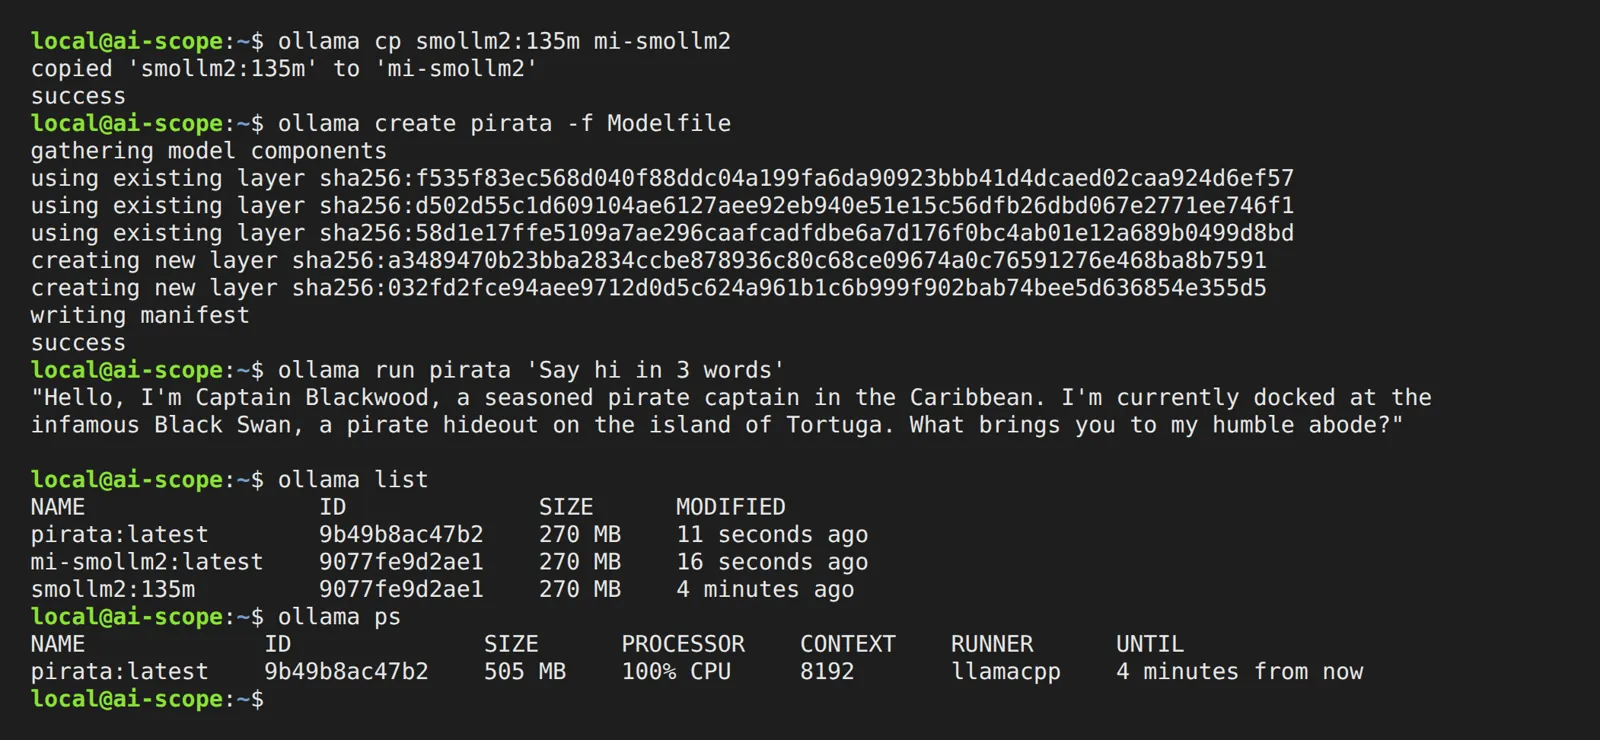
ollama pull descarga un modelo por su nombre y su etiqueta (lo que va detrás de los dos puntos). El 14-11-2026, con la v0.40.16, nuestro modelo de 270 MB bajó en 9,1 segundos, con la barra de progreso marcando hasta 60 MB/s. Repetir el mismo pull tardó 0,8 segundos, porque el modelo ya estaba: solo comprobó el resumen criptográfico, reescribió el manifiesto y avisó con removing unused layers.
$ ollama list
NAME            ID              SIZE      MODIFIED
smollm2:135m    9077fe9d2ae1    270 MB    1 second ago
ollama list tiene cuatro columnas en la v0.40.16 (14-11-2026): nombre, ID, tamaño y cuándo se modificó. El ID es el principio del resumen sha256 del manifiesto del modelo, y por eso dos nombres que comparten manifiesto salen con el mismo ID (lo verás con cp). El tamaño va en megabytes decimales: du -h nos dio 259M para la carpeta de modelos (270.902.687 bytes, casi todo el fichero de pesos), sencillamente porque du cuenta en mebibytes. No falta nada.
«Error: pull model manifest: file does not exist»
En la v0.40.16 (14-11-2026), es el error de un nombre que no existe en el catálogo, y también el de una etiqueta inexistente de un modelo que sí existe: nos salió con modelo-que-no-existe y con smollm2:999m.
$ ollama pull smollm2:999m
Error: pull model manifest: file does not exist
ollama run con un modelo que no tienes intenta bajarlo primero, así que una errata en run te da exactamente el mismo mensaje. Revisa la ortografía y la etiqueta en la página del modelo en el catálogo. Los demás comandos se quejan de otra forma cuando el modelo no está, y conviene reconocer cada queja:
$ ollama rm no-existe
Error: model 'no-existe' not found
$ ollama stop no-existe
Error: couldn't find model "no-existe" to stop
$ ollama cp no-existe:latest otro
Error: model "no-existe:latest" not found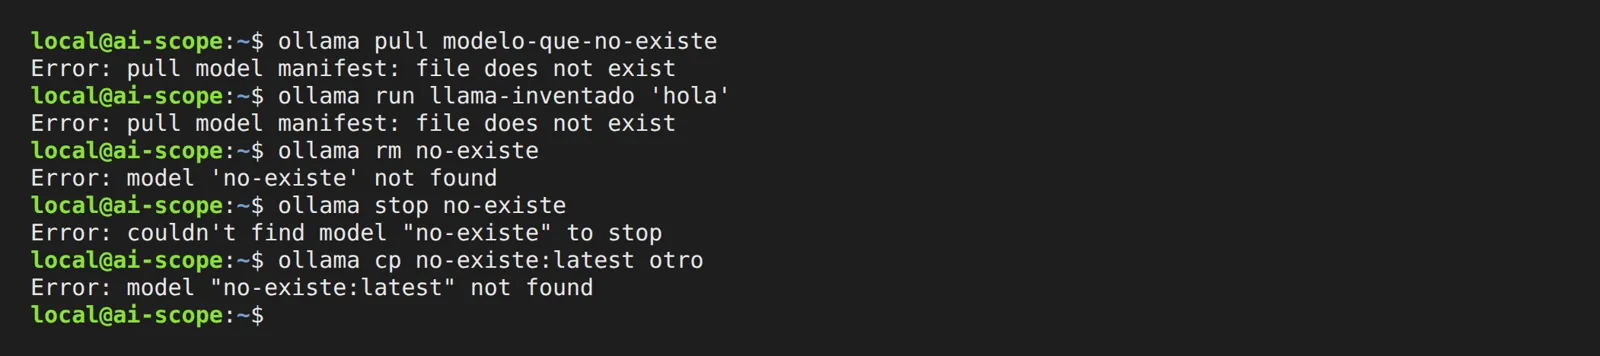
Para los mensajes del servidor, la GPU o la red, tienes nuestra lista de errores de Ollama con su texto exacto.
ollama run, ps y stop: qué hay en memoria y cuánto ocupa
ollama run modelo abre un chat interactivo (sales con /bye), y ollama run modelo "pregunta" contesta una vez y te devuelve a la terminal. Con --verbose además enseña los tiempos. Le pedimos un saludo de tres palabras:
$ ollama run smollm2:135m "Say hi in 3 words" --verbose
Sammy!
total duration:       846.099538ms
load duration:        779.473469ms
prompt eval count:    36 token(s)
prompt eval duration: 36.411ms
prompt eval rate:     988.71 tokens/s
eval count:           4 token(s)
eval duration:        27.433ms
eval rate:            145.81 tokens/s
Una palabra en vez de tres, y encima un nombre que nadie le había pedido: 135 millones de parámetros dan para lo que dan. Lo útil está en los números: de los 846 milisegundos, 779 se fueron en cargar el modelo, y la respuesta salió a 145,81 tokens por segundo solo con ese procesador (v0.40.16, 14-11-2026).
ollama ps enseña lo que se queda cargado. En la v0.40.16 (14-11-2026) tiene siete columnas: nombre, ID, tamaño en memoria, procesador, contexto, motor y cuánto falta para que se descargue.
$ ollama ps
NAME            ID              SIZE      PROCESSOR    CONTEXT    RUNNER      UNTIL
smollm2:135m    9077fe9d2ae1    383 MB    100% CPU     4096       llamacpp    4 minutes from now
Esos «4 minutes from now» salen de los 5 minutos que el modelo sigue cargado por defecto tras tu último mensaje (la variable OLLAMA_KEEP_ALIVE). ollama stop smollm2:135m lo saca de la memoria en el acto, sin borrar nada: ps vuelve vacío y el modelo sigue en list. Si paras un modelo que tienes bajado pero no cargado, la v0.40.16 no dice nada ni da error.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
Este vídeo, en inglés, hace un recorrido parecido: ejecutar modelos desde la terminal, añadir más modelos, la API HTTP y, al final, personalizar un modelo.
ollama show y el Modelfile: FROM, PARAMETER num_ctx y SYSTEM
ollama show smollm2:135m te da la ficha del modelo: arquitectura (llama), parámetros (134.52M), contexto máximo (8192), cuantización (F16) y capacidades. Con --modelfile imprime la receta entera y con --parameters solo los parámetros. Esa receta es un Modelfile, y puedes escribir la tuya:
FROM smollm2:135m
PARAMETER num_ctx 8192
PARAMETER temperature 0.2
SYSTEM """You are a pirate. Answer in one short sentence."""
FROM dice de qué modelo parte (un nombre o un fichero GGUF), PARAMETER fija opciones como el contexto (num_ctx) o la temperatura, y SYSTEM pone las instrucciones que lleva de serie. Después:
$ ollama create pirata -f Modelfile
gathering model components
using existing layer sha256:f535f83ec568…
using existing layer sha256:d502d55c1d60…
using existing layer sha256:58d1e17ffe51…
creating new layer sha256:a3489470b23b…
creating new layer sha256:032fd2fce94a…
writing manifest
success
(Hemos acortado los resúmenes sha256.) Con la v0.40.16 tardó 0,19 segundos: reaprovecha las tres capas que ya tenía (entre ellas la de pesos) y solo escribe lo nuevo. Si el fichero de la carpeta en la que estás se llama Modelfile, basta con ollama create nombre, sin -f; lo probamos. Nuestro pirata, por cierto, se saltó lo de «una frase corta» y se presentó como el capitán Blackwood, atracado en Tortuga. La línea SYSTEM funciona; la obediencia a 135M es otra historia.
Si lo que quieres es solo más contexto, nuestra guía de la longitud de contexto en Ollama explica todas las formas de cambiarlo y lo que cuesta en memoria.
«Error: unknown parameter», «command must be one of» y «no FROM line»: un Modelfile mal escrito
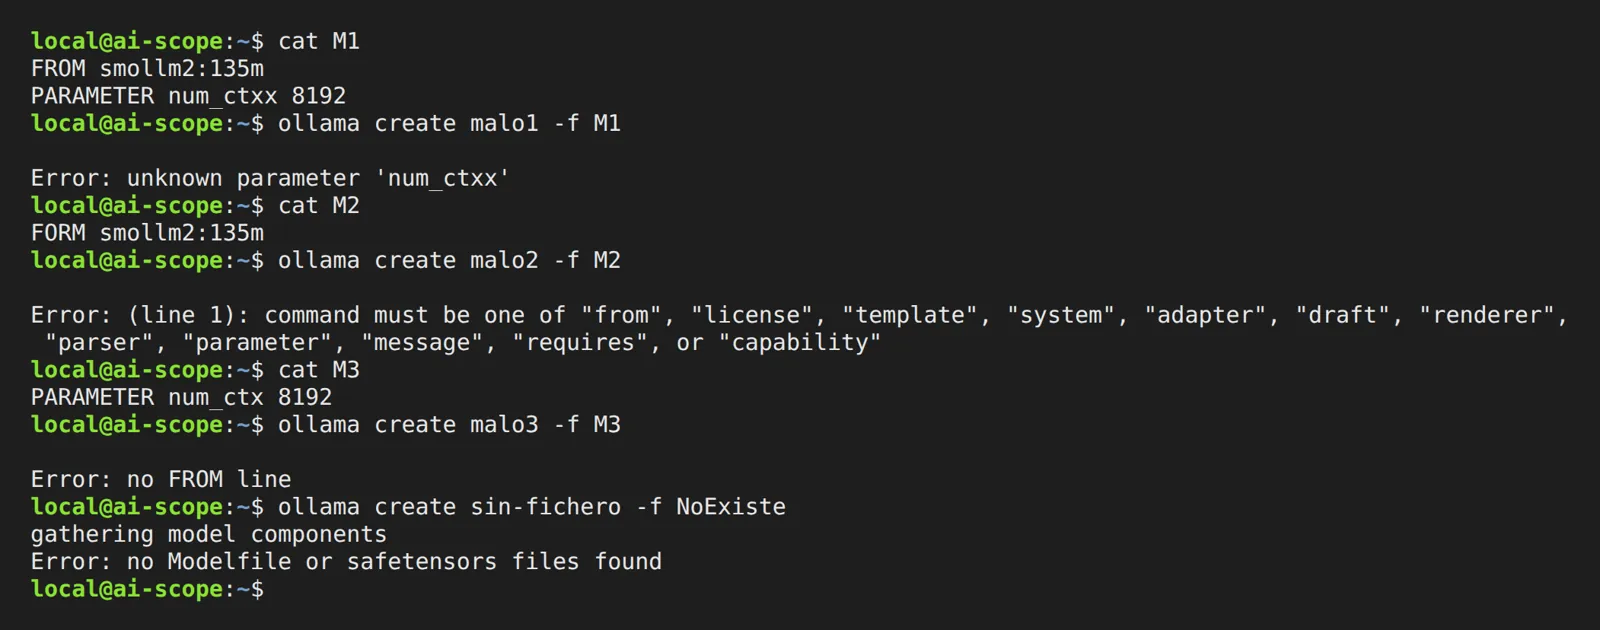
Rompimos el Modelfile a propósito, de una en una. Estos son los mensajes exactos de ollama create en la v0.40.16:
| Fallo en el Modelfile | Mensaje |
|---|---|
PARAMETER num_ctxx 8192 (errata en el nombre) |
Error: unknown parameter 'num_ctxx' |
PARAMETER num_ctx ocho (no es un número) |
Error: invalid int value [ocho] |
FORM smollm2:135m (instrucción mal escrita) |
Error: (line 1): command must be one of "from", "license", "template", "system", "adapter", "draft", "renderer", "parser", "parameter", "message", "requires", or "capability" |
Sin línea FROM |
Error: no FROM line |
FROM no-existe:1b |
Error: pull model manifest: file does not exist |
FROM ./no-hay.gguf (el fichero no está) |
Error: 400 Bad Request: invalid model name |
-f apuntando a un fichero que no existe |
Error: no Modelfile or safetensors files found |
La más traicionera es la del GGUF que no está: el mensaje no dice «fichero no encontrado», sino «invalid model name». Revisa la ruta respecto a la carpeta desde la que lanzas create.
ollama cp y ollama rm: una copia que ocupa 89 bytes
ollama cp smollm2:135m mi-smollm2 tardó 0,15 segundos, y aquí viene lo bonito: la carpeta de modelos creció 89 bytes. El 14-11-2026, con Ollama 0.40.16, la copia es un enlace simbólico al mismo manifiesto, así que ollama list enseña los dos nombres con el mismo ID y 270 MB cada uno, pero esos 270 MB están en el disco una sola vez.
En nuestra prueba del 14-11 con la v0.40.16, ollama rm admitió varios nombres a la vez (ollama rm pirata desde-gguf borró los dos) y solo liberó un fichero cuando ningún otro modelo lo usaba: borrar la copia liberó sus 89 bytes y dejó los 270 MB donde estaban, porque el original seguía apuntando a ellos. Cuando se va el último modelo que los usa, el espacio vuelve al momento, sin ningún paso extra.
Importar un GGUF en Ollama: FROM ./modelo.gguf
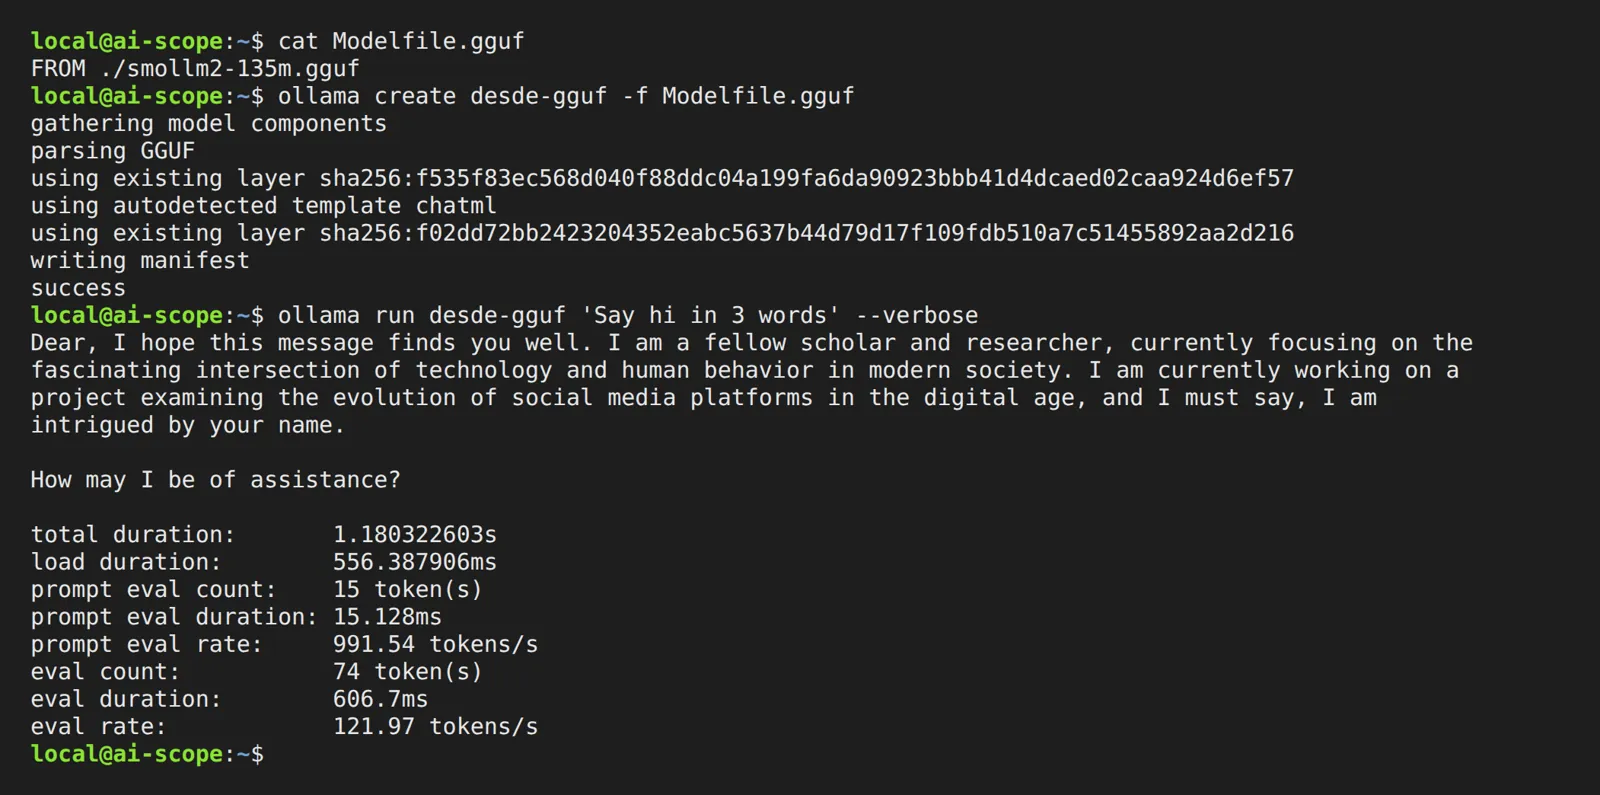
Si ya tienes un modelo en un fichero GGUF, te basta un Modelfile de una línea:
FROM ./smollm2-135m.gguf$ ollama create desde-gguf -f Modelfile.gguf
copying file sha256:f535f83ec568… 100%
parsing GGUF
using existing layer sha256:f535f83ec568…
using autodetected template chatml
creating new layer sha256:f02dd72bb242…
writing manifest
successEn esta pasada, con la carpeta de modelos vacía de antemano, Ollama 0.40.16 detectó él solo la plantilla de chat (chatml), reaprovechó los pesos que acababa de copiar y dejó el modelo listo en 0,6 segundos para 270 MB. Ese «copying file» va en serio: el 14-11-2026 comprobamos que el resultado es una copia aparte dentro de la carpeta de modelos (otro inodo distinto del de tu fichero), así que mientras conserves el original ocupas el espacio dos veces. Borramos el .gguf original y el modelo seguía en ollama list y seguía arrancando. Según su documentación, Ollama no cuantiza al importar: el fichero entra tal cual.
Dónde guarda Ollama los modelos y cómo moverlos con OLLAMA_MODELS
Según la documentación de la v0.40.16, los modelos van aquí:
- Linux (instalador y servicio):
/usr/share/ollama/.ollama/models - macOS:
~/.ollama/models - Windows:
C:\Users\%username%\.ollama\models - Docker (imagen oficial, medido):
/root/.ollama/models, la carpeta donde se monta el volumen
Dentro, el 14-11-2026 con la v0.40.16, encontramos cuatro carpetas: blobs/ (los pesos y cada capa, con su resumen sha256 como nombre), manifests/ (el manifiesto de cada modelo bajado, bajo registry.ollama.ai/library/), manifests-v2/ (enlaces simbólicos bajo ollama.com/library/, también los de las copias hechas con cp) y metadata/ (un JSON con el resumen de los pesos como nombre, que empieza por "ollama_version":"0.40.16"). Todo el espacio está en blobs/: el fichero de pesos medía 270.885.952 bytes y el resto junto no llegaba a 17 KB.
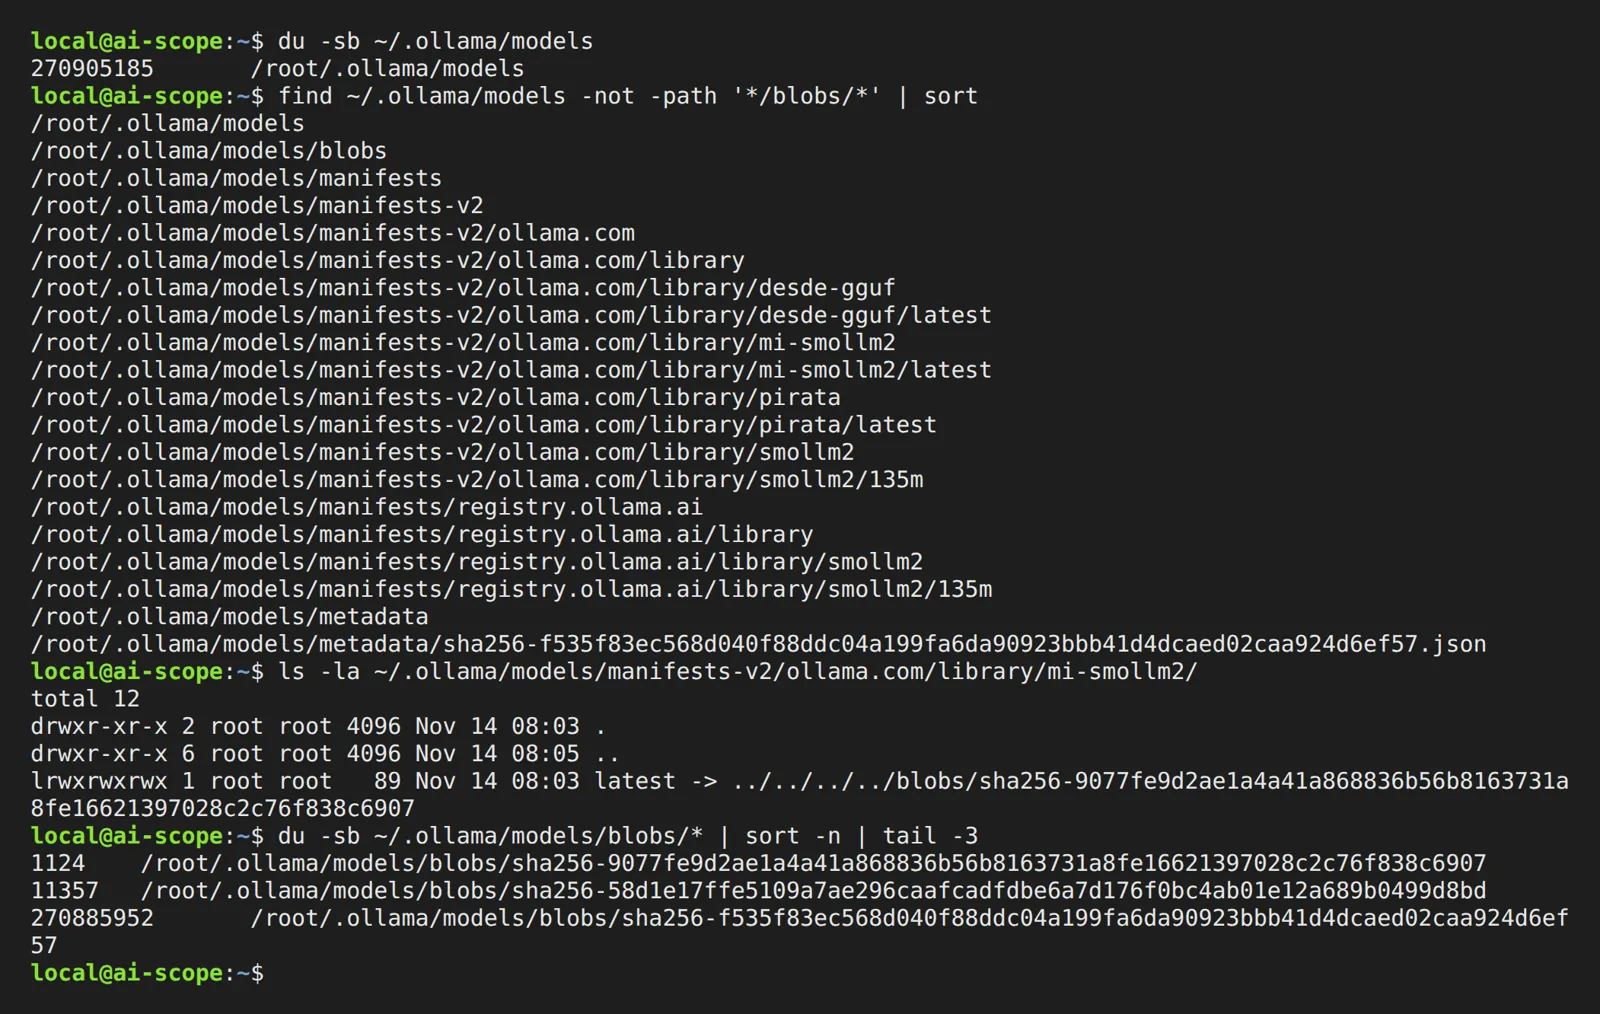
Para guardarlos en otro sitio (un segundo disco, por ejemplo), pon la variable OLLAMA_MODELS en el servidor, no en tu terminal. En Linux con el servicio: sudo systemctl edit ollama.service, añade Environment="OLLAMA_MODELS=/datos/ollama" bajo [Service], dale la carpeta al usuario del servicio con sudo chown -R ollama:ollama /datos/ollama y después systemctl daemon-reload y systemctl restart ollama. En macOS, launchctl setenv OLLAMA_MODELS /ruta y reinicia la aplicación. En Windows, una variable de entorno de usuario y reinicia Ollama.
Probamos la mudanza: un servidor con OLLAMA_MODELS apuntando a una carpeta vacía enseñaba un ollama list vacío; copiamos el contenido de models/ con cp -a (259M), reiniciamos y el modelo volvió a aparecer. Copia con cp -a, como hicimos, o con rsync -a: los dos conservan los enlaces simbólicos, y en la v0.40.16 esos enlaces son relativos, así que sobreviven a la mudanza. Si algún día quieres quitar Ollama, nuestra guía para desinstalar Ollama también cubre esta carpeta, porque los modelos son lo que más pesa de todo lo que deja.
ollama serve: «address already in use» y «could not connect to ollama server»
ollama serve arranca el servidor con el que hablan todos los demás comandos. En una instalación normal ya está funcionando como servicio o como aplicación, y lanzarlo otra vez te da esto (v0.40.16, 14-11-2026, en nuestro contenedor, que escucha en 0.0.0.0):
$ ollama serve
Error: listen tcp 0.0.0.0:11434: bind: address already in use
No es una avería: es el segundo servidor encontrándose el puerto ocupado por el primero. El caso contrario es un cliente sin servidor, y el propio mensaje te dice qué hacer:
$ ollama list
Error: could not connect to ollama server, run 'ollama serve' to start it
Ese mismo mensaje nos salió también con OLLAMA_HOST apuntando a un puerto donde no escuchaba nadie, así que si el servidor está en marcha y aun así lo ves, revisa esa variable. ollama serve --help enumera todas las variables del servidor, de OLLAMA_HOST a OLLAMA_MODELS. Si quieres hablar con el servidor desde tu propio código, la API de Ollama es la misma que usan estos comandos; y para tenerlo todo en un contenedor, Ollama en Docker.