Inicio›Equipos›Mac mini con M5 Pro y 64 GB unificados
Mac mini con M5 Pro y 64 GB unificados
Chip de Apple64 GiB307 GB/s9,2 TFLOPS
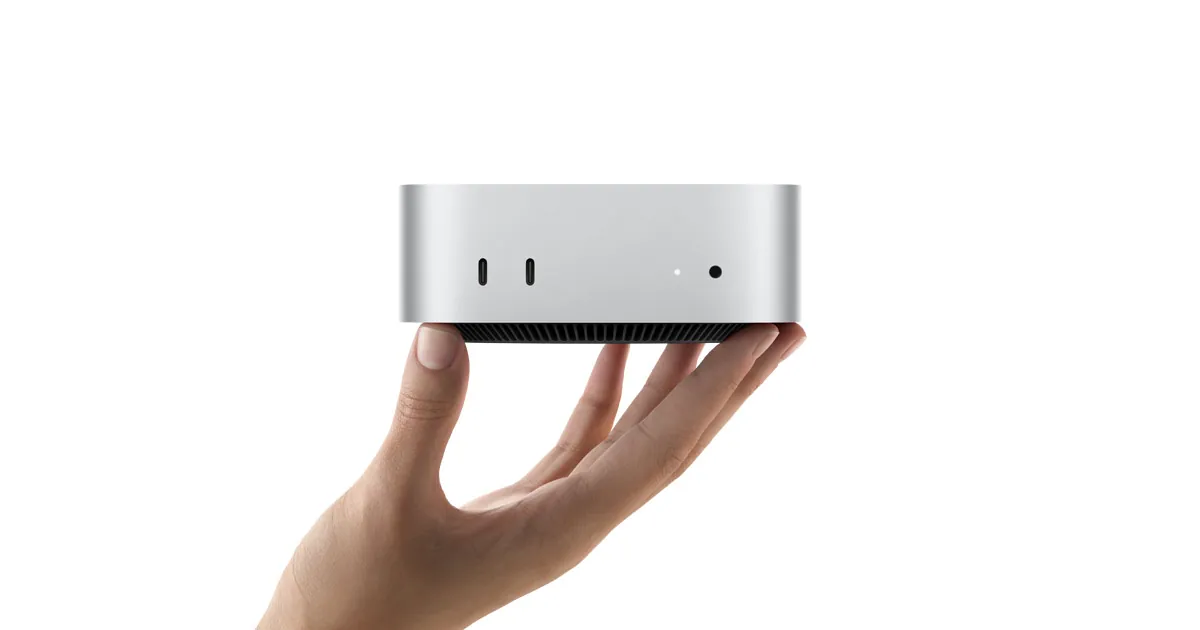
Este equipo deja 61,00 GiB para el modelo una vez el sistema coge lo suyo, y admite 16 de los 20 modelos que medimos en la compresión de referencia. Lo que decide su velocidad de respuesta no es el chip: son los 307 GB/s de ancho de banda de memoria.
Queda para el modelo
Estimación propia
Ancho de banda de memoria
Declarado por el fabricante
Modelos que caben
Medido por Local AI Scope
Vídeos: Mac mini con M5 Pro y 64 GB unificados 3
Lo oficial y las mejores pruebas que hemos encontrado. Pulsa y se abre aquí mismo.
Los vídeos están en YouTube y no se carga nada de allí hasta que pulsas (modo sin cookies). La miniatura la servimos nosotros.
La memoria que de verdad puedes usar
La memoria unificada la comparte el sistema operativo con todo lo que tengas abierto. La reserva de aquí es deliberadamente conservadora; puedes cambiarla en la herramienta.
| Memoria | GiB |
|---|---|
| Memoria del equipo | 64 |
| Reservada al sistema | −3,00 |
| Queda para el modelo | 61,00 |
Ancho de banda de memoria
Son dos límites distintos y se confunden constantemente. Mientras el modelo escribe la respuesta manda el ancho de banda: cada token obliga a releer los pesos enteros, así que los tokens por segundo son aproximadamente el ancho de banda dividido entre el tamaño del modelo. Mientras el modelo lee tu documento manda el cómputo: la entrada se procesa de una vez. Por eso un portátil sin GPU puede tardar minutos en soltar la primera palabra y luego escribir a un ritmo tolerable.
307 GB/s — Declarado por el fabricante · contrastado con la página del fabricante el 2026-09-19 (Fuente).
Los 307 GB/s valen para las dos variantes del M5 Pro y para las tres memorias: Apple publica una sola cifra, al contrario que con el M6 de la misma tabla. Lo que cambia al subir de chip es la GPU: 16 núcleos de serie y 20 en la variante con la que está calculada esta ficha, que es la única con la que Apple vende los 64 GB montados. Ese salto mueve la velocidad estimada de lectura, no lo que cabe.
Cómputo: 9,2 TFLOPS (estimación para esta clase de equipo) — Estimado · el fabricante no publica esta cifra en ninguna parte; la nuestra es una estimación conservadora, no una especificación. Las cifras de esta línea no salen todas de la misma medida según el equipo, porque cada fabricante publica una distinta. Compáralas entre equipos sabiendo eso.
Qué modelos entran aquí y cuáles no
Que quepa significa que caben tres cosas a la vez en la memoria que sobra: el fichero del modelo, su memoria de contexto y el margen de trabajo del runtime. La memoria de contexto se calcula con el patrón de atención que cada modelo declara capa a capa, no con la fórmula genérica: por eso aquí caben modelos que otras calculadoras dan por imposibles.
| Modelo | Compresión mostrada | Tamaño del modelo | 8k | 32k | 128k | Mayor contexto que cabe |
|---|---|---|---|---|---|---|
| qwen3-1.7b | Q4_K_M |
1,03 GiB | sí | sí | — | 32k |
| qwen3-4b-2507 | Q4_K_M |
2,33 GiB | sí | sí | sí | 256k |
| gemma4-e2b | Q4_K_M |
2,89 GiB | sí | sí | sí | 128k |
| gemma4-e4b | Q4_K_M |
4,63 GiB | sí | sí | sí | 128k |
| qwen3-8b | Q4_K_M |
4,68 GiB | sí | sí | — | 32k |
| granite-4.2-8b | Q4_K_M |
4,98 GiB | sí | sí | sí | 128k |
| gemma4-12b | Q4_K_M |
6,63 GiB | sí | sí | sí | 256k |
| gpt-oss-20b | Q4_K_M |
10,83 GiB | sí | sí | sí | 128k |
| mistral-small-24b | Q4_K_M |
13,35 GiB | sí | sí | sí | 128k |
| qwen3.8-27b | Q4_K_M |
15,33 GiB | sí | sí | sí | 256k |
| qwen3.6-27b | Q4_K_M |
15,66 GiB | sí | sí | sí | 256k |
| gemma4-26b-a4b | Q4_K_M |
15,78 GiB | sí | sí | sí | 256k |
| gemma4-31b | Q4_K_M |
17,07 GiB | sí | sí | sí | 128k |
| qwen3-coder-30b | Q4_K_M |
17,28 GiB | sí | sí | sí | 256k |
| qwen3.6-35b-a3b | Q4_K_M |
20,61 GiB | sí | sí | sí | 256k |
| gpt-oss-120b | Q4_K_M |
58,46 GiB | sí | sí | no | 32k |
| llama4-scout-17b | Q4_K_M |
60,87 GiB | no | no | no | — |
| qwen3.8-flash-next | IQ4_XS |
87,25 GiB | no | no | no | — |
| deepseek-v4-flash | IQ4_XS |
127,28 GiB | no | no | no | — |
| glm-5.2 | Q4_K_M |
433,83 GiB | no | no | no | — |
Los tamaños son los de los ficheros realmente publicados en la compresión de referencia, un escalón por fila: Q4_K_M donde el autor la publica y el vecino más cercano donde no. Cada fila dice cuál está enseñando. Q4_K_M es nuestro suelo de calidad: por debajo la pérdida se nota en las respuestas. Un modelo que solo cabría aquí con una compresión más agresiva figura como que no cabe, a propósito. Un guion en una columna de contexto significa que el modelo no ofrece ese contexto, así que no hay nada que encajar.
Modelos que caben — 16 de los 20 modelos medidos
- qwen3-1.7b
Q4_K_M— contexto 32k tokens - qwen3-4b-2507
Q4_K_M— contexto 256k tokens - gemma4-e2b
Q4_K_M— contexto 128k tokens - gemma4-e4b
Q4_K_M— contexto 128k tokens - qwen3-8b
Q4_K_M— contexto 32k tokens - granite-4.2-8b
Q4_K_M— contexto 128k tokens - gemma4-12b
Q4_K_M— contexto 256k tokens - gpt-oss-20b
Q4_K_M— contexto 128k tokens - mistral-small-24b
Q4_K_M— contexto 128k tokens - qwen3.8-27b
Q4_K_M— contexto 256k tokens - qwen3.6-27b
Q4_K_M— contexto 256k tokens - gemma4-26b-a4b
Q4_K_M— contexto 256k tokens - gemma4-31b
Q4_K_M— contexto 128k tokens - qwen3-coder-30b
Q4_K_M— contexto 256k tokens - qwen3.6-35b-a3b
Q4_K_M— contexto 256k tokens - gpt-oss-120b
Q4_K_M— contexto 32k tokens
Modelos que no caben — 4 de los 20 modelos medidos
- llama4-scout-17b
Q4_K_M— le faltan 1,30 GiB - qwen3.8-flash-next
IQ4_XS— le faltan 27,02 GiB - deepseek-v4-flash
IQ4_XS— le faltan 67,29 GiB - glm-5.2
Q4_K_M— le faltan 388,13 GiB
Los equipos de al lado
- Servidor con 2× RTX 3090 (48 GB) — 47,20 GiB para el modelo, 15 / 20 modelos
- Mac con M4 Max y 64 GB — 61,00 GiB para el modelo, 16 / 20 modelos
- Xiaomi AI Cube, 80 GB — prototipo de ingeniería — 77,00 GiB para el modelo, 17 / 20 modelos
- PC con Ryzen AI Max+ 395 y 128 GB unificados — 96,00 GiB para el modelo, 18 / 20 modelos
Precio y disponibilidad
Lo que cuesta una máquina decide tanto como lo que le cabe, así que el precio pertenece a esta página. Aquí abajo va solo lo que publica el fabricante, con el mercado al que se aplica y el día en que se leyó.
Desde 2.899 $ (Estados Unidos), publicado el 2026-09-23 (Fuente). Declarado por el fabricante
Ese es el precio de esta configuración exacta: 64 GB con el disco de partida de 512 GB. El anuncio solo cita 1.699 $, que son los de la base de 24 GB con la GPU de 16 núcleos, así que los 64 GB con los que está calculada esta ficha cuestan 1.200 $ más; la misma máquina con 1 TB de disco cuesta 3.199 $. Apple no publica precio en euros: la cifra es en dólares de Estados Unidos.
Qué ganamos con esta página
Nada, hoy. En esta página no hay ni un enlace de afiliado ni un acuerdo comercial detrás de ninguna de sus cifras. Si alguna vez aparece aquí un enlace de compra, irá marcado como tal y la comisión se declarará en este mismo bloque. Dos reglas no cambian ese día: el ranking de este sitio se calcula antes de aplicar la disponibilidad comercial, y «mejor» no significa nunca «paga más».