Docker Model Runner est la façon dont Docker fait tourner des modèles d’IA sur votre ordinateur : un plugin docker model et un conteneur qui les exécute avec llama.cpp et sert une API compatible OpenAI et Ollama sur le port 12434. Sous Linux, il s’installe avec apt-get install docker-model-plugin ; sur Mac et Windows, il s’active dans Docker Desktop.
Nous l’avons installé le 17 novembre 2026, en version 1.2.9, sur un serveur Linux avec Docker Engine 29.9.3, Ubuntu 26.04 et sans carte graphique (un processeur AMD Ryzen 7 7730U à 16 threads), et nous avons mesuré tout ce que nous pouvions : le temps d’installation, la place sur le disque et en mémoire, les adresses sur lesquelles il écoute, ce qu’il envoie sur le réseau et ce qu’il donne face à Ollama avec le même modèle. Nous l’avons aussi cassé exprès, parce que c’est sur les messages d’erreur qu’on perd le plus de temps. Tout ce qui suit concerne cette version et cette date.
Ce qu’est Docker Model Runner (et ce qu’il n’est pas)
Ce n’est pas un nouveau moteur d’inférence. En version 1.2.9, docker model status affiche llama.cpp comme seul moteur actif sur notre machine, et les autres comme non installés : diffusers, vllm (« binary not found »), sglang et mlx (« only supported on Apple Silicon »).
 llama.cppFiche logiciel
Ce que Docker apporte, c’est l’emballage. Les modèles se téléchargent comme des images, depuis l’espace ai/ de Docker Hub ou directement depuis Hugging Face avec hf.co/…, et se gèrent avec des commandes qui vous parleront si vous utilisez déjà Docker : pull, run, list, ps, rm. Sous Linux avec Docker Engine, tout cela vit dans un conteneur nommé docker-model-runner, avec un volume nommé docker-model-runner-models. Si vous préférez travailler directement avec llama.cpp, notre guide pour démarrer llama.cpp en local décrit ce chemin.
Installer Docker Model Runner sous Linux (docker-model-plugin)
Sous Linux, le plugin vient du dépôt de Docker, le même que celui de Docker Engine. Avant de l’installer, toute commande docker model échoue avec ce message :
$ docker model version
docker: unknown command: docker model
L’installation tient en un seul paquet :
sudo apt-get update
sudo apt-get install docker-model-plugin
Sur Fedora et les autres distributions RPM, c’est sudo dnf install docker-model-plugin. Sur notre serveur, l’apt-get install a pris 4,53 secondes et a laissé un unique binaire de 28 Mo dans /usr/libexec/docker/cli-plugins/docker-model. Docker n’a pas redémarré et aucun des conteneurs déjà lancés ne s’est aperçu de rien.
La vraie installation a lieu à la première utilisation. Notre premier docker model run ai/smollm2 "…" a pris 20,53 secondes au total, et pendant ce temps il a téléchargé l’image docker/model-runner:latest (356 Mo compressée, 1,37 Go sur le disque), créé le volume des modèles, démarré le conteneur, téléchargé le modèle de 270,60 Mo et répondu à la question. Ensuite, une question au modèle déjà chargé revenait en 0,35 seconde.
L’activer sur Mac et Windows (Docker Desktop)
Dans Docker Desktop, rien à installer : ouvrez Settings → AI et cochez Enable Docker Model Runner. Sous Windows avec une carte NVIDIA, une deuxième case apparaît, Enable GPU-backed inference. Si vous voulez appeler l’API depuis la machine elle-même (depuis un script ou un éditeur, par exemple), cochez aussi Enable host-side TCP support, ou lancez docker desktop enable model-runner --tcp 12434.
Les prérequis indiqués par Docker, que nous avons lus sans pouvoir les tester ici : un Mac avec Apple Silicon ; sous Windows x64, des pilotes NVIDIA 576.57 ou plus récents ; sous Windows sur Arm, un GPU Adreno 6xx ou plus récent. Sous Linux avec Docker Engine, il fonctionne sur CPU, NVIDIA (CUDA, pilote 575.57.08 ou plus récent), AMD (ROCm) et Vulkan. Sur Mac et Windows, le moteur ne tourne pas dans un conteneur comme sous Linux, mais dans un environnement isolé du système lui-même.
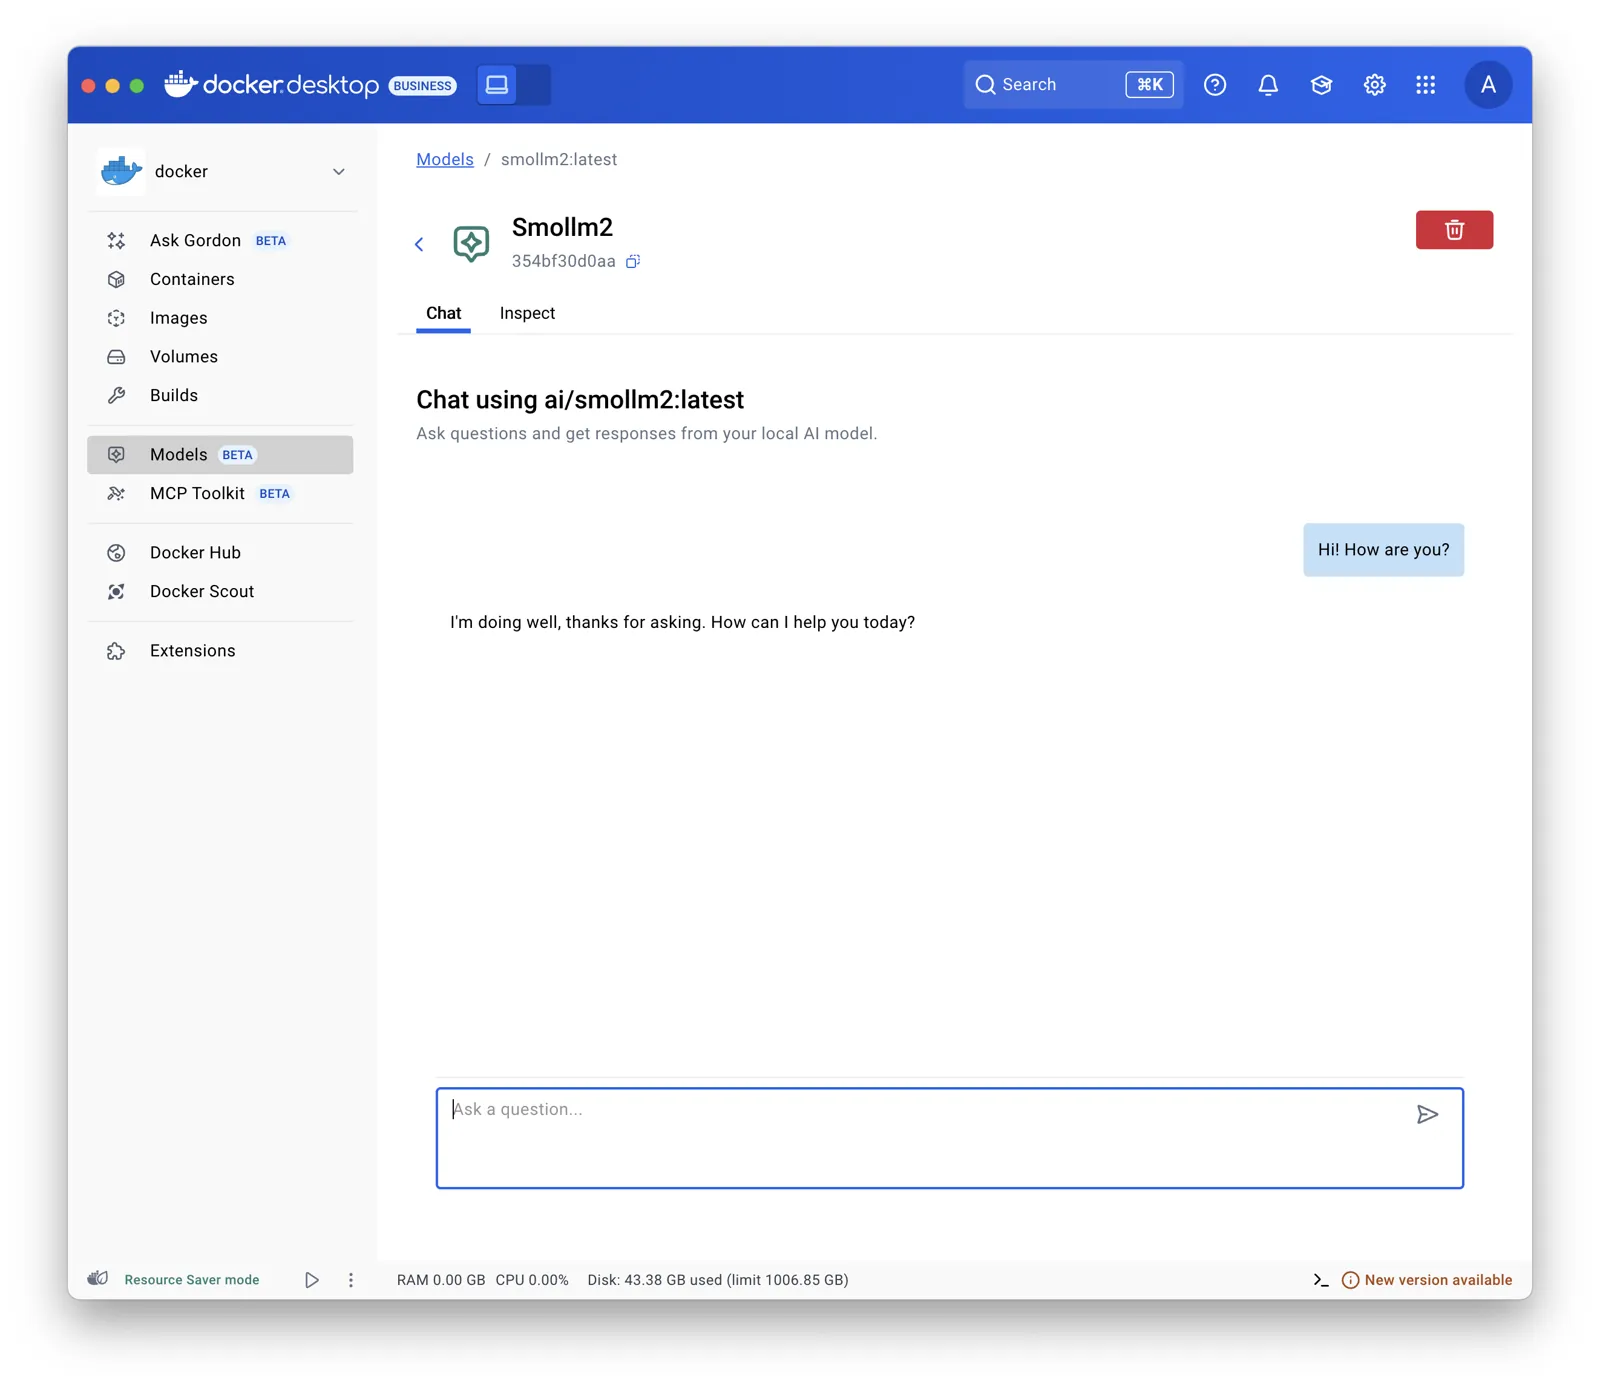
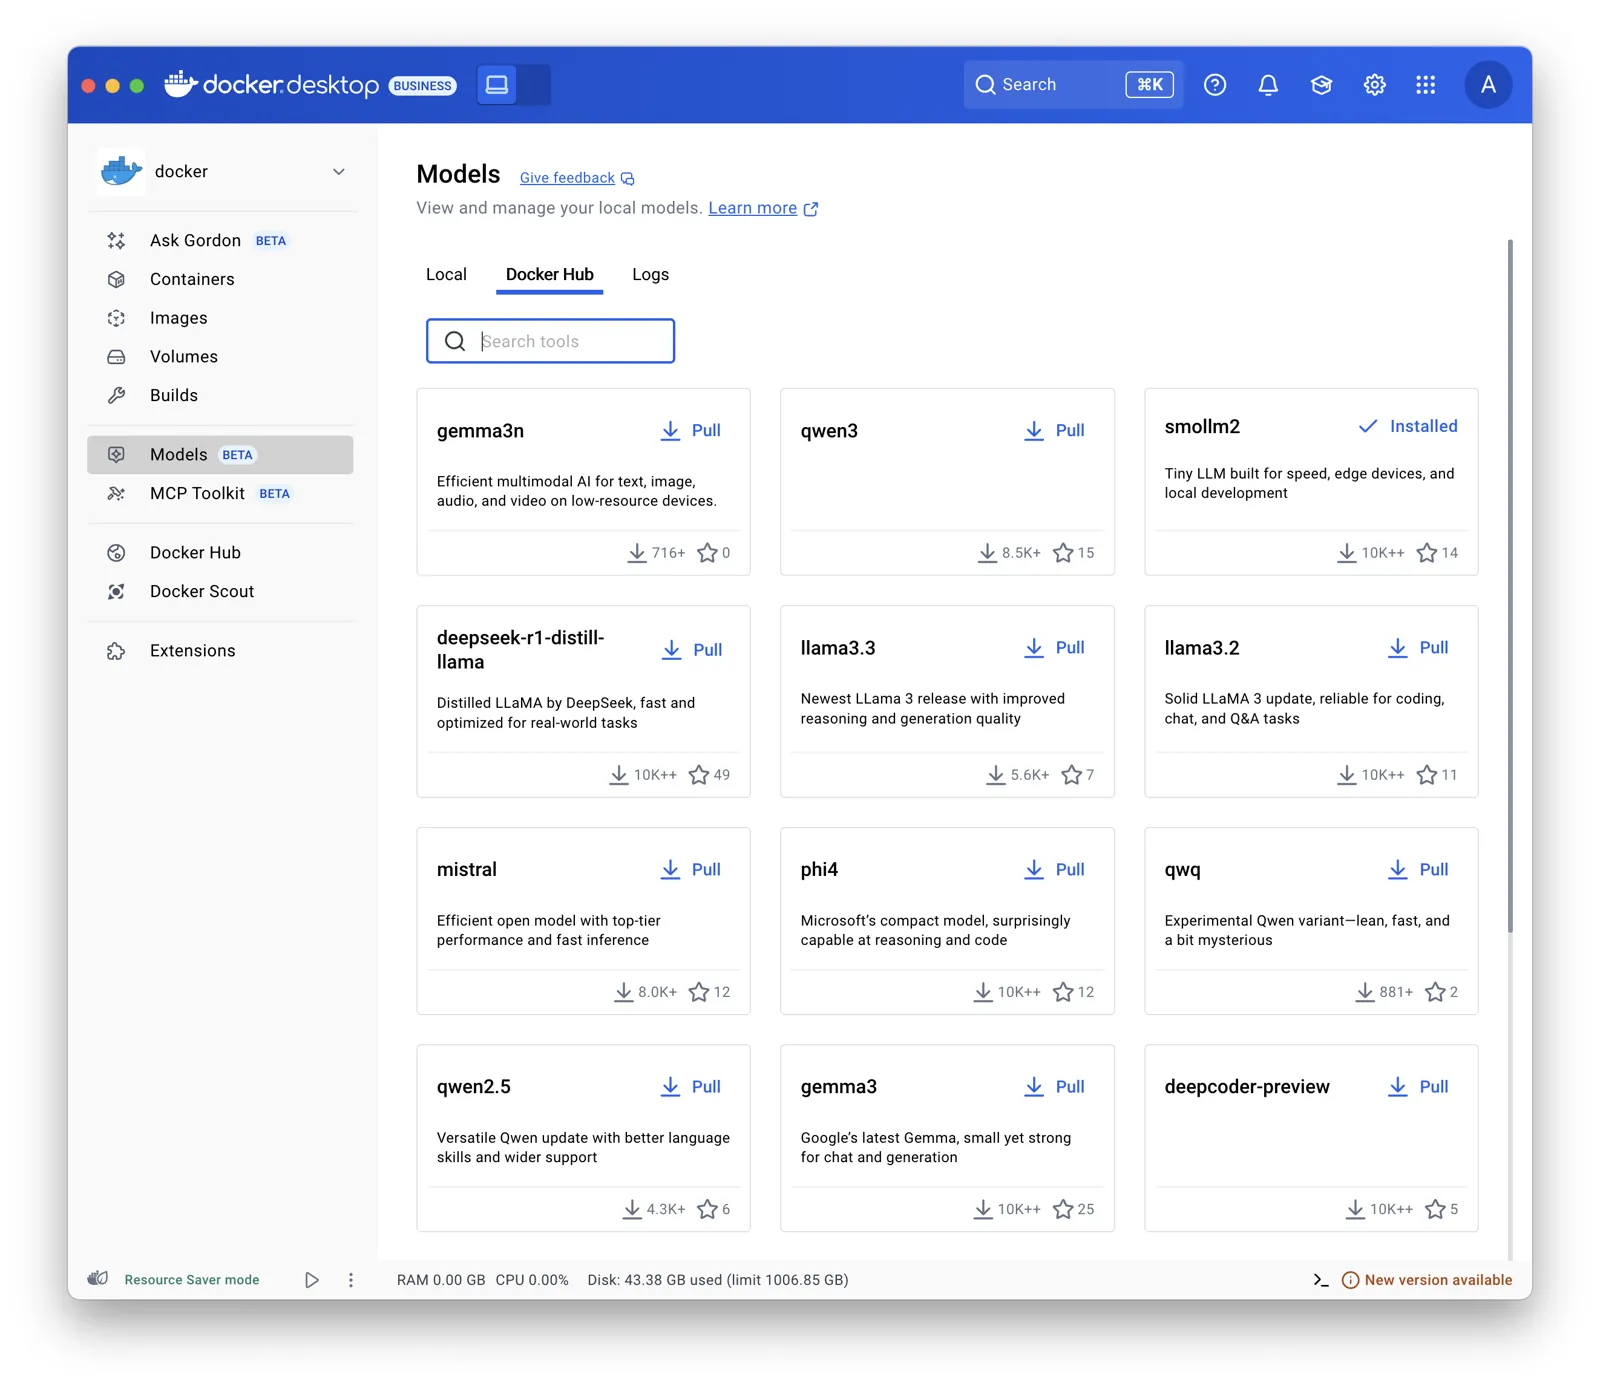
Desktop ajoute aussi une rubrique Models avec le catalogue et un chat pour essayer chaque modèle sans ouvrir de terminal.
Votre premier modèle : docker model run ai/smollm2
docker model run fonctionne de deux façons : avec une question entre guillemets, il répond une fois et vous rend la main ; sans question, il ouvre un chat interactif (on en sort avec /bye, d’après son code). Si le modèle n’est pas là, il le télécharge d’abord. Nous avons choisi ai/smollm2 (361,82 millions de paramètres, quantifié en Q4_K_M) parce qu’il est minuscule et répond en moins d’une seconde avec le seul processeur. En échange, il a son caractère : nous lui avons demandé de compter jusqu’à trois et il a répondu « Three, four, five. ». Petit modèle, grand enthousiasme.
$ docker model list
MODEL NAME  PARAMETERS  QUANTIZATION    ARCHITECTURE  MODEL ID      CREATED        CONTEXT  SIZE
smollm2     361.82 M    IQ2_XXS/Q4_K_M  llama         354bf30d0aa3  20 months ago           256.35 MiB
docker model ps montre ce qui est chargé en mémoire et jusqu’à quand : après chaque utilisation, notre modèle affichait « 4 minutes from now » dans la colonne UNTIL. Nous l’avons laissé tranquille pour voir : 5 minutes après la dernière question, il s’est déchargé tout seul, le processus du moteur a disparu et le conteneur est descendu à 8,7 Mio de mémoire. docker model unload ai/smollm2 le décharge immédiatement sans rien supprimer (« Unloaded 1 model(s). »), et la question suivante, avec le modèle rechargé de zéro, a pris 0,77 seconde. Pour le supprimer du disque : docker model rm ai/smollm2.
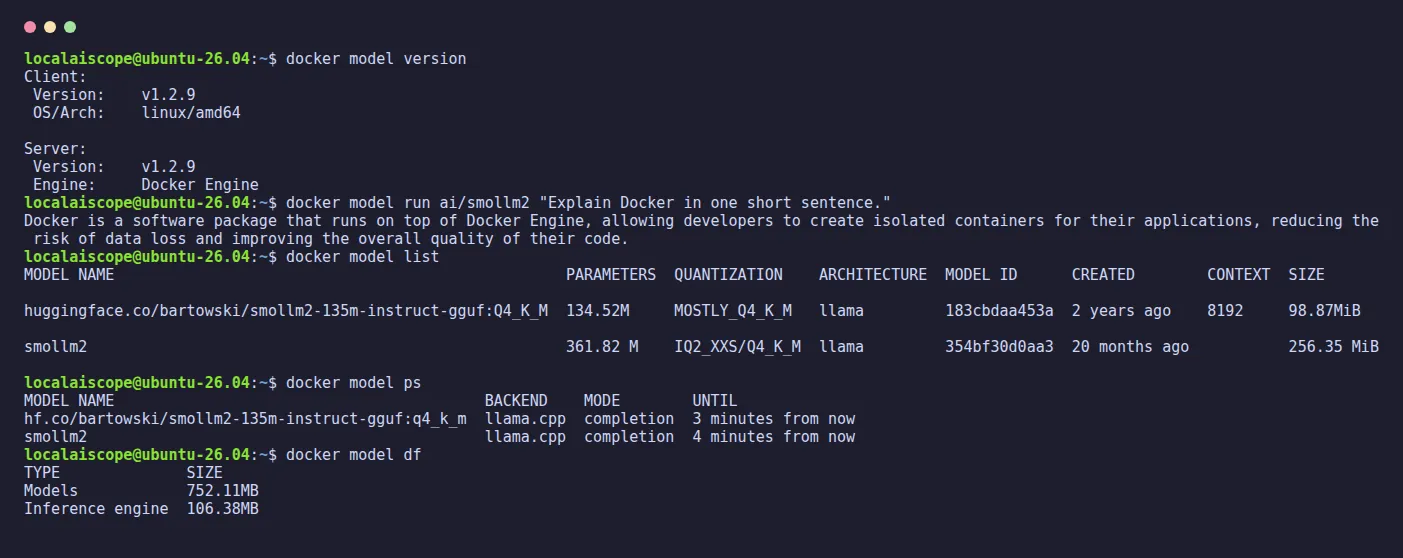
Les modèles de Hugging Face arrivent avec le préfixe hf.co/ et la quantification en guise d’étiquette. docker model pull hf.co/bartowski/SmolLM2-135M-Instruct-GGUF:Q4_K_M a pris 3,26 secondes pour 105,45 Mo, même si le compteur de progression est allé jusqu’à « Downloaded 210.92MB of 105.45MB » : télécharger deux fois le poids d’un fichier, c’est un talent. Dans list, il apparaît ensuite sous le nom huggingface.co/bartowski/smollm2-135m-instruct-gguf:Q4_K_M.
L’API de Docker Model Runner sur le port 12434
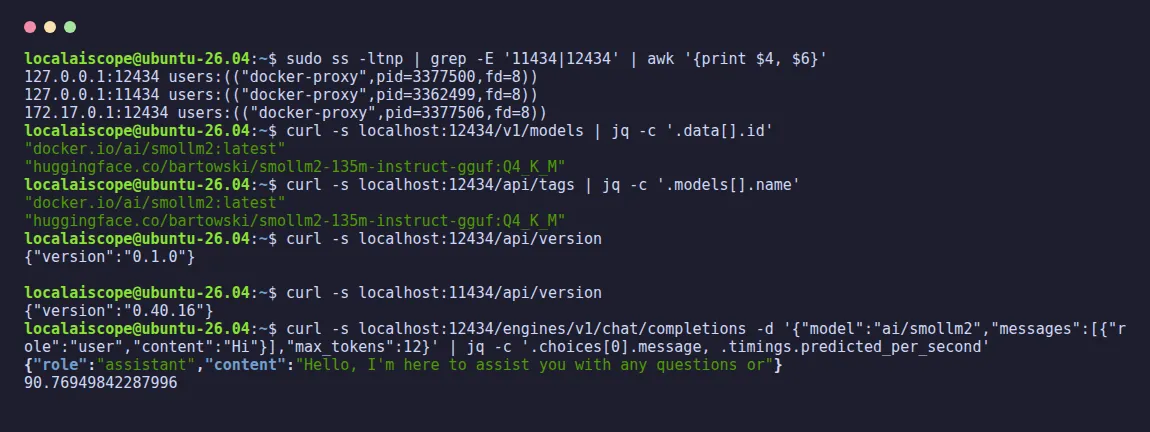
Avec Docker Engine, le runner écoute sur 127.0.0.1:12434 et sur 172.17.0.1:12434 (l’adresse de la machine sur le réseau Docker par défaut). Il n’écoute que sur ces deux adresses : depuis le serveur lui-même, en appelant son adresse sur le réseau local, la connexion a échoué. Selon Docker, l’API n’a pas d’authentification ; si un client vous demande une clé, n’importe quel texte fait l’affaire.
Le même port sert trois familles de chemins, et tous ont répondu 200 dans notre test :
| Chemin | Compatible avec |
Ce que nous avons vérifié |
|---|---|---|
/engines/v1/models, /engines/v1/chat/completions |
OpenAI | Liste des modèles et chat, avec usage et temps |
/v1/models, /v1/chat/completions |
OpenAI (alias) | Même réponse que /engines/v1 |
/api/tags, /api/ps, /api/chat, /api/generate, /api/version |
Ollama | Liste, discute et génère ; version 0.1.0 |
Une première requête avec curl, qui vous donne au passage la vitesse (timings.predicted_per_second) :
curl http://localhost:12434/engines/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"ai/smollm2","messages":[{"role":"user","content":"Bonjour"}]}'
Comme il utilise son propre port, il cohabite avec Ollama sans aucun conflit : nous avions Ollama sur le 11434 et Docker Model Runner sur le 12434 en même temps, chacun répondant avec sa version. Si vous venez d’Ollama, notre guide de l’API d’Ollama utilise les mêmes chemins /api/…, qui ici changent seulement de port.
L’utiliser depuis d’autres conteneurs et avec Open WebUI
Depuis un conteneur sur le réseau Docker par défaut, l’adresse est http://172.17.0.1:12434. Avec Compose, vous pouvez lui donner un nom grâce à extra_hosts: ["model-runner.docker.internal:host-gateway"], le nom qu’utilise Docker Desktop. Sans cette ligne, le nom n’existe pas : wget: bad address 'model-runner.docker.internal:12434'.
Sur notre serveur, en revanche, le premier essai a échoué avec wget: can't connect to remote host (172.17.0.1): Operation timed out. Le coupable était ufw, avec sa règle par défaut qui refuse les connexions entrantes : pour le pare-feu, un conteneur qui parle à la machine, c’est du trafic entrant. Une règle limitée à l’interface de Docker et à ce port a réglé le problème, aussi bien via 172.17.0.1 que via model-runner.docker.internal (avec la ligne host-gateway) :
sudo ufw allow in on docker0 to 172.17.0.1 port 12434 proto tcpD’après l’API que nous avons testée, Open WebUI se connecterait par la couche compatible Ollama avec OLLAMA_BASE_URL=http://172.17.0.1:12434, ou par celle d’OpenAI avec OPENAI_API_BASE_URL=http://172.17.0.1:12434/engines/v1. Cette fois, nous n’avons pas branché Open WebUI sur Docker Model Runner ; le reste du montage (volume, premier utilisateur, port) se trouve dans notre guide Open WebUI avec Ollama.
Ce que Docker Model Runner envoie à Docker Hub (et comment le couper)
C’est le test qui nous intriguait le plus. Nous avons enregistré avec tcpdump le trafic du conteneur du runner sur docker0, le réseau Docker par défaut, où seul ce conteneur était branché sur notre serveur. Avec le modèle déjà sur le disque et les réglages d’origine, chaque utilisation du modèle entraînait une requête vers registry-1.docker.io : dans le test témoin, 3 docker model run et 2 appels à l’API ont donné une requête DNS, une connexion chiffrée avec Docker Hub et 5 requêtes, une par utilisation à en juger par la taille des envois, avec 41 paquets sortis de l’ordinateur au total. Dans le code de la version 1.2.9, cette requête est un HEAD sur le manifeste du modèle, qui sert à compter les modèles utilisés.
Nous avons ensuite réinstallé le runner avec l’option de non-participation :
docker model reinstall-runner --do-not-trackLe conteneur démarre alors avec DO_NOT_TRACK=1 et, avec exactement les mêmes 3 exécutions et 2 appels à l’API, 0 paquet IPv4 n’est sorti de l’ordinateur. Les modèles restent où ils étaient : réinstaller le runner ne touche pas au volume.
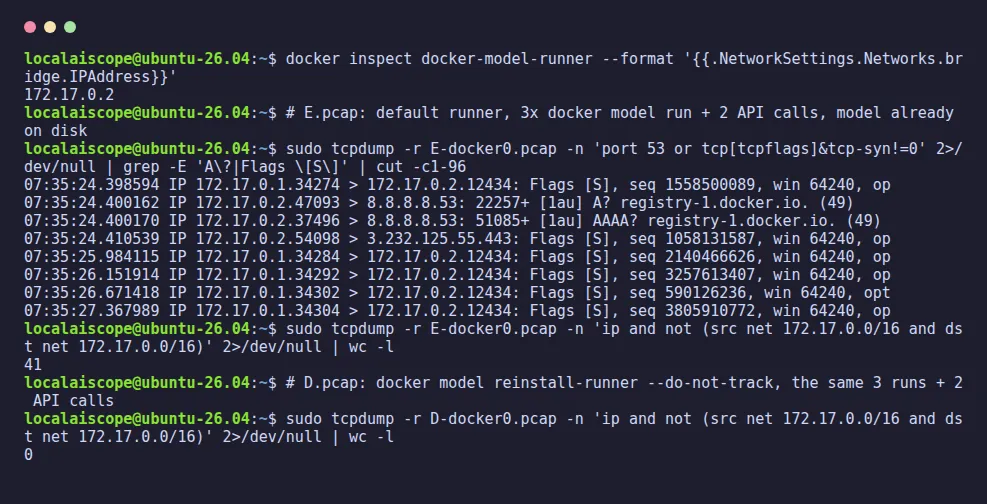
--do-not-track Capture : notre terminal, Docker Model Runner 1.2.9, 17/11/2026Docker Model Runner vs Ollama : notre mesure
Même modèle (SmolLM2 360M quantifié en Q4_K_M), même prompt (une histoire d’environ 200 mots, 256 tokens, température 0), même processeur, les deux lancés en même temps et le même jour. Ollama est en version 0.40.16, dans son image Docker officielle ; en dessous, les deux utilisent llama.cpp. Attention à un détail : l’étiquette smollm2:360m d’Ollama correspond à la version F16 (725 Mo) ; pour comparer à armes égales, nous avons pris smollm2:360m-instruct-q4_K_M, qui pèse autant que celle de Docker. Dans le tableau, DMR désigne Docker Model Runner.
| 17/11/2026 | DMR 1.2.9 |
Ollama 0.40.16 |
|---|---|---|
| Vitesse (tok/s) | 78-82 | 83-89 |
| Modèle sur le disque (Mo) | 270,6 | 270,6 |
| Image sur le disque (Go) | 1,37 | 8,52 |
| Processus moteur, RSS (Mio) | 224 | 484 |
| Conteneur, docker stats (Mio) | 95 | 878 |
| Contexte pendant le test | 8 192 | 4 096 |
| Port | 12434 | 11434 |
Si vous envisagez plutôt Ollama dans un conteneur, notre guide Ollama dans Docker explique le volume et le port ; et pour servir de nombreux utilisateurs avec une carte NVIDIA, le comparatif vLLM vs Ollama est l’étape suivante.
GPU et vLLM : ce que nous avons pu tester, et ce que nous n’avons pas pu
Sous Linux, d’après le code de la version 1.2.9, le runner choisit son image selon le GPU détecté : latest-cuda pour NVIDIA, latest-rocm pour AMD, et l’image CPU s’il n’y en a pas. Vous pouvez forcer le choix avec --gpu cuda et choisir le moteur avec --backend vllm, qui exige CUDA. Sur notre serveur, sans carte NVIDIA, les deux options ont échoué, et mieux vaut le savoir avant d’essayer : --gpu cuda a téléchargé l’image CUDA (5,66 Go sur le disque) et n’a abandonné qu’ensuite, au bout de 52,87 secondes. Nous n’avons pas pu mesurer de vitesses sur GPU ; dès que possible, elles figureront ici avec leur date.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez.
La présentation officielle de Docker, en anglais et d’une minute, publiée en avril 2025 : certains écrans peuvent différer de la version 1.2.9 que nous avons testée.
Erreurs de Docker Model Runner, avec leur message exact
Voici les messages obtenus le 17 novembre 2026 avec la version 1.2.9, et ce que signifie chacun :
| Message | Cause | Que faire |
|---|---|---|
docker: unknown command: docker model |
Le plugin n’est pas installé | sudo apt-get install docker-model-plugin |
pull access denied, repository does not exist or may require authorization (status 500) |
Le nom du modèle n’existe pas | Vérifiez le nom dans le catalogue ai/ |
failed with status 404 Not Found: Model not found |
Le modèle existe, mais pas cette étiquette | Vérifiez l’étiquette (ce qui suit les deux-points) |
Failed to remove model: no such model |
rm d’un modèle que vous n’avez pas |
docker model list pour voir le nom exact |
failed to bind host port 127.0.0.1:12434/tcp: address already in use |
Un autre programme utilise le port 12434 | Libérez-le, ou installez avec --port |
--backend vllm requires CUDA GPU support |
vLLM sans carte NVIDIA | Revenez au moteur par défaut (llama.cpp) |
failed to discover GPU vendor from CDI: no known GPU vendor found |
--gpu cuda sans carte NVIDIA |
Installez sans --gpu |
dial tcp 127.0.0.1:12434: connect: connection refused |
Le CLI cherche le runner sur le 12434 alors qu’il est ailleurs | Pointez MODEL_RUNNER_HOST vers le bon port |
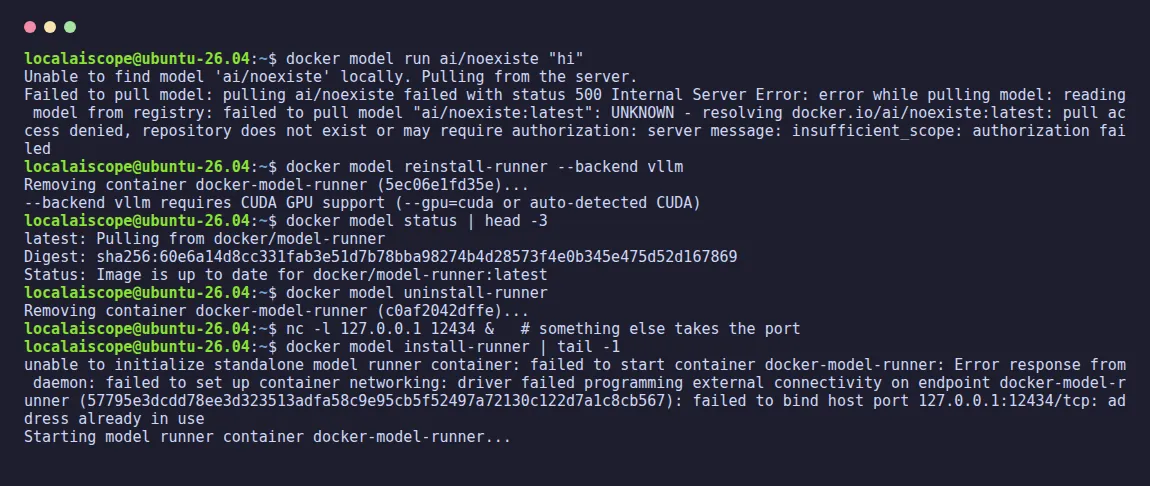
Deux d’entre eux méritent une remarque. docker model reinstall-runner --backend vllm supprime d’abord le conteneur, puis échoue : vous restez sans runner jusqu’à la commande docker model suivante, qui le recrée toute seule avec l’image CPU. Et si vous installez avec --port 12435 parce que le 12434 est pris, la commande affiche « standalone model runner took too long to initialize », mais le runner fonctionne bien sur le 12435 ; celui qui se perd, c’est le CLI, qui continue à chercher le 12434.