En un Mac con Apple Silicon, los dos usan el chip gráfico a través de Metal. Elige llama.cpp si quieres el abanico más amplio: su versión 0.8.0 tiene código para 27 de los 28 modelos de nuestro catálogo, mlx-lm 0.32.2 para 22, y los 28 tienen un GGUF listo. Elige mlx-lm para versiones MLX, scripts en Python y afinar con LoRA.
Esa es la respuesta corta, y nos gusta porque sale de leer código, no de una corazonada. El 30 de octubre de 2026 leímos las versiones estables de los dos proyectos, cruzamos con su código los 27 modelos que tenía ese día nuestro buscador y pusimos lado a lado servidores, valores de fábrica y lo que manda cada uno por su cuenta. No los hemos cronometrado, así que aquí no hay ganador de velocidad; casi al final te contamos cómo resolverlo en tu propio Mac.
 MLX (mlx-lm)Ficha del programa
 llama.cppFicha del programa
| mlx-lm | llama.cpp | |
|---|---|---|
| Versión estable el 30 de octubre de 2026 | 0.32.2 (16 de octubre), que instala mlx 0.32.4 | v0.8.0 (28 de octubre), compilación b11960 |
| Qué es | El paquete de Python de Apple para ejecutar y afinar modelos de lenguaje con MLX | Un motor en C y C++ con línea de órdenes, servidor y página de chat |
| Modelos de nuestro catálogo que conoce su código (27 el 30 de octubre de 2026) | 22 | 27 |
| Formato de fichero | Carpetas MLX (safetensors); no lee GGUF | GGUF; los safetensors, solo tras convertirlos |
| Instalación en un Mac | pip install mlx-lm (Python 3.11 o superior, nativo de ARM) |
brew install llama.cpp o la descarga para macOS ARM64 |
| Servidor local | mlx_lm.server en 127.0.0.1:8080 |
llama-server en 127.0.0.1:9931 |
| Largo de la respuesta si la petición no lo dice | 512 tokens | Sin límite |
| Peticiones a la vez (servidor) | Agrupa las que se pueden agrupar; 1 modelo cargado | 4 huecos de serie |
| Afinado | LoRA con mlx_lm.lora |
Un ejemplo que su propio README llama trabajo en curso |
| Lo que manda por su cuenta | Nada; sale cuando se lo pides (descargas y su comprobación de cambios, imágenes por URL, calibración) | Nada (ni telemetría ni comprobación de actualizaciones); sale cuando se lo pides (descargas, imágenes por URL) |
| Licencia | MIT | MIT |
Dos motores sin ventana
Ninguno de los dos es una aplicación de doble clic. mlx-lm es el paquete de Python que el equipo de MLX de Apple mantiene encima de su framework mlx: lo instalas con pip y le hablas con órdenes como mlx_lm.chat, mlx_lm.generate o mlx_lm.server. llama.cpp es el motor en C y C++ que hay debajo de muchísimos programas de IA local, y en un Mac lo tienes con Homebrew (que sirve la 0.8.0 desde el 28 de octubre) o con la descarga ya compilada para macOS ARM64. Los dos son de código abierto con licencia MIT, y por eso hemos podido leer cada línea que citamos aquí.
Si lo que buscas de verdad es una ventana con su caja de chat, esta no es tu pelea: nuestra comparativa LM Studio vs llama.cpp cubre la aplicación que lleva los dos motores dentro, y MLX vs Ollama, el servidor que también corre modelos MLX. Esta página es para cuando bajas un piso y eliges tú el motor.
Los 27 que revisamos: llama.cpp los conoce todos; mlx-lm, 22
Aquí está la cifra a la que veníamos. Tomamos la arquitectura que declara cada uno de los 27 modelos en su propio config.json de Hugging Face y la buscamos en el código de los dos: el registro de conversión de llama.cpp v0.8.0, resuelto como lo hace su conversor, y la carpeta de modelos de mlx-lm 0.32.2. Resultado (leído en el código, 30 de octubre de 2026): llama.cpp tiene código para 27 de 27; mlx-lm, para 22. Los 22 que conoce mlx-lm también los conoce llama.cpp. En nuestro catálogo no hay ningún modelo que solo corra mlx-lm.
Desde esa lectura, Mistral Large 4 ha entrado en nuestro catálogo como modelo número 28, y es la excepción: su código está en las compilaciones diarias de llama.cpp desde la b11998 (30 de octubre de 2026), no en la v0.8.0, que el 1 de noviembre seguía siendo la última estable (el canal estable lo abre desde la v0.9.0, compilación b12110, publicada el 4 de noviembre de 2026); mlx-lm 0.32.2 no tiene código para él, y la petición de cambios que lo añade (#2018) seguía abierta ese día. Con 591,21 GiB en Q4_K_M no cabe en ningún equipo de nuestro catálogo, tampoco en el Mac Studio de 512 GB.
Dos avisos honestos. Esto es soporte en el código, no 27 modelos ejecutados uno a uno; y el código puede llegar a mlx-lm con su próxima versión, por eso todo lleva fecha. El otro es un punto extra para llama.cpp: en 15 de los 27 revisados, su conversor tiene además una clase para la parte de imagen o audio del modelo, ese fichero aparte que llama proyector.

Ficheros: GGUF a un lado, carpetas MLX al otro
Ninguno lee el formato del otro. mlx-lm ni siquiera pide ficheros .gguf a Hugging Face: descarga carpetas MLX, como las de mlx-community, o convierte él mismo el modelo original con mlx_lm.convert. llama.cpp solo ejecuta GGUF; para usar los safetensors originales primero los conviertes con el script convert_hf_to_gguf.py que trae.
En la práctica, llama.cpp sale con ventaja: nuestro catálogo tiene un repositorio GGUF para cada uno de los 28 modelos, con entre 2 y 27 cuantizaciones listas cada uno (559 en total), así que muchas veces te basta con llama-server -hf y el nombre del repositorio. Para mlx-lm no contamos modelo a modelo las versiones MLX ya hechas; cuando no la hay, convertir es una orden, y la sesión de Apple de aquí abajo lo enseña.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
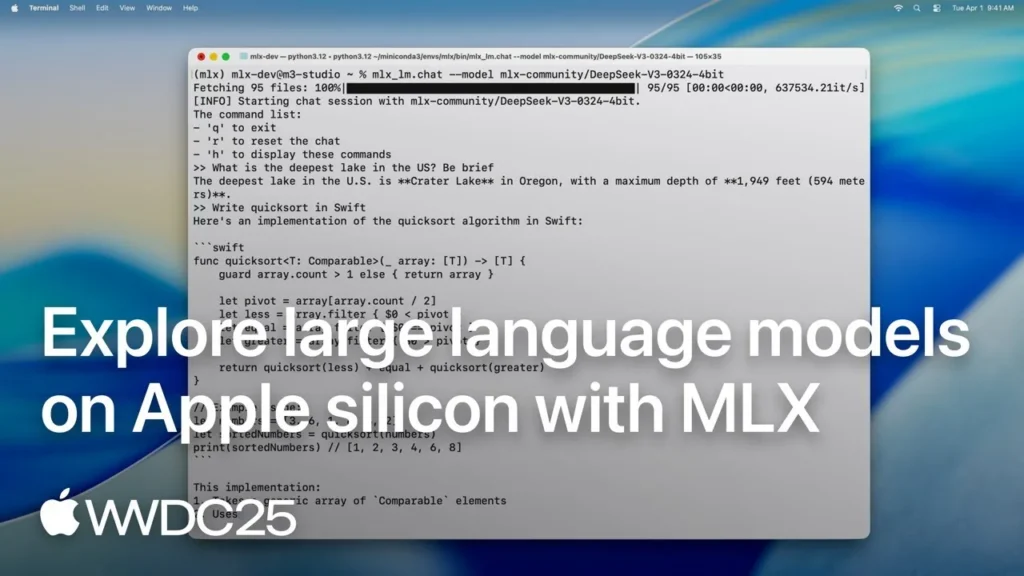
Es la sesión de Apple de la WWDC25 sobre modelos de lenguaje con MLX, en inglés. La hemos visto por sus subtítulos: enseña mlx_lm.generate, cómo convertir y cuantizar un modelo con mlx_lm.convert y cómo entrenar un adaptador LoRA sobre un modelo de 4 bits. Sus modelos son de 2025; las versiones de esta página, de hoy. Si lo que te preocupa es cuánto pesa cada fichero, nuestra comparativa MLX vs GGUF pesa los mismos modelos en los dos formatos.
Cuantización: menos mandos o más ficheros
mlx-lm puede cuantizar mientras convierte: añade -q. De serie, eso es su modo afín a 4 bits en grupos de 64; la opción --q-mode admite también mxfp4, nvfp4 y mxfp8, y trae 4 recetas mixtas ya hechas (mixed_2_6, mixed_3_4, mixed_3_6 y mixed_4_6) que dejan a más bits las partes delicadas. Hay además caminos más finos (DWQ, AWQ, GPTQ), si te apetece una tarde de ese estilo.
llama.cpp va al revés: su conversor escribe el modelo a 16 bits de serie (o a 32, a 8 o ternario), y luego llama-quantize saca los nombres de siempre, como Q4_K_M, Q5_K_M o la familia IQ. La buena noticia es que casi nunca lo haces tú, porque esos ficheros ya están en los repositorios. La pega es elegir: un solo repositorio puede ofrecer hasta 27 cuantizaciones.
Servidores: 8080 frente a 9931, y la sorpresa de los 512 tokens
Los dos te dan un servidor local con rutas al estilo de OpenAI, que solo escucha en tu propio Mac (127.0.0.1) y no pide clave. Los detalles son donde se separan:
- mlx_lm.server escucha en el puerto 8080. Si la petición no dice cuánto puede durar la respuesta, se para a los 512 tokens; temperatura 0 de serie; un modelo cargado cada vez (si pides otro, lo cambia). Acepta llamadas desde cualquier página web (CORS abierto) y avisa en cada arranque de que no es para producción.
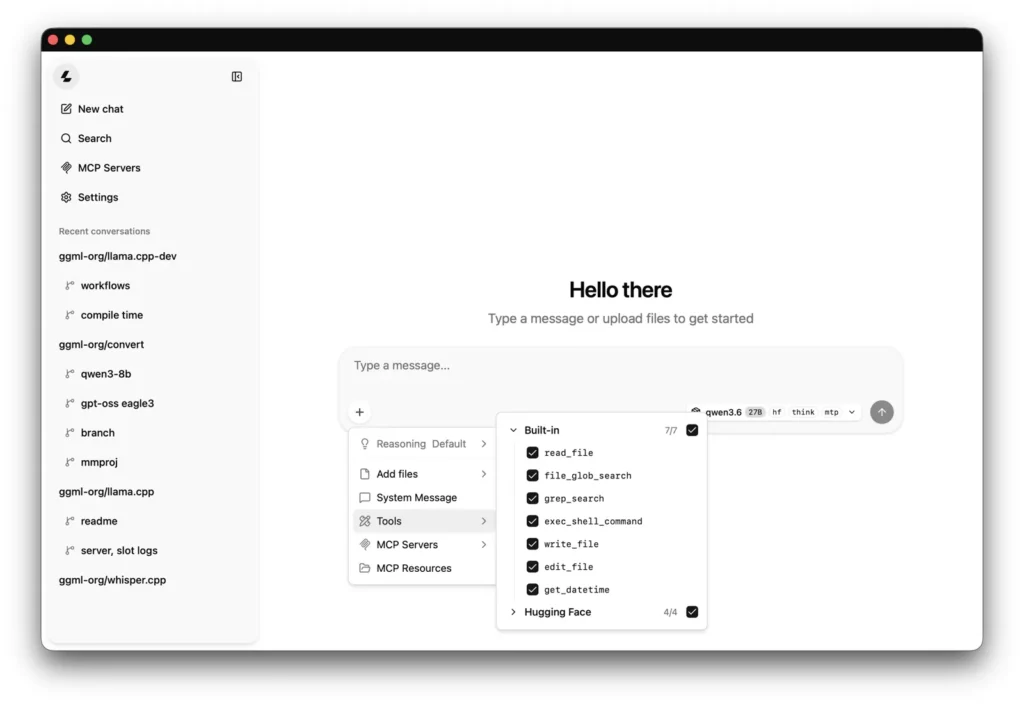
- llama-server escucha en el puerto 9931 desde la v0.7.0 (antes, 8080). De serie no limita la respuesta, toma el contexto con el que se entrenó el modelo y lo recorta si falta memoria (nunca por debajo de 4.096 tokens), y abre 4 huecos para 4 peticiones a la vez. Sirve además su propia página de chat en la misma dirección y, de serie, devuelve el origen de cualquier página web, con un aviso en la consola si no has puesto clave.
Se abre en YouTube (sin cookies) solo si pulsas. Más vídeos en su ficha →
El vídeo explicativo de IBM Technology, en inglés y también visto por sus subtítulos, repasa con calma qué es llama.cpp: GGUF, cuantización, Metal, CUDA y llama-server. Cuando arranca el servidor fija él mismo el puerto 8080, así que su orden funciona tal cual; sin esa opción acabarías en el 9931.
Memoria y Metal en Apple Silicon
En un Mac con Apple Silicon los dos usan el chip gráfico a través de Metal, cada uno con su código, y los dos conviven con la misma regla: el procesador y el chip gráfico comparten una sola memoria, así que el modelo, su contexto y el resto de tus aplicaciones salen del mismo bolsillo. mlx-lm le pregunta a macOS cuánta debería usar el chip gráfico y fija ese límite al cargar. Los dos pueden encoger la caché de la conversación: mlx-lm con --kv-bits y llama.cpp con sus opciones de tipo de caché (16 bits de serie).
En un Mac con Intel la historia es corta. La compilación oficial de llama.cpp para macOS en Intel viene sin Metal, así que trabaja con el procesador, y mlx-lm necesita un Python nativo de ARM. Si tu Mac lleva chip Intel, el que sigue funcionando es llama.cpp.
Lo que manda cada uno por su cuenta
Es la parte que más nos importa en esta web, y los dos se portan bien. llama.cpp no tiene telemetría ni comprobación de actualizaciones; contamos su red el 25 de agosto y releímos el código de la v0.8.0 el 30 de octubre: las 2 salidas nuevas que trae (un túnel entre pares, --connect, y el interruptor «Discover Models» de la página de chat) vienen las dos apagadas. Solo se conecta cuando se lo pides: para descargar un modelo (con -hf y opciones parecidas al arrancar, o con una petición a /models si arrancas llama-server sin modelo) o para traer una imagen, un audio o un vídeo que una petición le pase por su dirección web.
mlx-lm tampoco manda nada propio (re-comprobado en la 0.32.2 el 17 de octubre). Solo sale cuando se lo pides: para descargar modelos, con la librería de Hugging Face, que además mira si el modelo cambió cuando lo cargas por su nombre (HF_HUB_OFFLINE=1 lo corta en cuanto tus modelos están en el disco); para traer una imagen que una petición de chat le pase por su dirección web; y para bajar datos de calibración si cuantizas con AWQ, GPTQ, DWQ o la cuantización dinámica. Cada conexión de mlx-lm, con su fuente, está en su ficha de MLX, y la de llama.cpp trae cómo instalarlo y sus versiones.
Cuál usaríamos, y lo que no sabemos
- Quieres el abanico más amplio de modelos: llama.cpp. Su versión estable cubre los 6 modelos de nuestro catálogo que a mlx-lm aún le faltan; el sexto, Mistral Large 4, desde la v0.9.0 (4 de noviembre de 2026), y con 591,21 GiB en Q4_K_M no cabe en ningún equipo nuestro.
- Vives en Python o quieres afinar: mlx-lm.
mlx_lm.loraentrena adaptadores incluso sobre modelos de 4 bits, y el propio README de entrenamiento de llama.cpp dice que su afinado es «very much WIP», muy en obras. - Tu Mac lleva chip Intel: llama.cpp, con el procesador.
- Tu aplicación necesita varias peticiones a la vez: llama-server arranca con 4 huecos; mlx_lm.server agrupa lo que puede, con un modelo cargado.
Lo que no sabemos: cuál va más rápido en tu Mac con tu modelo. No lo hemos medido, y cambia con el chip, el modelo y la versión. Comprobarlo es rápido: mlx_lm.generate imprime los tokens por segundo de la lectura y de la respuesta, y los dos traen su banco de pruebas: mlx_lm.benchmark y llama-bench. Mismo modelo, mismo tamaño, mismo prompt, y tienes tu propia cifra.
Si estás comparando cualquiera de los dos con Ollama, nuestras comparativas llama.cpp vs Ollama y MLX vs Ollama siguen donde esta se para, y el buscador de modelos te dice cuáles de los 28 caben en la memoria de tu Mac.