Prenez LM Studio si vous voulez une fenêtre : chercher un modèle, le charger et discuter, sans terminal, avec un serveur fermé d’emblée. Prenez llama.cpp si vous voulez un code ouvert, le moteur le plus récent dès sa sortie et rien d’envoyé. Même moteur dessous : LM Studio fait tourner les GGUF sur sa propre compilation de llama.cpp.
Cette dernière phrase est tout le sel de la comparaison, et nous avons vérifié jusqu’où elle va. LM Studio 0.4.26 est la version que distribuait son service de téléchargement le 27 octobre 2026 (compilation 0.4.26-4), et ni la 0.4.27 (29 octobre) ni la 0.4.28 (31 octobre, celle qu’il sert le 5 novembre 2026) ne mentionnent de nouveau moteur llama.cpp dans leurs notes ; llama.cpp v0.9.0 est sa version stable du 4 novembre 2026. Le code de llama.cpp, nous l’avons lu partout où il décide de la mémoire, des requêtes simultanées, du réseau et de votre vie privée. Celui de LM Studio est fermé : pour lui, nous rapportons ce qu’écrit son éditeur, et nous le précisons à chaque fois. Nous ne les avons pas chronométrés, donc pas de vainqueur en vitesse ici : avec le même fichier GGUF sur llama.cpp, la vitesse dépend de la compilation du moteur et des réglages, et c’est justement là que les deux diffèrent.
 LM StudioFiche logiciel
 llama.cppFiche logiciel
| LM Studio | llama.cpp | |
|---|---|---|
| Ce que c’est | Une application de bureau avec recherche de modèles, chat et serveur, bâtie sur des moteurs | Le moteur lui-même, avec un serveur, un chat en terminal et une page de chat |
| Version au 5 novembre 2026 | 0.4.28 (téléchargement 0.4.28-2) | v0.9.0 (compilation b12110, 4 novembre), plus les compilations quotidiennes (b12125 le 5 novembre) |
| llama.cpp à l’intérieur | Runtime 2.50.0, sur b11337 (2 octobre 2026), tel que livré avec la 0.4.26 ; les notes de la 0.4.27 et de la 0.4.28 n’en citent pas de plus récent | C’est llama.cpp : le canal stable ou n’importe quelle compilation quotidienne |
| Code et licence | Fermé ; gratuit à la maison et au travail, sans revente en tant que service. Sa ligne de commande lms, ses SDK et son moteur MLX sont sous MIT |
Open source, MIT |
| Fonctionne sur | Windows x64 (avec AVX2) et ARM64, macOS 14+ sur Apple Silicon, Linux x64 et ARM64. Pas de Mac Intel | Windows, macOS, Linux et Android ; compilations CPU, CUDA, ROCm, Vulkan, Metal, SYCL et OpenVINO. Mac Intel sur le processeur |
| Fichiers de modèle | GGUF et MLX ; vous choisissez dans sa recherche | GGUF ; safetensors seulement après conversion |
| Requêtes simultanées, par défaut | 4 (Max Concurrent Predictions ; moteurs llama.cpp et MLX) | 4, qui partagent une même réserve de mémoire de contexte |
| Contexte par défaut | Non publié ; vous le fixez au chargement | Le maximum du modèle, réduit à ce qui tient (jamais moins de 4 096 tokens) |
| Modèle inactif | Ceux chargés à la demande par l’API sont déchargés au bout de 60 minutes ; ceux chargés avec lms load restent |
Reste chargé jusqu’à l’arrêt du serveur |
| Fenêtre | Application de bureau complète ; llmster sans fenêtre |
Une page de chat dans le navigateur, activée par défaut |
| Écoute sur | 127.0.0.1:1234 |
127.0.0.1:9931 (8080 jusqu’à la v0.6.0) |
| Clé et CORS | Clé facultative avec permissions (Require Authentication) ; CORS désactivé | Clé facultative (--api-key) ; CORS ouvert à n’importe quelle page web |
| Ce qu’il envoie seul | 2 choses, selon son éditeur : vérification des mises à jour et mise à jour des moteurs (seule cette dernière se désactive). Invérifiable | Rien |
Le même moteur : quel llama.cpp se cache dans LM Studio 0.4.26
LM Studio n’écrit pas son propre moteur pour les fichiers GGUF. Il emballe llama.cpp dans ce qu’il appelle un runtime, avec sa propre numérotation, et son journal des modifications indique sur quel llama.cpp chacun repose. La 0.4.26, disponible depuis le 8 octobre 2026, a apporté le runtime 2.50.0, bâti sur la compilation b11337 de llama.cpp, une quotidienne du 2 octobre 2026. Sur les Mac Apple Silicon, il existe un deuxième moteur, MLX, que LM Studio développe en open source sous licence MIT ; et depuis la 0.4.25, un troisième, Splash, pour les puces M3 ou plus récentes sous macOS 26.4 ou ultérieur, ce qui relève de la parole de l’éditeur, puisque l’application est fermée.

Et voici le détail amusant. Le 5 novembre 2026, le llama.cpp stable, la v0.9.0, correspond à la compilation b12110, du 4 novembre : 773 compilations plus loin que celle de LM Studio 0.4.26 (avec la v0.8.0, la version stable jusqu’au 4 novembre, l’écart était de 623). Et le numéro de compilation de llama.cpp grimpe d’environ 21 par jour, dont environ 13 publiées comme compilations quotidiennes (du 28 octobre au 5 novembre 2026) ; le 5 novembre, la dernière est la b12125. Le jour où une nouvelle famille de modèles arrive dans llama.cpp, l’utiliser directement est donc le moyen le plus rapide de l’essayer. LM Studio suit, mais à son rythme.
Un point honnête en faveur de LM Studio : ses moteurs se mettent à jour tout seuls, option activée d’origine et désactivable dans les réglages de l’application. Le llama.cpp de votre LM Studio peut donc être plus récent que le 2.50.0 ; l’application indique quel runtime vous avez. Cette vidéo montre comment mettre à jour LM Studio et ses moteurs llama.cpp sous Windows ; elle a été tournée avec une autre version, donc en cas de différence, fiez-vous à cette page.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez.
Une fenêtre ou un terminal : l’installation et la première réponse
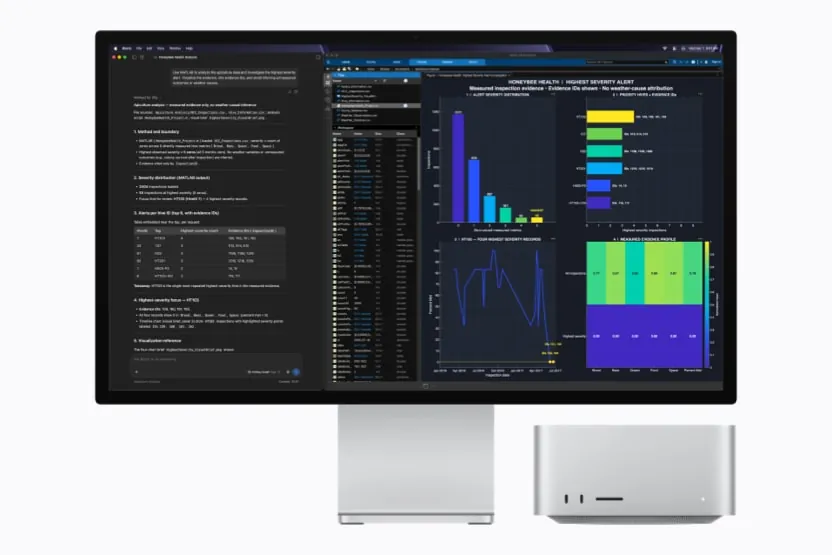
LM Studio s’installe comme n’importe quel logiciel : un .dmg sur Mac, un .exe sous Windows, un AppImage ou un .deb sous Linux. Ensuite, 3 étapes dans l’application, et aucune dans un terminal : chercher et télécharger un modèle dans l’onglet Discover, le charger, puis discuter. Si vous le voulez sans fenêtre, sur un serveur ou un mini-PC, il propose llmster, un démon sans interface piloté par sa ligne de commande lms.
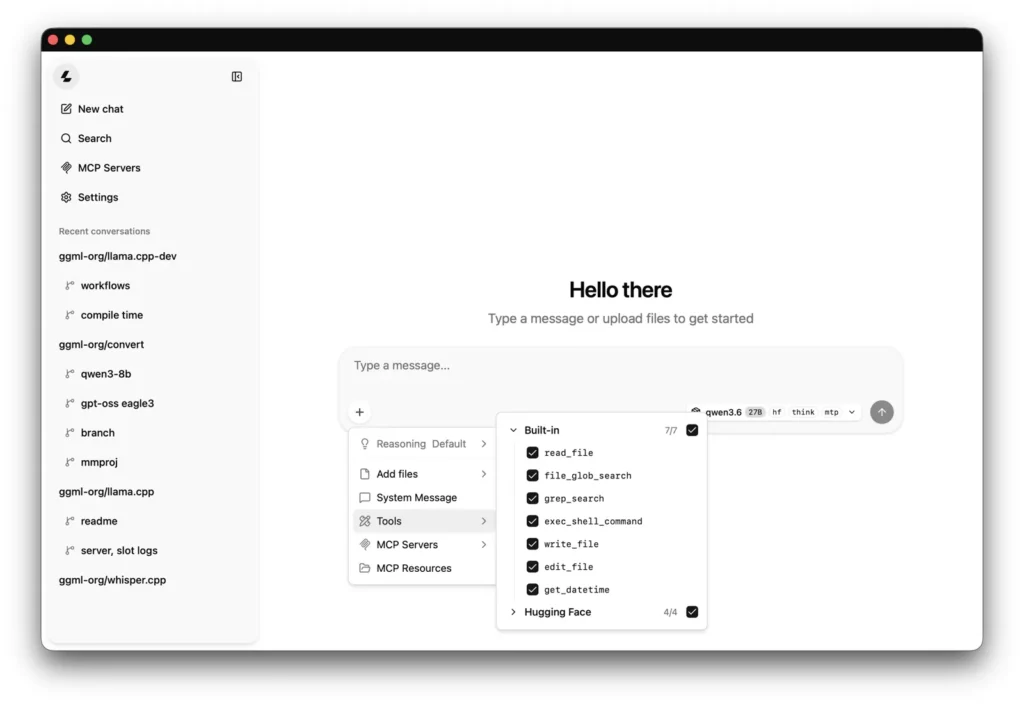
llama.cpp vous demande d’abord un choix : quelle compilation. La voie tranquille est brew install llama.cpp, qui donne sur Mac et Linux la v0.9.0 stable (Homebrew la sert depuis le 5 novembre 2026). La page des versions sur GitHub publie des compilations par système et par carte graphique, et vous prenez celle qui correspond à la vôtre. Puis 1 commande :
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF -c 8192Elle télécharge le modèle depuis Hugging Face et ouvre le serveur et une page de chat sur http://127.0.0.1:9931. Cette page est la réponse de llama.cpp à la fenêtre de LM Studio : vos conversations et, depuis la v0.7.0, un gestionnaire de modèles, le tout dans le navigateur. Les conversations sont conservées dans le stockage du navigateur : effacer les données du site les supprime. LM Studio, lui, les garde en fichiers JSON dans ~/.lmstudio/conversations/.
Notre guide d’installation de LM Studio et notre guide pour llama.cpp détaillent chaque étape. Côté matériel, la liste la plus longue est celle de llama.cpp : il tourne même sur un Mac Intel, sur le processeur seul, et sur les téléphones Android. LM Studio n’a aucune version pour Mac Intel et, sous Windows x64, exige un processeur avec AVX2.
Quel fichier vous faites tourner, et qui le choisit
Les deux lisent le GGUF, le format créé par llama.cpp. La différence, c’est la façon dont le fichier arrive chez vous.
La recherche de LM Studio affiche GGUF et MLX côte à côte, et c’est vous qui choisissez ; sur un Mac Apple Silicon, vous pouvez avoir les deux. Ses modèles vont dans ~/.lmstudio/models/, et lms import ajoute un GGUF téléchargé ailleurs. llama.cpp ne lit que le GGUF : un modèle en safetensors doit d’abord être converti avec le script convert_hf_to_gguf.py. Avec -hf, il va le chercher sur Hugging Face, choisit la compression Q4_K_M si vous n’en indiquez pas d’autre, et range le fichier dans le cache standard de Hugging Face.
Sur Mac, le choix du format est une question à part entière, et notre comparatif MLX vs GGUF mesure 7 modèles dans les deux. Et si vous préférez vous passer de l’application pour choisir le moteur, notre comparatif MLX vs llama.cpp met mlx-lm et llama.cpp côte à côte.
4 requêtes simultanées des deux côtés, et le contexte
Ici, ils s’accordent plus qu’on ne le croirait. Lancez llama serve et il ouvre 4 emplacements : dans le code de la v0.9.0, comme dans celui de la v0.8.0, le nombre d’emplacements vaut auto par défaut, et auto signifie 4, avec une seule réserve de mémoire de contexte partagée par tous. Lancé avec -c 8192, il vous donne 8 192 tokens pour les 4 ensemble. -np fixe un autre nombre.
La documentation de LM Studio donne le même chiffre : Max Concurrent Predictions vaut 4 par défaut, donc jusqu’à 4 requêtes sont traitées ensemble au lieu d’attendre dans une file. Le réglage se trouve dans les paramètres avancés du chargeur de modèles et fonctionne avec son moteur llama.cpp et, depuis la 0.4.2 (février 2026), avec son moteur MLX ; la 0.4.13 (mai 2026) l’a étendu aux modèles MLX qui lisent les images. La façon dont il répartit la mémoire entre ces 4 n’est pas publiée, et le code fermé ne nous permet pas de la lire.
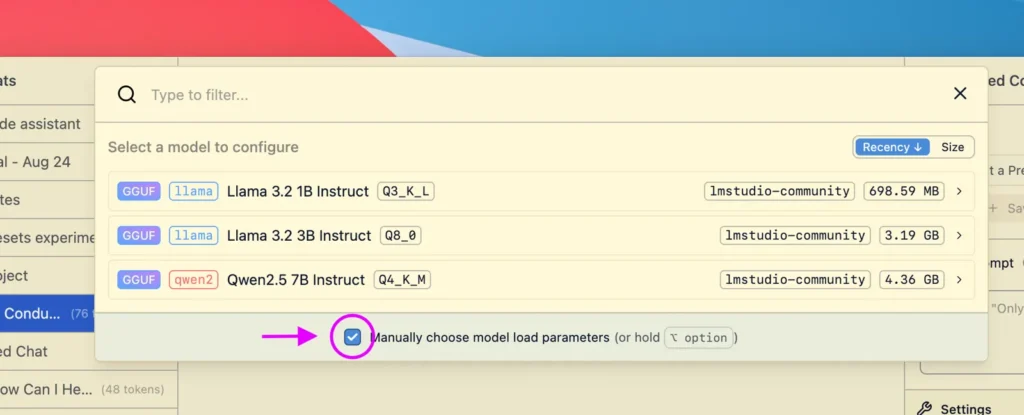
C’est sur le contexte qu’ils se séparent. llama.cpp part du haut : par défaut, sa taille de contexte est la plus longue avec laquelle le modèle a été entraîné, et un mécanisme appelé --fit, actif par défaut, la réduit jusqu’à un plancher de 4 096 tokens et déplace des couches vers la mémoire système jusqu’à ce que le modèle tienne, en visant 1 024 Mio libres sur chaque appareil. LM Studio ne publie pas sa valeur par défaut ; vous voyez le chiffre, et le modifiez, dans le chargeur ou avec lms load --context-length. Notre conseil vaut pour les deux : écrivez vous-même le chiffre, et vous saurez ce que vous avez.
La mémoire après la réponse diffère aussi. llama-server garde le modèle chargé jusqu’à ce que vous l’arrêtiez ; --sleep-idle-seconds le met en veille après un délai. Dans LM Studio, les modèles chargés à la demande par l’API sont déchargés au bout de 60 minutes sans requête, et en charger un nouveau de cette façon éjecte le précédent.
Quelles portes sont ouvertes : 127.0.0.1:1234 contre 127.0.0.1:9931
La bonne nouvelle d’abord : les deux n’écoutent que sur votre propre machine dès l’installation. LM Studio attend sur 127.0.0.1:1234 ; llama.cpp v0.9.0 sur 127.0.0.1:9931 (c’était 8080 jusqu’à la v0.6.0, et les images Docker du projet utilisent toujours 8080 dans le conteneur). Personne sur votre wifi ne les atteint tant que vous ne les ouvrez pas exprès : Serve on Local Network ou lms server start --bind 0.0.0.0 pour LM Studio, --host 0.0.0.0 pour llama.cpp. Ils cohabitent sans souci : ports différents, aucun conflit.
La différence tient au CORS, qui décide quelles pages web peuvent utiliser un serveur local depuis votre navigateur, et là, ils partent d’extrémités opposées. LM Studio laisse le CORS désactivé tant que vous n’activez pas Enable CORS ou ne lancez pas le serveur avec --cors. llama.cpp, par défaut, renvoie n’importe quelle origine et autorise les identifiants : une page web que vous visitez peut donc envoyer des requêtes à votre llama-server et lire les réponses pendant qu’il tourne ; le serveur le signale au démarrage avec security: no API key is set and CORS allows all origins.
Les deux peuvent exiger une clé. LM Studio propose Require Authentication depuis la 0.4.0, avec des jetons dotés de permissions ; c’est désactivé par défaut. llama.cpp offre --api-key, la variable LLAMA_API_KEY et --api-key-file pour en lire plusieurs. Un piège côté llama.cpp : la clé ne change pas le CORS. Le réglage qui le ferme, c’est --cors-origins localhost.

Ce que chacun envoie, et ce que vous pouvez vérifier
Ici, llama.cpp l’emporte haut la main, et vous n’avez pas à nous croire sur parole : le code est public. Nous avons cherché analytique, télémétrie et pistage dans son moteur, son serveur, son chat en terminal et sa page de chat, sans rien trouver. La v0.8.0 a apporté 2 nouvelles sorties, que la v0.9.0 garde telles quelles, toutes deux désactivées tant que vous ne les activez pas : --connect, expérimental, qui ouvre un tunnel pair à pair vers votre serveur via un programme à part, llama-connect ; et l’option Discover Models de la page de chat qui, une fois cochée dans les réglages, interroge Hugging Face depuis votre navigateur, ainsi que le catalogue de modèles du projet sur llama.app (son aide la réserve au mode routeur, quand le serveur démarre sans modèle fixe). llama.cpp ne vérifie pas les mises à jour et n’a pas de compte. Il ne sort sur internet que quand vous le demandez : téléchargement de modèles avec -hf, llama download ou --model-url, modèles empaquetés en images de conteneur avec --docker-repo, et llama update sur les installations faites avec le script du projet. Une fois les modèles sur le disque, --offline lui interdit tout téléchargement.
LM Studio affirme ne pas avoir de télémétrie et, selon ses propres dires, 2 choses partent d’elles-mêmes : l’application vérifie les mises à jour (sa politique de confidentialité indique qu’elle reçoit la version et la compilation de l’application, le système d’exploitation et l’adresse IP), et les moteurs se mettent à jour seuls, option activée d’origine et désactivable dans les réglages. La recherche dans Discover contacte Hugging Face, mais seulement quand vous l’utilisez ; le Hub, la recherche web et les fonctions cloud exigent un compte. Est-ce tout ? Impossible de vous le dire : le code est fermé et ses conditions interdisent la rétro-ingénierie, si bien que personne hors de l’entreprise ne peut le vérifier. C’est le prix de la fenêtre.
La licence suit la même logique. llama.cpp est sous MIT : vous pouvez le lire, le modifier et l’intégrer à votre propre produit. LM Studio est gratuit à la maison et au travail selon ses conditions, qui interdisent de le revendre en tant que service. Chaque destination, avec sa source et sa date, figure sur notre fiche LM Studio et notre fiche llama.cpp.
Lequel nous installerions, selon votre profil
- Première fois avec l’IA locale, et pas de terminal : LM Studio. Chercher, charger, discuter, et un serveur fermé d’emblée.
- Un Mac Apple Silicon : LM Studio, qui fait aussi tourner les modèles MLX ; llama.cpp ne lit que le GGUF.
- Un modèle sorti cette semaine : une compilation quotidienne de llama.cpp, qui reçoit les nouvelles familles avant le runtime de LM Studio.
- Rien ne doit quitter la machine, et vous voulez le vérifier : llama.cpp avec
--offline. Seul un code ouvert permet de le contrôler. - Un produit ou un service bâti dessus : llama.cpp, sous MIT ; les conditions de LM Studio interdisent de le revendre en tant que service.
- Un Mac Intel ou un téléphone Android : llama.cpp, le seul des 2 qui y tourne.
- Les deux : aucun problème. Ports différents, 1234 et 9931, et le même GGUF sert aux deux.
Si quelque chose coince en route, nous avons un guide pour quand LM Studio ne fonctionne pas et un autre pour quand llama.cpp ne fonctionne pas. Vous hésitez aussi avec Ollama ? Nos comparatifs LM Studio vs Ollama et llama.cpp vs Ollama répondent à la question, et le trouveur de modèle vous dit quels modèles tiennent sur votre machine.