Die Umgebungsvariablen von Ollama gehören zum Server, nicht in Ihr Terminal: ein systemd-Override unter Linux (Environment=), launchctl setenv auf dem Mac, Benutzervariablen unter Windows und -e bei Docker. Ob der Server sie wirklich übernommen hat, zeigt die Zeile server config, die ollama serve beim Start ausgibt.
Wir haben Ollama 0.40.16, am 19. November 2026 die neueste stabile Version, gleich doppelt gestartet: das offizielle Linux-Binary aus dem Release-Archiv (am 19. November) und das offizielle Docker-Image ollama/ollama:0.40.16 (am 18.), ohne geladenes Modell, auf einem Server ohne GPU. Jeder Standardwert in diesem Ratgeber stammt aus der Startzeile des Servers selbst, und wir haben ihm absichtlich ein paar unsinnige Werte vorgesetzt, um zu sehen, was er daraus macht. Manche Antwort hat uns überrascht.
 OllamaProgramm-Datenblatt
Alle 26 OLLAMA_-Variablen und ihre Standardwerte in v0.40.16
Beim Start schreibt ollama serve v0.40.16 eine Zeile server config mit 40 Variablen und dem Wert, den es gerade verwendet; 26 davon beginnen mit OLLAMA_ (die übrigen 14 betreffen Proxy, GPU und llama.cpp). Hier die Tabelle mit dem Standardwert, den wir ohne gesetzte Variablen gemessen haben:
| Variable | Standard (gemessen, v0.40.16, 18./19.11.2026) | Wofür |
|---|---|---|
OLLAMA_HOST |
http://127.0.0.1:11434 (Docker-Image: 0.0.0.0:11434) |
Adresse und Port, auf denen der Server lauscht |
OLLAMA_ORIGINS |
17 lokale Origins (localhost, 127.0.0.1, 0.0.0.0, app://, file://, tauri://, vscode-webview://, vscode-file://) |
Webseiten, die die API aus dem Browser aufrufen dürfen (CORS) |
OLLAMA_KEEP_ALIVE |
5m0s |
Wie lange ein Modell nach der letzten Anfrage im Speicher bleibt |
OLLAMA_MODELS |
$HOME/.ollama/models (Docker: /root/.ollama/models) |
Ordner, in dem die Modelle liegen |
OLLAMA_CONTEXT_LENGTH |
0 (automatisch: 4096 auf unserem Rechner ohne GPU) |
Standardkontext, wenn die Anfrage keinen anderen verlangt |
OLLAMA_NUM_PARALLEL |
1 |
Anfragen, die jedes Modell gleichzeitig bearbeitet |
OLLAMA_MAX_LOADED_MODELS |
0 (automatisch) |
Gleichzeitig geladene Modelle |
OLLAMA_MAX_QUEUE |
512 |
Anfragen in der Warteschlange, bevor der Server ablehnt |
OLLAMA_FLASH_ATTENTION |
false |
Erzwingt Flash Attention (1) oder sperrt sie (0) |
OLLAMA_KV_CACHE_TYPE |
leer (f16) |
Quantisierung des Kontext-Caches: q8_0 oder q4_0 |
OLLAMA_LOAD_TIMEOUT |
5m0s |
Wie lange ein hängender Ladevorgang dauern darf, bevor abgebrochen wird |
OLLAMA_GPU_OVERHEAD |
0 |
Reservierter Grafikspeicher pro GPU, in Byte |
OLLAMA_SCHED_SPREAD |
false |
Verteilt das Modell immer auf alle GPUs |
OLLAMA_IGPU_ENABLE |
leer | Aktiviert integrierte GPUs |
OLLAMA_VULKAN |
true |
Vulkan-Backend |
OLLAMA_LLM_LIBRARY |
leer | Erzwingt eine Bibliothek und überspringt die Erkennung |
OLLAMA_DEBUG |
INFO |
Log-Level (1 = DEBUG) |
OLLAMA_DEBUG_LOG_REQUESTS |
false |
Speichert die Anfragen in einem temporären Ordner |
OLLAMA_NO_CLOUD |
false |
Schaltet die Cloud-Funktionen von ollama.com ab |
OLLAMA_REMOTES |
[ollama.com] |
Erlaubte Server für entfernte Modelle |
OLLAMA_CREATE_REMOTE |
false |
Schickt create auch bei lokalem Server über die API |
OLLAMA_MAX_TRANSFER_STREAMS |
4 |
Parallele Streams beim Laden oder Hochladen von safetensors-Modellen |
OLLAMA_NOPRUNE |
false |
Räumt ungenutzte Blobs beim Start nicht auf |
OLLAMA_NOHISTORY |
false |
Speichert den Verlauf von ollama run nicht |
OLLAMA_GO_TEMPLATE |
true |
Nutzt das TEMPLATE aus dem Modelfile, wenn vorhanden |
OLLAMA_EDITOR |
leer | Editor, um den Prompt mit Strg+G zu schreiben |
Die Beschreibungen stammen aus dem Code von v0.40.16 selbst, in verständliche Worte gebracht. ollama serve --help zeigt nur 19 der 26 (plus 2 von llama.cpp), die Startzeile ist also die vollständige Referenz.
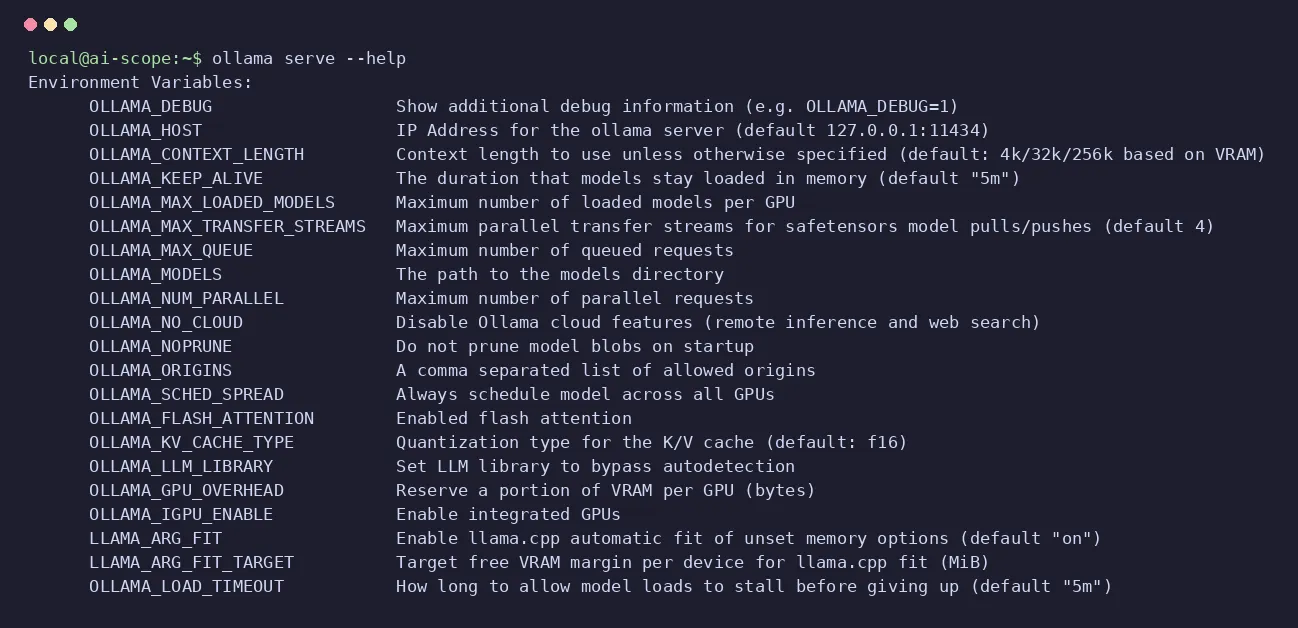
ollama serve --help zeigt: 19 OLLAMA_-Variablen von den 26, die der Server tatsächlich liest Screenshot: unser Terminal, Ollama 0.40.16, 19.11.2026Ollama-Umgebungsvariablen setzen unter Linux, macOS, Windows und Docker
Die Variable muss den Prozess erreichen, der ollama serve ausführt. Ein export in Ihrer Shell gilt nur für das, was Sie aus dieser Shell starten; der als Dienst oder App installierte Server bekommt davon nichts mit. Je nach System, laut der Dokumentation von v0.40.16:
- Linux (systemd-Dienst):
sudo systemctl edit ollama.service, pro Variable eine ZeileEnvironmentunter[Service], danachsystemctl daemon-reloadundsystemctl restart ollama. - macOS (App):
launchctl setenv OLLAMA_HOST "0.0.0.0:11434"für jede Variable, dann Ollama beenden und neu öffnen. - Windows: Ollama über die Taskleiste beenden, „Umgebungsvariablen für dieses Konto bearbeiten“ öffnen, die Variable anlegen und Ollama neu starten.
- Docker:
-e OLLAMA_KEEP_ALIVE=30mbeidocker runoder ein Blockenvironment:in Compose.
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_KEEP_ALIVE=30m"
Wenn Sie den Server von Hand starten, genügt es, die Variable davorzusetzen: OLLAMA_KEEP_ALIVE=30m ollama serve, im selben Format haben wir das Binary am 19. November gestartet. In Docker haben wir am 18. November mit v0.40.16 vier Variablen auf einmal per -e übergeben, und die Startzeile zeigte alle vier: 30m0s, 8192, 2 und den neuen Port 11500. Container haben ihre eigenen Tücken (Volumes, GPU, Ports), die unser Ratgeber Ollama in Docker erklärt.
Wird erst beim Abspielen über YouTube (ohne Cookies) geladen.
Sechs Minuten darüber, warum diese Variablen wichtig sind und wie man sie auf Mac, Linux und Windows setzt, veröffentlicht im September 2024 mit einer älteren Ollama-Version: Für die Standardwerte gilt unsere Tabelle, gemessen mit v0.40.16.
Welche Variablen Ollama gelesen hat: die Zeile server config
Eine einzige Zeile räumt alle Zweifel aus. In v0.40.16 schreibt routes.go:2474 sie bei jedem Serverstart mit Level INFO, und sie enthält jede Variable mit dem Wert, den der Server verwenden wird, ob von Ihnen gesetzt oder ab Werk:
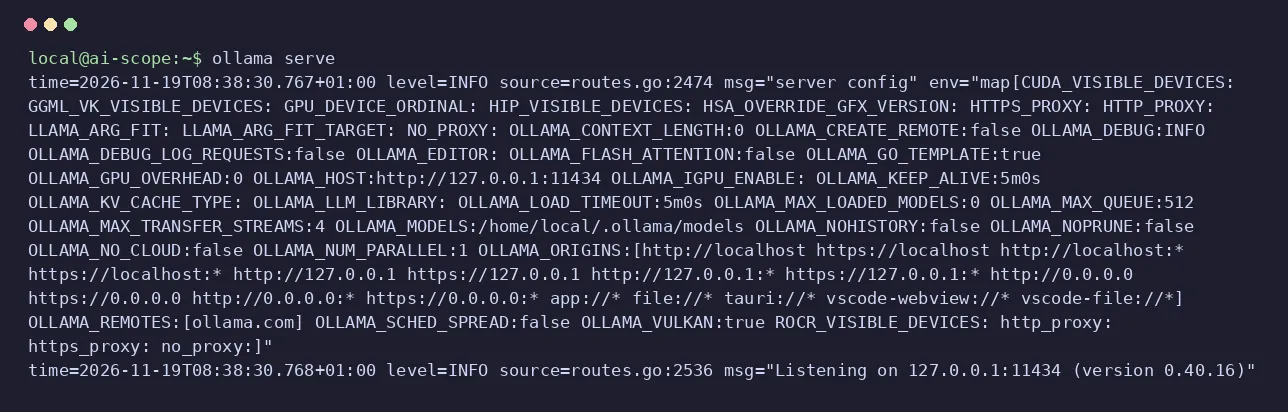
Wo Sie sie finden, hängt davon ab, wie Ollama läuft. Beim Linux-Dienst mit journalctl -u ollama --no-pager | grep "server config", in Docker mit docker logs <Container> 2>&1 | grep "server config", und von Hand ist sie das Erste, was ollama serve ausgibt. Steht Ihre Variable dort mit dem gewünschten Wert, hat der Server sie; steht dort der Werkswert, ist sie nie angekommen (der Klassiker: in der Shell gesetzt, aber der Dienst ist ein anderer Prozess). In derselben Zeile prüfen Sie auch Dinge wie OLLAMA_KEEP_ALIVE:30m0s: Der Server schreibt Zeitangaben in dieser ausgeschriebenen Form.
OLLAMA_HOST: standardmäßig 127.0.0.1, in Docker 0.0.0.0
Am 19. November 2026 lauschte das offizielle Linux-Binary von v0.40.16 ohne Variablen auf 127.0.0.1:11434: Nur der eigene Rechner erreicht es. Wir haben es von außen geprüft: Auf 127.0.0.1 kam {"version":"0.40.16"} zurück, über die Netzwerk-IP des Rechners schlug die Verbindung fehl. Mit OLLAMA_HOST=0.0.0.0 (ohne Port) wechselte der Server auf [::]:11434, also alle Schnittstellen, und behielt Port 11434.
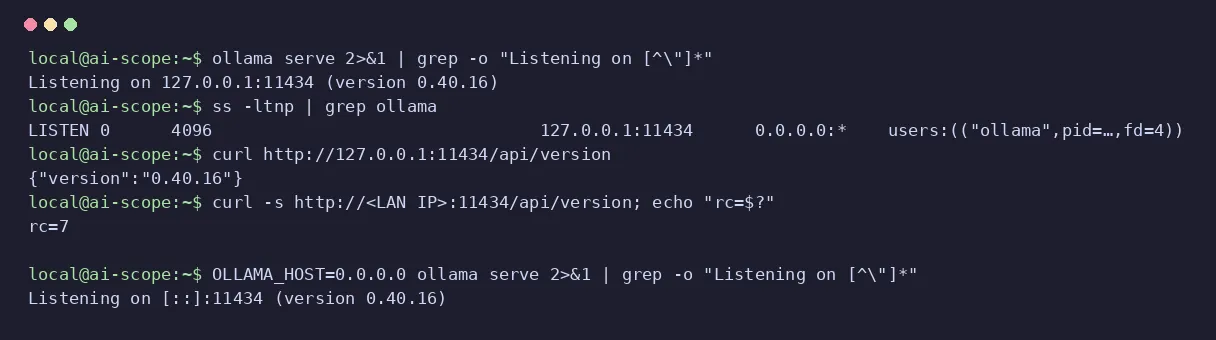
Das offizielle Docker-Image macht es umgekehrt: Es bringt OLLAMA_HOST=0.0.0.0:11434 schon mit, im Container lauscht der Server also auf allen Schnittstellen (gesehen am 18. November mit ollama/ollama:0.40.16), und von außerhalb des Containers erreichen Sie ihn über den mit -p veröffentlichten Port. Ollama im Netz zu öffnen ist praktisch für Laptop oder Smartphone, heißt aber auch: Jeder in diesem Netz kann es erreichen.
OLLAMA_ORIGINS ist die andere Hälfte. Sie regelt nicht, wer sich verbindet, sondern welche Webseiten Ihr Browser mit der API sprechen lässt. Mit OLLAMA_ORIGINS=https://mi-app.example setzte v0.40.16 unseren Origin an den Anfang und behielt die 17 Standard-Origins: Die Variable ergänzt, sie ersetzt nicht. Details mit Beispielen stehen in unserem Ratgeber zur Ollama-API.
OLLAMA_KEEP_ALIVE: 5 Minuten, 0, 30 oder -1 (für immer)
OLLAMA_KEEP_ALIVE legt fest, wie lange ein Modell nach seiner letzten Anfrage geladen bleibt. Der Standard in v0.40.16 ist 5m0s, gemessen am 19. November 2026, und genau diesen Countdown zeigt ollama ps in der Spalte UNTIL. Wir haben mit dieser Version vier Werte ausprobiert:
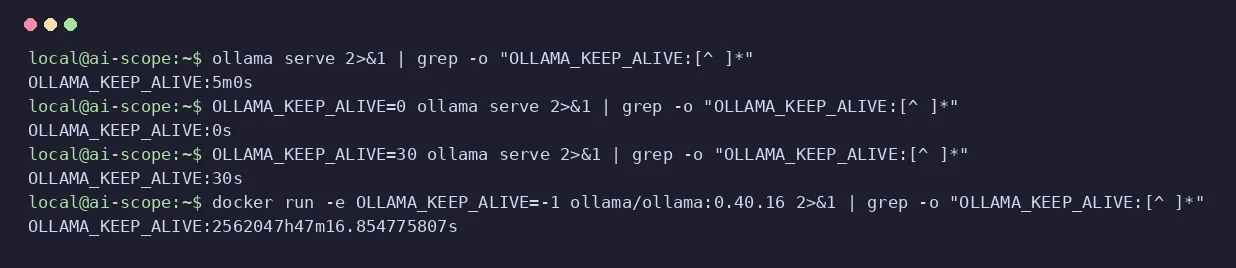
0→0s: Das Modell wird entladen, sobald es geantwortet hat. Das spart Speicher, dafür muss die nächste Anfrage es neu laden.30→30s: Eine Zahl ohne Einheit sind Sekunden, keine Minuten. Für eine halbe Stunde schreiben Sie30m.-1→2562047h47m16.854775807s: Jeder negative Wert bedeutet „nie entladen“.
Die Variable setzt den Standard für den ganzen Server. Jede Anfrage kann ihn mit einem eigenen Feld keep_alive in /api/generate oder /api/chat überschreiben, das laut der Dokumentation von v0.40.16 Vorrang hat; und ollama stop entlädt ein Modell sofort, wie unser Ratgeber zu den Ollama-Befehlen zeigt.
OLLAMA_NUM_PARALLEL, OLLAMA_MAX_LOADED_MODELS und OLLAMA_MAX_QUEUE
Diese drei bestimmen, wie viel Ollama gleichzeitig erledigt, und alle kosten Speicher. In v0.40.16, gemessen am 19. November 2026, lauten die Standardwerte 1, 0 und 512:
OLLAMA_NUM_PARALLEL(1): Anfragen, die jedes Modell gleichzeitig bedient. Laut der Dokumentation von v0.40.16 wächst der Speicherbedarf mitNUM_PARALLEL× Kontext: 4 parallele Anfragen mit 8192 Token Kontext reservieren Cache für 32.768 Token.OLLAMA_MAX_LOADED_MODELS(0 = automatisch): Die Dokumentation setzt die automatische Grenze bei 3 Modellen pro GPU, bzw. 3 im CPU-Betrieb, sofern sie in den Speicher passen.OLLAMA_MAX_QUEUE(512): wartende Anfragen; darüber hinaus antwortet der Server mit einem Fehler 503.
Für eine einzelne Person, die zu Hause chattet, passen die Werkseinstellungen. Erhöhen Sie NUM_PARALLEL, wenn sich mehrere Tools oder Personen einen Server teilen, und rechnen Sie vorher den Kontext durch.
OLLAMA_FLASH_ATTENTION und OLLAMA_KV_CACHE_TYPE: weniger Speicher bei langem Kontext
OLLAMA_KV_CACHE_TYPE quantisiert den Kontext-Cache: q8_0 braucht laut der Dokumentation von v0.40.16 etwa die Hälfte des Speichers von f16, dem Standard, und q4_0 etwa ein Viertel; diese Ersparnis gilt laut derselben Dokumentation, wenn Flash Attention aktiv ist. Am 19. November 2026 erschien OLLAMA_KV_CACHE_TYPE=q8_0 unverändert in der Startzeile. Was jeder Kontext Modell für Modell kostet, steht in unserem Ratgeber zur Kontextlänge in Ollama.
OLLAMA_FLASH_ATTENTION zeigt standardmäßig false, was „nicht erzwungen“ heißt: Laut Dokumentation nutzt v0.40.16 Flash Attention bereits, wenn Backend und Gerät sie unterstützen; mit der Variable erzwingen Sie sie (1) oder sperren sie (0). Und hier kommt die Falle, auf die wir gestoßen sind:
„invalid environment variable, using default“: ein ungültiger Wert
Das ist die Warnung, die v0.40.16 ausgibt, wenn eine Variable, die eine ganze Zahl erwartet, etwas anderes bekommt. Am 18. November 2026 startete der Server mit OLLAMA_NUM_PARALLEL=abc trotzdem und schrieb ins Log:
time=2026-11-18T15:53:14.078Z level=WARN source=config.go:265 msg="invalid environment variable, using default" key=OLLAMA_NUM_PARALLEL value=abc default=1Am 19. November kam mit OLLAMA_MAX_LOADED_MODELS=dos dieselbe Meldung mit default=0. Die Zeile sagt alles: welche Variable (key), was Sie geschrieben haben (value) und was stattdessen gilt (default). Sie erscheint bei den Variablen, die eine ganze Zahl erwarten: NUM_PARALLEL, MAX_LOADED_MODELS, MAX_QUEUE, CONTEXT_LENGTH, MAX_TRANSFER_STREAMS und GPU_OVERHEAD. Nach demselben Code würde ein 16k in OLLAMA_CONTEXT_LENGTH auf 0 zurückfallen, also automatisch: Schreiben Sie 16384.
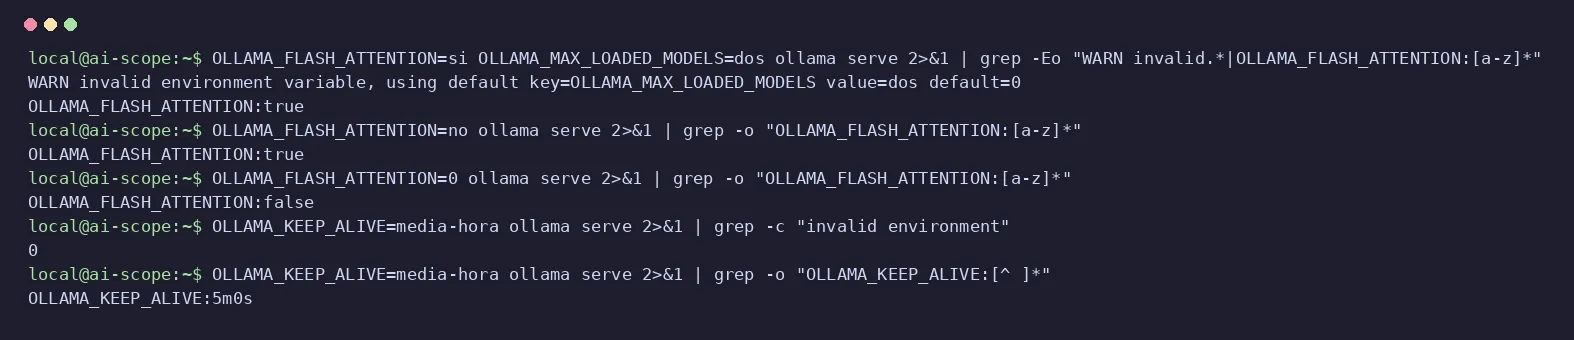
Bedenklich sind die Fälle ohne Warnung. OLLAMA_KEEP_ALIVE=media-hora (spanisch für „halbe Stunde“, und Spanisch spricht Ollama nicht) startete ohne einen einzigen Hinweis und blieb bei 5m0s; die Schalter lesen jeden Unsinn als true. Deshalb ist die Zeile server config mehr wert als jede Warnung: Suchen Sie nach jeder Änderung dort Ihre Variable. Und wenn der Server gar nicht erst startet, macht unsere Liste der Ollama-Fehler mit ihrem genauen Wortlaut dort weiter.