Les variables d’environnement d’Ollama se règlent côté serveur, pas dans votre terminal : un override systemd sous Linux (Environment=), launchctl setenv sur macOS, des variables utilisateur sous Windows et -e avec Docker. Pour vérifier ce qu’il a vraiment pris en compte, lisez la ligne server config qu’affiche ollama serve au démarrage.
Nous avons démarré Ollama 0.40.16, la dernière version stable au 19 novembre 2026, de deux façons : le binaire Linux officiel tiré de l’archive de la version (le 19 novembre) et l’image Docker officielle ollama/ollama:0.40.16 (le 18), sans aucun modèle chargé, sur un serveur sans GPU. Chaque valeur par défaut de ce guide vient de la ligne de démarrage du serveur lui-même, et nous lui avons donné exprès quelques valeurs absurdes pour voir ce qu’il en faisait. Certaines réponses nous ont surpris.
 OllamaFiche logiciel
Les 26 variables OLLAMA_ et leur valeur par défaut dans la v0.40.16
Au démarrage, ollama serve v0.40.16 écrit une ligne server config avec 40 variables et la valeur qu’il utilise ; 26 commencent par OLLAMA_ (les 14 autres concernent le proxy, les GPU et llama.cpp). Voici le tableau, avec la valeur par défaut que nous avons mesurée sans rien définir :
| Variable | Par défaut (mesuré, v0.40.16, 18/19-11-2026) | À quoi elle sert |
|---|---|---|
OLLAMA_HOST |
http://127.0.0.1:11434 (image Docker : 0.0.0.0:11434) |
Adresse et port d’écoute du serveur |
OLLAMA_ORIGINS |
17 origines locales (localhost, 127.0.0.1, 0.0.0.0, app://, file://, tauri://, vscode-webview://, vscode-file://) |
Pages web autorisées à appeler l’API depuis le navigateur (CORS) |
OLLAMA_KEEP_ALIVE |
5m0s |
Durée pendant laquelle un modèle reste en mémoire après la dernière requête |
OLLAMA_MODELS |
$HOME/.ollama/models (Docker : /root/.ollama/models) |
Dossier où sont stockés les modèles |
OLLAMA_CONTEXT_LENGTH |
0 (automatique : 4096 sur notre machine sans GPU) |
Contexte par défaut si la requête n’en demande pas d’autre |
OLLAMA_NUM_PARALLEL |
1 |
Requêtes traitées en même temps par chaque modèle |
OLLAMA_MAX_LOADED_MODELS |
0 (automatique) |
Modèles chargés en même temps |
OLLAMA_MAX_QUEUE |
512 |
Requêtes en file d’attente avant de commencer à refuser |
OLLAMA_FLASH_ATTENTION |
false |
Force la flash attention (1) ou la bloque (0) |
OLLAMA_KV_CACHE_TYPE |
vide (f16) |
Quantification du cache de contexte : q8_0 ou q4_0 |
OLLAMA_LOAD_TIMEOUT |
5m0s |
Temps qu’un chargement bloqué peut durer avant abandon |
OLLAMA_GPU_OVERHEAD |
0 |
Mémoire graphique réservée par GPU, en octets |
OLLAMA_SCHED_SPREAD |
false |
Répartit toujours le modèle sur tous les GPU |
OLLAMA_IGPU_ENABLE |
vide | Active les GPU intégrés |
OLLAMA_VULKAN |
true |
Moteur Vulkan |
OLLAMA_LLM_LIBRARY |
vide | Impose une bibliothèque et saute la détection automatique |
OLLAMA_DEBUG |
INFO |
Niveau de journal (1 = DEBUG) |
OLLAMA_DEBUG_LOG_REQUESTS |
false |
Enregistre le corps des requêtes dans un dossier temporaire |
OLLAMA_NO_CLOUD |
false |
Coupe les fonctions cloud d’ollama.com |
OLLAMA_REMOTES |
[ollama.com] |
Serveurs autorisés pour les modèles distants |
OLLAMA_CREATE_REMOTE |
false |
Oblige create à passer par l’API même avec un serveur local |
OLLAMA_MAX_TRANSFER_STREAMS |
4 |
Flux parallèles pour télécharger ou envoyer des modèles safetensors |
OLLAMA_NOPRUNE |
false |
Ne nettoie pas les blobs inutilisés au démarrage |
OLLAMA_NOHISTORY |
false |
Ne garde pas l’historique d’ollama run |
OLLAMA_GO_TEMPLATE |
true |
Utilise le TEMPLATE du Modelfile quand il existe |
OLLAMA_EDITOR |
vide | Éditeur pour écrire le prompt avec Ctrl+G |
Les descriptions sont celles que la v0.40.16 porte dans son propre code, remises en langage clair. ollama serve --help n’en affiche que 19 sur 26 (plus 2 de llama.cpp) : la ligne de démarrage est donc la référence complète.
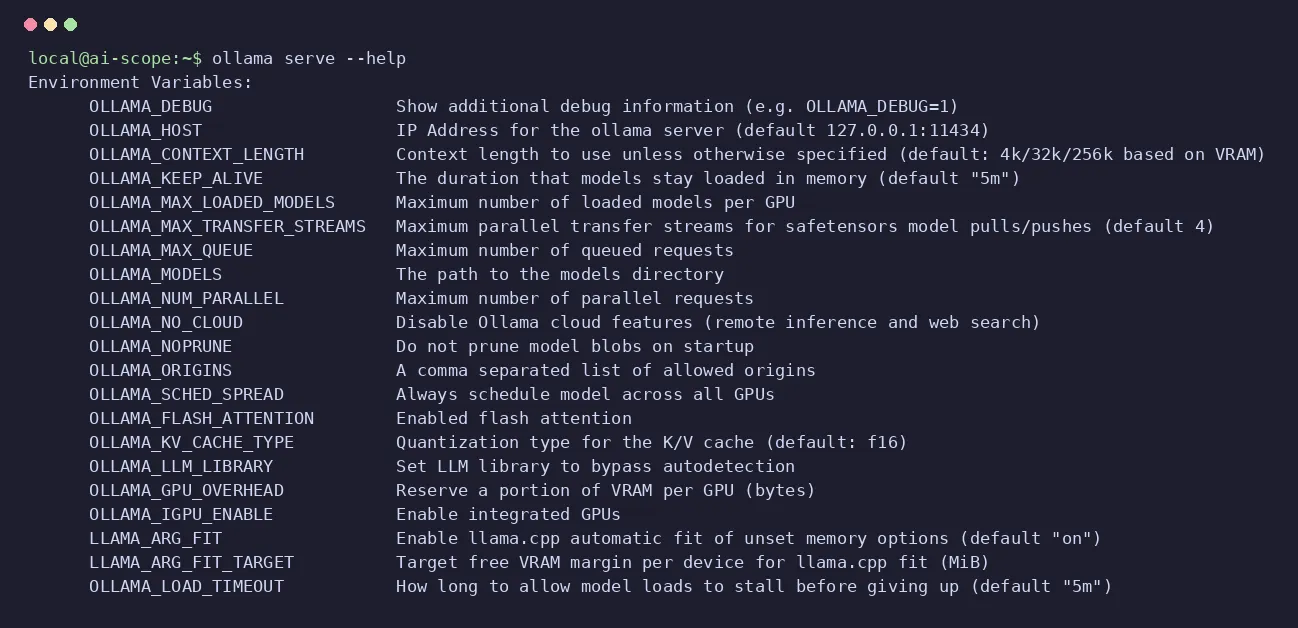
ollama serve --help : 19 OLLAMA_ sur les 26 que le serveur lit vraiment Capture : notre terminal, Ollama 0.40.16, 19-11-2026Définir les variables d’environnement d’Ollama sous Linux, macOS, Windows et Docker
La variable doit atteindre le processus qui exécute ollama serve. Un export dans votre shell ne touche que ce que vous lancez depuis ce shell ; le serveur installé comme service ou comme application ne le voit jamais. Système par système, d’après la documentation de la v0.40.16 :
- Linux (service systemd) :
sudo systemctl edit ollama.service, une ligneEnvironmentpar variable sous[Service], puissystemctl daemon-reloadetsystemctl restart ollama. - macOS (application) :
launchctl setenv OLLAMA_HOST "0.0.0.0:11434"pour chaque variable, puis quittez et relancez Ollama. - Windows : quittez Ollama depuis la barre des tâches, ouvrez « Modifier les variables d’environnement pour votre compte », ajoutez la variable et relancez Ollama.
- Docker :
-e OLLAMA_KEEP_ALIVE=30mdansdocker run, ou un blocenvironment:dans Compose.
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_KEEP_ALIVE=30m"
Si vous démarrez le serveur à la main, il suffit de la placer devant : OLLAMA_KEEP_ALIVE=30m ollama serve, le même format que celui utilisé avec le binaire le 19 novembre. Dans Docker, le 18 novembre avec la v0.40.16, nous en avons passé quatre d’un coup avec -e et la ligne de démarrage les a toutes affichées : 30m0s, 8192, 2 et le nouveau port, 11500. Les conteneurs ont leurs subtilités (volumes, GPU, ports) : notre guide Ollama dans Docker les détaille.
S’ouvre sur YouTube (sans cookies) seulement quand vous appuyez sur lecture.
Six minutes sur l’utilité de ces variables et la façon de les définir sur Mac, Linux et Windows, publiées en septembre 2024 avec une version plus ancienne d’Ollama : pour les valeurs par défaut, fiez-vous à notre tableau, mesuré sur la v0.40.16.
Voir quelles variables Ollama a lues : la ligne server config
Une seule ligne lève tous les doutes. Dans la v0.40.16, routes.go:2474 l’écrit au niveau INFO à chaque démarrage du serveur, avec toutes les variables et la valeur qu’il va utiliser, qu’elle vienne de vous ou du réglage d’origine :
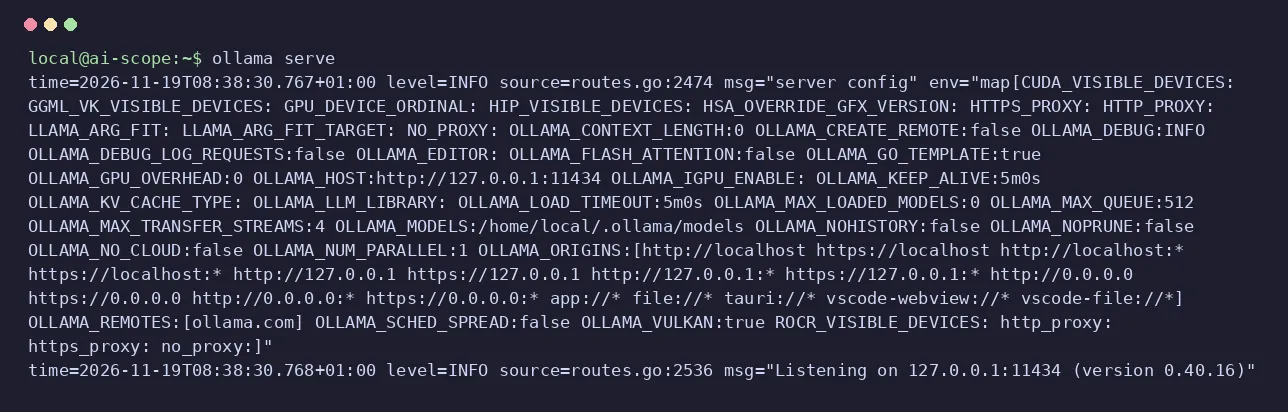
Où la trouver dépend de la façon dont tourne Ollama. Avec le service Linux, journalctl -u ollama --no-pager | grep "server config" ; avec Docker, docker logs <conteneur> 2>&1 | grep "server config" ; et à la main, c’est la première chose qu’affiche ollama serve. Si votre variable y figure avec la valeur voulue, le serveur l’a bien reçue ; si c’est la valeur d’origine, elle ne lui est jamais parvenue (cause classique : vous l’avez définie dans votre shell et le service est un autre processus). La même ligne permet de vérifier des choses comme OLLAMA_KEEP_ALIVE:30m0s : le serveur écrit les durées sous cette forme complète.
OLLAMA_HOST : 127.0.0.1 par défaut, et 0.0.0.0 dans Docker
Le 19 novembre 2026, le binaire Linux officiel de la v0.40.16 a démarré sans variables à l’écoute sur 127.0.0.1:11434 : seule votre propre machine peut le joindre. Nous l’avons vérifié de l’extérieur : sur 127.0.0.1, il a répondu {"version":"0.40.16"}, et par l’IP réseau de la machine, la connexion a échoué. Avec OLLAMA_HOST=0.0.0.0 (sans port), il est passé à [::]:11434, toutes les interfaces, en gardant le port 11434.
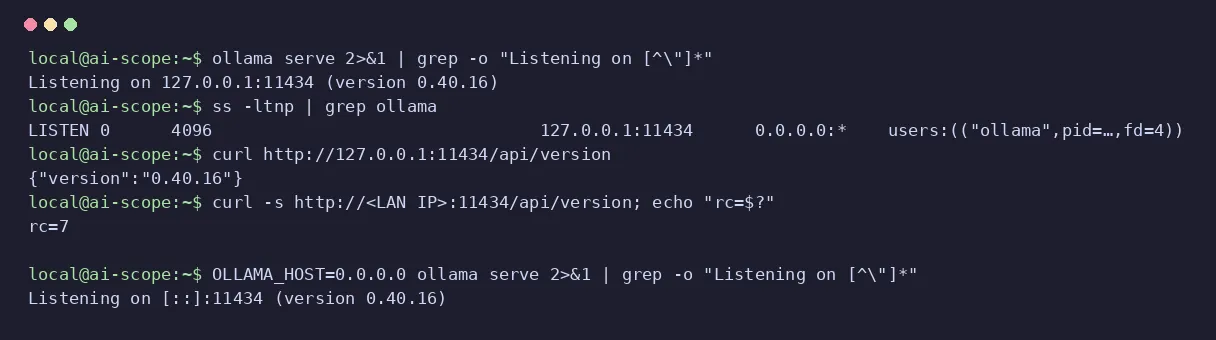
L’image Docker officielle fait l’inverse : elle embarque OLLAMA_HOST=0.0.0.0:11434 déjà défini, donc dans le conteneur le serveur écoute sur toutes les interfaces (constaté le 18 novembre avec ollama/ollama:0.40.16), et depuis l’extérieur du conteneur on le joint par le port publié avec -p. Ouvrir Ollama à votre réseau permet de l’utiliser depuis un portable ou un téléphone, et signifie aussi que n’importe qui sur ce réseau peut le joindre.
OLLAMA_ORIGINS est l’autre moitié. Elle ne décide pas qui se connecte, mais quelles pages web votre navigateur laisse parler à l’API. Avec OLLAMA_ORIGINS=https://mi-app.example, la v0.40.16 a placé notre origine en tête et conservé les 17 d’origine : elle ajoute, elle ne remplace pas. Le détail, avec des exemples, se trouve dans notre guide de l’API d’Ollama.
OLLAMA_KEEP_ALIVE : 5 minutes, 0, 30 ou -1 (pour toujours)
OLLAMA_KEEP_ALIVE fixe combien de temps un modèle reste chargé après sa dernière requête. La valeur par défaut dans la v0.40.16 est 5m0s, mesurée le 19 novembre 2026, et c’est le compte à rebours qu’affiche ollama ps dans sa colonne UNTIL. Nous avons essayé quatre valeurs avec cette version :
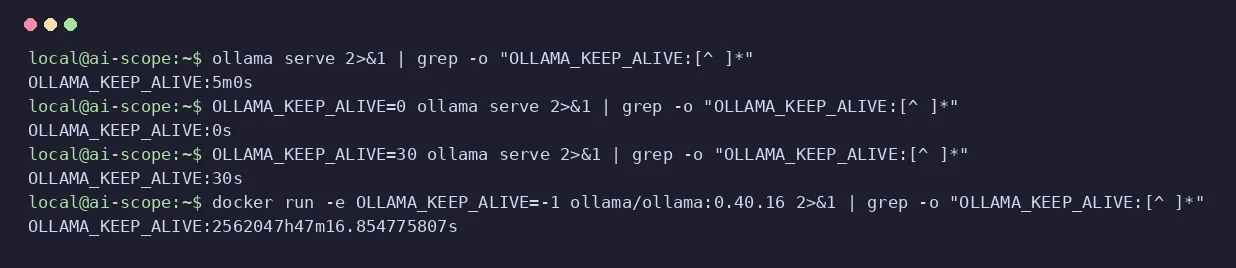
0→0s: le modèle est déchargé dès qu’il a répondu. La mémoire se libère, et la requête suivante doit le recharger.30→30s: un nombre sans unité compte en secondes, pas en minutes. Écrivez30msi vous voulez une demi-heure.-1→2562047h47m16.854775807s: toute valeur négative veut dire « ne jamais décharger ».
La variable fixe la valeur par défaut de tout le serveur. Chaque requête peut la remplacer par son propre champ keep_alive dans /api/generate ou /api/chat, qui l’emporte d’après la documentation de la v0.40.16 ; et ollama stop décharge un modèle sur-le-champ, comme le montre notre guide des commandes Ollama.
OLLAMA_NUM_PARALLEL, OLLAMA_MAX_LOADED_MODELS et OLLAMA_MAX_QUEUE
Ces trois-là décident combien de choses Ollama fait à la fois, et toutes coûtent de la mémoire. Dans la v0.40.16, mesuré le 19 novembre 2026, les valeurs par défaut sont 1, 0 et 512 :
OLLAMA_NUM_PARALLEL(1) : requêtes servies en même temps par chaque modèle. D’après la documentation de la v0.40.16, la mémoire nécessaire grandit avecNUM_PARALLEL× contexte : 4 requêtes en parallèle avec 8192 tokens de contexte réservent du cache pour 32 768 tokens.OLLAMA_MAX_LOADED_MODELS(0 = automatique) : la documentation place la limite automatique à 3 modèles par GPU, ou 3 en mode CPU, tant qu’ils tiennent en mémoire.OLLAMA_MAX_QUEUE(512) : requêtes qui attendent leur tour ; au-delà, le serveur répond par une erreur 503.
Pour une seule personne qui discute chez elle, les réglages d’origine conviennent. Augmentez NUM_PARALLEL si plusieurs outils ou personnes partagent le même serveur, et faites d’abord le calcul du contexte.
OLLAMA_FLASH_ATTENTION et OLLAMA_KV_CACHE_TYPE : moins de mémoire pour les longs contextes
OLLAMA_KV_CACHE_TYPE quantifie le cache du contexte : q8_0 consomme environ la moitié de la mémoire du f16 d’origine, et q4_0 environ un quart, d’après la documentation de la v0.40.16, qui précise que ce gain vaut quand la flash attention est activée. Le 19 novembre 2026, OLLAMA_KV_CACHE_TYPE=q8_0 est apparu tel quel dans la ligne de démarrage. Le coût de chaque contexte, modèle par modèle, se trouve dans notre guide de la longueur de contexte dans Ollama.
OLLAMA_FLASH_ATTENTION affiche false par défaut, ce qui veut dire « non forcée » : d’après sa documentation, la v0.40.16 utilise déjà la flash attention quand le moteur et le matériel la prennent en charge, et la variable sert à la forcer avec 1 ou à la bloquer avec 0. Et voici le piège que nous avons trouvé :
« invalid environment variable, using default » : une valeur refusée
C’est l’avertissement que donne la v0.40.16 quand une variable qui attend un nombre entier reçoit autre chose. Le 18 novembre 2026, avec OLLAMA_NUM_PARALLEL=abc, le serveur a démarré quand même et a écrit ceci dans le journal :
time=2026-11-18T15:53:14.078Z level=WARN source=config.go:265 msg="invalid environment variable, using default" key=OLLAMA_NUM_PARALLEL value=abc default=1Le 19 novembre, avec OLLAMA_MAX_LOADED_MODELS=dos, même message avec default=0. La ligne dit tout : quelle variable (key), ce que vous avez écrit (value) et ce qu’il a utilisé à la place (default). Elle apparaît pour les variables qui attendent un nombre entier : NUM_PARALLEL, MAX_LOADED_MODELS, MAX_QUEUE, CONTEXT_LENGTH, MAX_TRANSFER_STREAMS et GPU_OVERHEAD. Selon ce même code, un 16k dans OLLAMA_CONTEXT_LENGTH retomberait à 0, l’automatique : écrivez 16384.
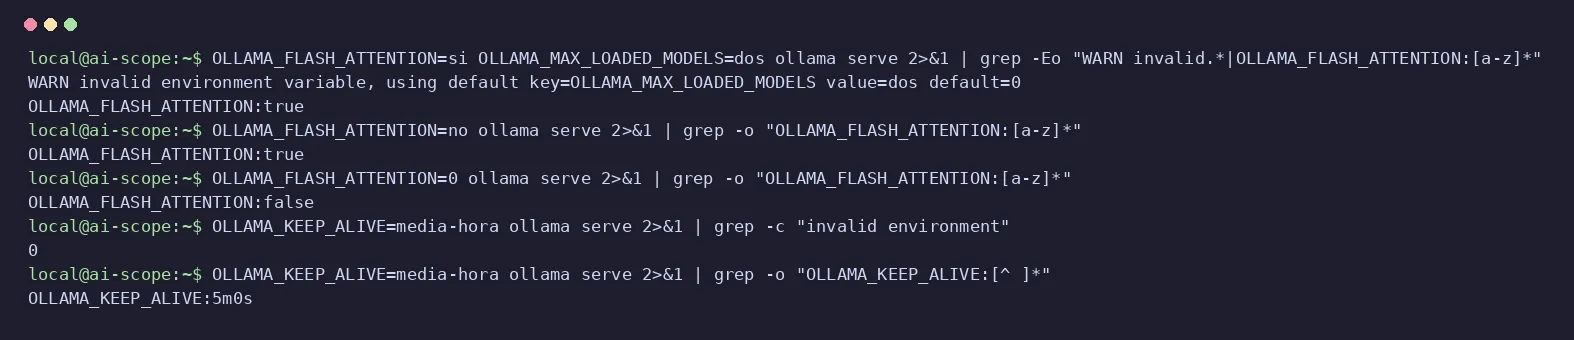
Les plus inquiétantes sont celles qui ne disent rien. OLLAMA_KEEP_ALIVE=media-hora (« une demi-heure » en espagnol, langue qu’Ollama ne parle pas) a démarré sans le moindre avertissement et est resté à 5m0s ; les interrupteurs lisent n’importe quelle fantaisie comme true. C’est pour cela que la ligne server config vaut mieux que tous les avertissements : cherchez-y votre variable après chaque changement. Et si le serveur ne démarre même pas, notre liste des erreurs d’Ollama avec leur texte exact prend le relais.