llama-server ist der HTTP-Server von llama.cpp: llama-server -m modell.gguf stellt eine OpenAI-kompatible API und eine Chatseite unter 127.0.0.1:9931 bereit (8080 bis einschließlich v0.6.0). Standardmäßig öffnet er 4 Slots, die sich den mit -c gesetzten Kontext teilen. -np, --api-key und --host brauchen Sie nur bei Bedarf.
Wir mögen llama-server, weil er nichts versteckt: Jede Anfrage, jeder Slot und jedes Token ist sichtbar, wenn man weiß, wo man hinschauen muss. Also haben wir am 11. November 2026 die stabile Version von llama.cpp genommen, v0.9.0 (Build b12110, veröffentlicht am 4. November 2026), ihren llama-server für Linux in einem Container ohne Netzwerk mit einem winzigen Modell von 135 Millionen Parametern gestartet, SmolLM2 in Q4_K_M, und ihn alles gefragt: welcher Port, welche Endpunkte, wie -c und -np den Kontext aufteilen und was er antwortet, wenn etwas schiefgeht. Jede Meldung auf dieser Seite ist die, die wir bekommen haben, Wort für Wort. Wo wir nur den Code von v0.9.0 gelesen haben, steht es dabei. Am 15. November 2026 haben wir alle Tests mit v1.0.0 wiederholt (Build b12359, veröffentlicht am 13. November 2026): dieselben Statuscodes, Meldungen und Speicherwerte, dazu eine Sicherheitszeile beim Start, die wir weiter unten erklären.
 llama.cppProgramm-Datenblatt
llama-server starten: Befehl, Port und Adresse
Am kürzesten geht es mit einer Modelldatei:
llama-server -m ./SmolLM2-135M-Instruct-Q4_K_M.ggufoder mit einem Modell von Hugging Face über -hf und den Namen des Repositorys. Das neue Einzelprogramm llama erledigt dasselbe mit llama serve; diese Seite verwendet llama-server, das im getesteten offiziellen Linux-Build weiterhin enthalten ist. Mit v0.9.0 am 11. November 2026 und erneut mit v1.0.0 am 15. November endete unser Log mit listening on http://127.0.0.1:9931, und der einzige offene Socket war 127.0.0.1 auf Port 9931. Port 8080 antwortete gar nicht. Schickt Sie eine ältere Anleitung auf 8080, ist das der Port von v0.6.0 und älter: --port 8080 stellt ihn wieder her.
Die Ausnahme sind die Docker-Images des Projekts: In den Dockerfiles von v0.9.0 und v1.0.0 haben wir gelesen, dass sie LLAMA_ARG_HOST=0.0.0.0 und LLAMA_ARG_PORT=8080 setzen. Im Container lauscht der Server also auf 8080, und zwar auf allen Schnittstellen.
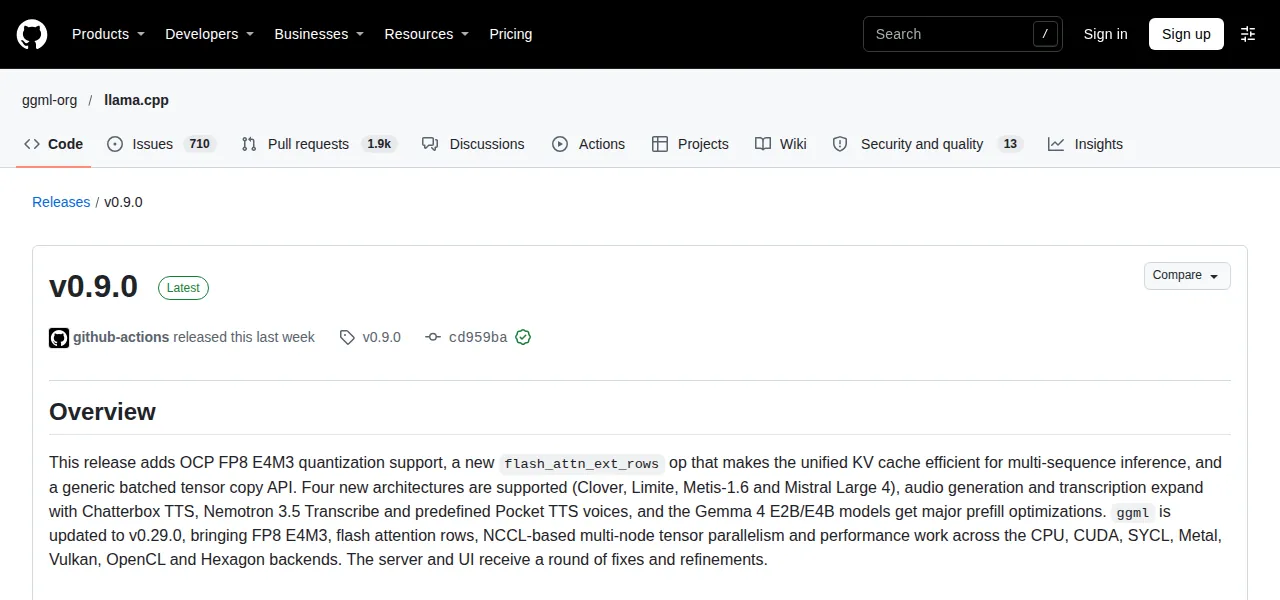
llama-server --version 0.9.0-dev (build 12110, commit cd959bae9) Screenshot: GitHub, ggml-org/llama.cpp, 11.11.2026Die Endpunkte, die Sie brauchen, und was jeder antwortet
llama-server spricht den Dialekt von OpenAI, den meisten Clients genügt daher die Basis-URL http://127.0.0.1:9931/v1. Das sind die Endpunkte, die wir aufgerufen haben, mit dem Statuscode bei einem Standardstart:
| Endpunkt | Wofür | Standardstart (v0.9.0 und v1.0.0) |
|---|---|---|
GET /health |
Ist der Server bereit? | 503 während des Ladens, dann 200 {"status":"ok"} |
GET /v1/models |
das bereitgestellte Modell, im OpenAI-Format | 200 |
POST /v1/chat/completions |
Chat, im OpenAI-Format | 200 |
GET /slots |
jeder Slot und sein Kontext | 200 |
GET /props |
Einstellungen: Slots, Chat-Vorlage, was aktiviert ist | 200 |
GET /metrics |
Zähler für Prometheus | 501, bis Sie --metrics ergänzen |
GET / |
die Chatseite | 200 im Browser |
Ein Detail von /v1/models: Die id des Modells ist der Pfad, den Sie an -m übergeben haben, bei uns /models/SmolLM2-135M-Instruct-Q4_K_M.gguf. Mit --alias smollm2 wird daraus smollm2, deutlich angenehmer für Clients, in die Sie einen Modellnamen eintippen müssen. Die Antwort enthält außerdem den Trainingskontext (n_ctx_train, hier 8.192) und die Größe, praktisch, um zu prüfen, welche Datei wirklich geladen ist. Und jede Chat-Antwort bringt einen Block timings und einen system_fingerprint mit dem Build mit, b12110-cd959bae9 bei v0.9.0 und b12359-b1b770d90 bei v1.0.0.
„Loading model“: der 503 von /health
Direkt nach dem Start antwortet /health mit 503 und {"error":{"message":"Loading model","type":"unavailable_error","code":503}}. Das ist kein Fehler: Das Modell lädt noch. Unseres brauchte 0,28 Sekunden, und trotzdem haben wir es 5-mal hintereinander erwischt, bevor das erste 200 kam; bei einem Modell mit vielen Gigabyte dauert es entsprechend länger. Skripte sollten auf das 200 warten, bevor sie Arbeit schicken.
„This server does not support metrics endpoint. Start it with `--metrics`“
Das ist der 501, den /metrics bei einem Standardstart liefert. Mit --metrics gibt er Prometheus-Zähler wie llamacpp:prompt_tokens_total, llamacpp:tokens_predicted_total und llamacpp:n_tokens_max aus.
„Error: gzip is not supported by this browser“
Wir haben die Chatseite mit einem nackten curl http://127.0.0.1:9931/ getestet und einen 415 mit diesem Text bekommen. Die Seite liegt komprimiert vor, und curl meldet ohne Option nicht, dass es gzip versteht. Ein Browser tut das, und curl --compressed erhält ein normales 200. Kaputt ist nichts.
-c und -np: wie llama-server den Kontext auf die Slots verteilt
Hier entstehen die meisten Überraschungen. Ein Slot ist ein Platz für ein Gespräch; -np (oder --parallel) legt fest, wie viele es gibt, und -c (oder --ctx-size), wie viele Tokens Speicher der Server insgesamt reserviert. Das meldete das Log in der Zeile n_slots / n_ctx_slot / kv_unified bei jedem Start mit unserem 8.192-Token-Modell:
| Start mit | Slots | Kontext pro Slot | Gemeinsamer Pool? | Reservierter KV-Cache (RAM, CPU-Build) |
|---|---|---|---|---|
| nichts (Standard) | 4 | 8.192 | ja, 8.192 für alle 4 | 180 MiB |
-np 4 |
4 | 8.192 | nein: 4 × 8.192 | 720 MiB |
-c 4096 -np 4 |
4 | 1.024 | nein | 90 MiB |
-c 4096 -np 4 -kvu |
4 | 4.096 | ja, 4.096 für alle 4 | nicht protokolliert |
-c 16384 -np 4 |
4 | 4.096 | nein | 360 MiB |
-np 1 |
1 | 8.192 | nein | 180 MiB |
Gemessen mit llama.cpp v0.9.0 am 11. November 2026 und mit v1.0.0 am 15. November 2026 (gleiche Werte), SmolLM2-135M in Q4_K_M; Speicher laut Log-Zeile KV buffer size. Ein größeres Modell braucht pro Token weit mehr Speicher.
Daraus folgen drei Regeln. Ohne Optionen wählt llama-server 4 Slots und einen vereinheitlichten Cache (gelesen in tools/server/server.cpp, Zeilen 126-130 in v0.9.0 und 129-133 in v1.0.0): ein einziger Pool an Tokens, aus dem alle Gespräche schöpfen, sodass ein einzelner langer Chat ihn ganz nutzen kann. Schreiben Sie -np 4 selbst, wird der Pool nicht mehr geteilt: Jeder Slot erhält den vollen Kontext, und der Cache belegte viermal so viel Speicher, 720 statt 180 MiB. Und mit -c plus -np wird -c geteilt: 4.096 auf 4 Slots lässt jedem 1.024 Tokens, und das Log meldet höflich n_ctx_seq (1024) < n_ctx_train (8192) -- the full capacity of the model will not be utilized. -kvu (--kv-unified) holt den gemeinsamen Pool zurück.
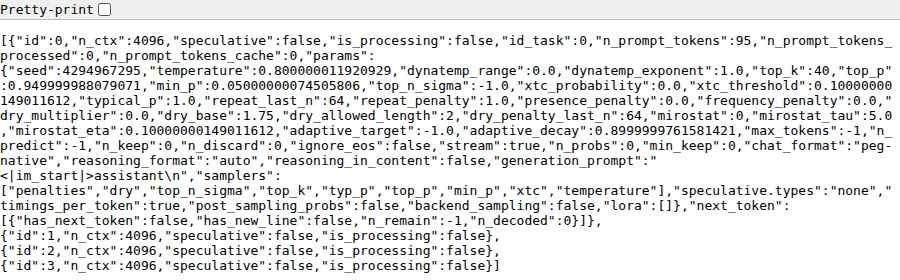
-c 4096 und ohne -np: 4 Slots, jeder kann die 4.096 Tokens des gemeinsamen Pools nutzen Screenshot: llama-server v0.9.0 (localaiscope.com), 11.11.2026Mehr Slots lohnen sich für echte parallele Arbeit. Mit -np 1 haben wir 2 Anfragen gleichzeitig geschickt: Eine war nach 1,18 s fertig, die andere wartete und brauchte 2,18 s. Mit -np 2 waren beide nach 1,33 s fertig. Sind Sie der einzige Nutzer, ist 1 Slot mit dem ganzen Kontext die ehrliche Wahl; mit selbst gesetztem -np reserviert jeder zusätzliche Slot seinen eigenen Cache (in unserem Test im RAM; eine Grafikkarte haben wir nicht gemessen). Wie viel Speicher Modell und Kontext auf Ihrer Karte belegen, berechnet unser Modellfinder, bei 8.192 Tokens.
„request (931 tokens) exceeds the available context size (256 tokens), try increasing it“
Das ist die wörtliche Fehlermeldung, als ein Prompt nicht in seinen Slot passte. Wir haben mit -c 512 -np 2 gestartet (256 Tokens pro Slot) und 931 Tokens geschickt. Die Antwort war ein 400:
{"error":{"code":400,"message":"request (931 tokens) exceeds the available context size (256 tokens), try increasing it","type":"exceed_context_size_error","n_prompt_tokens":931,"n_ctx":256}}Die Zahl in Klammern ist der Kontext eines Slots, nicht das -c, das Sie eingegeben haben. Ist sie kleiner als erwartet, teilen Sie Ihr -c durch die Zahl der Slots, und Sie haben den Übeltäter. Die Abhilfen, der Reihe nach: -np weglassen (oder -np 1 setzen), -kvu ergänzen, damit sich die Slots den Pool teilen, oder -c erhöhen.
Die andere Grenze ist leiser. Mit demselben Server, einem kurzen Prompt, max_tokens 400 und ignore_eos (damit das Modell nicht von selbst aufhören konnte) stoppte die Generierung bei insgesamt 256 Tokens (35 Prompt, 221 Antwort), mit finish_reason: "length" und einem 200; das Log meldete truncated = 1. Kein Fehler: Die Antwort endet einfach dort, wo der Slot endet, denn die Kontextverschiebung ist in v0.9.0 und v1.0.0 standardmäßig aus (gelesen in common/common.h, Zeile 580 in v0.9.0, 592 in v1.0.0). Brechen Antworten mitten im Satz ab, prüfen Sie finish_reason, bevor Sie dem Modell die Schuld geben.
--host, --port und --api-key: „Invalid API Key“
--host 0.0.0.0 --port 8080 tat, was es verspricht: Das Log zeigte listening on http://0.0.0.0:8080, und der Socket war auf allen Schnittstellen offen. Bevor Sie das auf einem Notebook tun, das auch mal das Haus verlässt, setzen Sie einen Schlüssel. Mit --api-key (oder der Variablen LLAMA_API_KEY, damit Sie ihn nicht in die Befehlszeile tippen) bekam eine Anfrage ohne Schlüssel oder mit einem falschen ein 401:
{"error":{"message":"Invalid API Key","type":"authentication_error","code":401}}Senden Sie ihn als Authorization: Bearer ihr-schluessel, so wie es OpenAI-Clients tun; der Code von v0.9.0 akzeptiert ihn auch im Header X-Api-Key. Zwei Dinge deckt der Schlüssel nicht ab, gemessen: /health antwortete ohne ihn weiter mit 200, und die Chatseite ist ebenfalls öffentlich (ohne Schlüssel antwortete sie weiter, mit dem gzip-415 des nackten curl); ihre eigenen Aufrufe der API brauchen den Schlüssel sehr wohl, wie wir im Code gelesen haben. Und ist der Port belegt, startet der Server nicht: couldn't bind HTTP server socket, hostname: 127.0.0.1, port: 9931, danach beendet er sich. Diesen Fehler und 13 weitere finden Sie in unserem Leitfaden zu llama.cpp-Fehlern.
Die Weboberfläche: ein Chat auf demselben Port
Öffnen Sie http://127.0.0.1:9931 im Browser, und ein vollständiger Chat erscheint: Unterhaltungen, Modellname, Parameterzahl und Quantisierung sowie Tokens pro Sekunde unter jeder Antwort. Sie ist standardmäßig an; --no-webui schaltet sie ab, wenn Sie nur die API wollen.
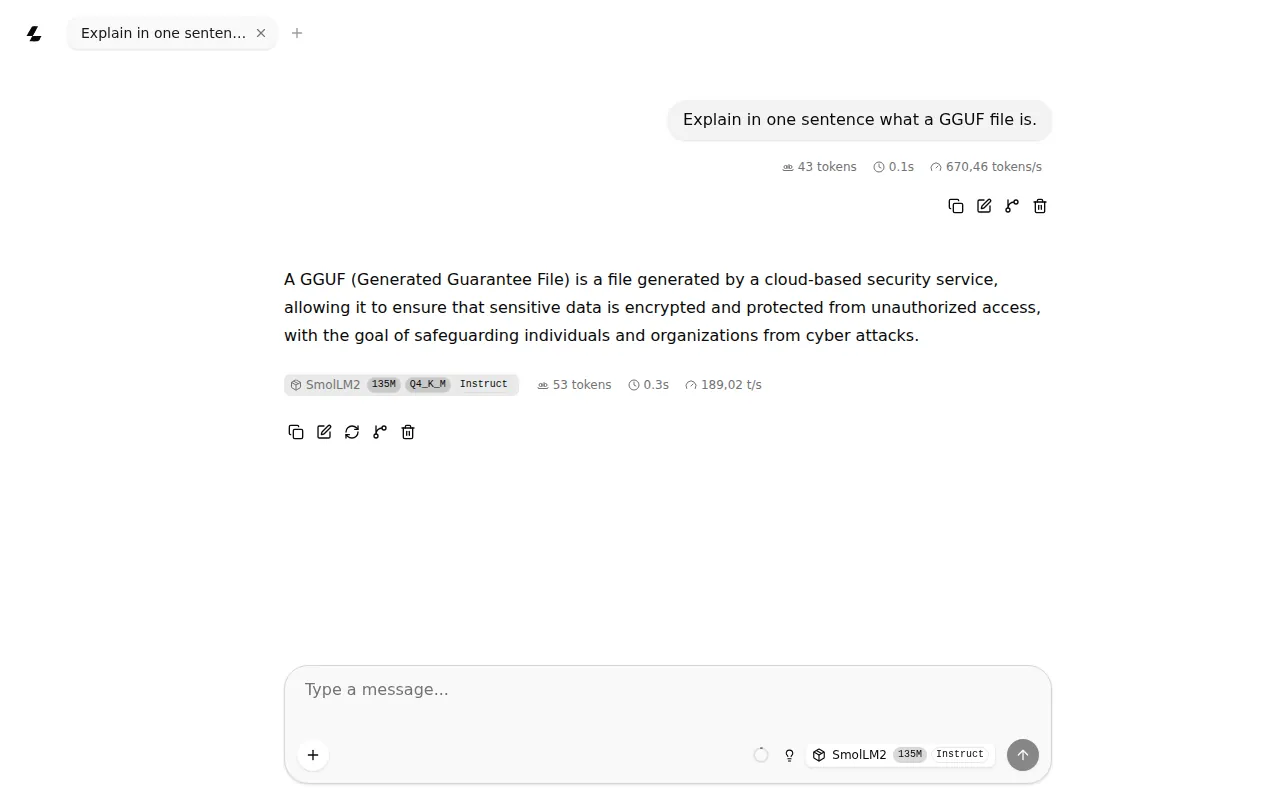
Ja, die Antwort ist falsch, und zwar mit Stil: 135 Millionen Parameter reichen, um einen Server zu testen, nicht, um ihn zu erklären. Für echte Fragen nehmen Sie ein echtes Modell. Im Video unten wird der Server mit -hf, Host und Port gestartet und die Oberfläche im Einsatz gezeigt.
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken.
Mehrere Modelle hinter einem Server: der Router-Modus
Starten Sie llama-server ohne Modell, aber mit einem Ordner, und er wird zum Router:
llama-server --models-dir ~/modelleUnser Log meldete starting server in router mode. models will be automatically loaded on-demand und als Warnung router mode enabled - do not expose to untrusted environments. /v1/models listete unsere 2 GGUF-Dateien (dasselbe Modell, unter 2 Namen kopiert), jede nach ihrem Dateinamen ohne .gguf benannt und als unloaded markiert. Eine Chat-Anfrage ohne Modellnamen bekam ein 400: model name is missing from the request. Mit "model": "SmolLM2-135M-Instruct-Q4_K_M" im Body startete der Router für dieses Modell einen eigenen llama-server auf einem eigenen Port, antwortete, und die Liste zeigte es als loaded, während das andere unloaded blieb. Im Code haben wir gelesen, dass er standardmäßig bis zu 4 Modelle geladen hält (--models-max).
Öffnet YouTube (ohne Cookies) erst, wenn Sie auf Play drücken.
Der Start, den wir kopieren würden
Für eine Person an einem Rechner:
export LLAMA_API_KEY="eine-lange-zufaellige-zeichenkette"
llama-server -m ./ihr-modell.gguf -c 8192 -np 1 --alias local
Damit haben Sie einen Slot mit allen 8.192 Tokens, einen Schlüssel und einen kurzen Modellnamen, unter 127.0.0.1:9931. Prüfen Sie es mit curl http://127.0.0.1:9931/health und curl -H "Authorization: Bearer $LLAMA_API_KEY" http://127.0.0.1:9931/v1/models. Die Installation von llama.cpp, die Wahl des Builds für Ihre Karte und die übrigen Sicherheitseinstellungen, CORS eingeschlossen, stehen in unserer Anleitung zur Einrichtung von llama.cpp; was es von sich aus sendet, auf dem llama.cpp-Steckbrief; und wenn Sie es mit einem Server für viele Nutzer vergleichen, lesen Sie vLLM vs. llama.cpp.