llama-server es el servidor HTTP de llama.cpp: llama-server -m modelo.gguf sirve una API compatible con OpenAI y una página de chat en 127.0.0.1:9931 (8080 en la v0.6.0 y anteriores). Por defecto abre 4 slots que comparten el contexto que le des con -c. -np, --api-key y --host, solo cuando los necesites.
Nos encanta llama-server porque no esconde nada: cada petición, cada slot y cada token están a la vista, si sabes dónde mirar. Así que el 11 de noviembre de 2026 cogimos la versión estable de llama.cpp, la v0.9.0 (compilación b12110, publicada el 4 de noviembre de 2026), arrancamos su llama-server para Linux en un contenedor sin red con un modelo diminuto de 135 millones de parámetros, SmolLM2 en Q4_K_M, y le preguntamos de todo: qué puerto usa, qué endpoints tiene, cómo reparten -c y -np el contexto y qué contesta cuando algo va mal. Cada mensaje que citamos aquí es el que nos devolvió, letra por letra. Donde solo leímos el código de la v0.9.0, lo decimos. El 15 de noviembre de 2026 repetimos todas las pruebas con la v1.0.0 (compilación b12359, publicada el 13 de noviembre de 2026): los mismos códigos de estado, mensajes y cifras de memoria, más una línea de seguridad al arrancar que explicamos más abajo.
 llama.cppFicha del programa
Arrancar llama-server: el comando, el puerto y la dirección
Lo mínimo es un fichero de modelo:
llama-server -m ./SmolLM2-135M-Instruct-Q4_K_M.ggufo un modelo de Hugging Face con -hf y el nombre del repositorio. El nuevo programa único llama hace lo mismo con llama serve; aquí usamos llama-server, que sigue dentro de la compilación oficial para Linux que probamos. Con la v0.9.0 el 11 de noviembre de 2026, y otra vez con la v1.0.0 el 15 de noviembre, nuestro registro terminó en listening on http://127.0.0.1:9931 y el único socket abierto era 127.0.0.1 en el puerto 9931. El 8080 ni contestó. Si un tutorial antiguo te manda al 8080, es el puerto de la v0.6.0 y anteriores: --port 8080 te lo devuelve.
La excepción son las imágenes Docker del proyecto: en los Dockerfile de la v0.9.0 y de la v1.0.0 leímos que fijan LLAMA_ARG_HOST=0.0.0.0 y LLAMA_ARG_PORT=8080, así que dentro de un contenedor escucha en el 8080 y en todas las interfaces.
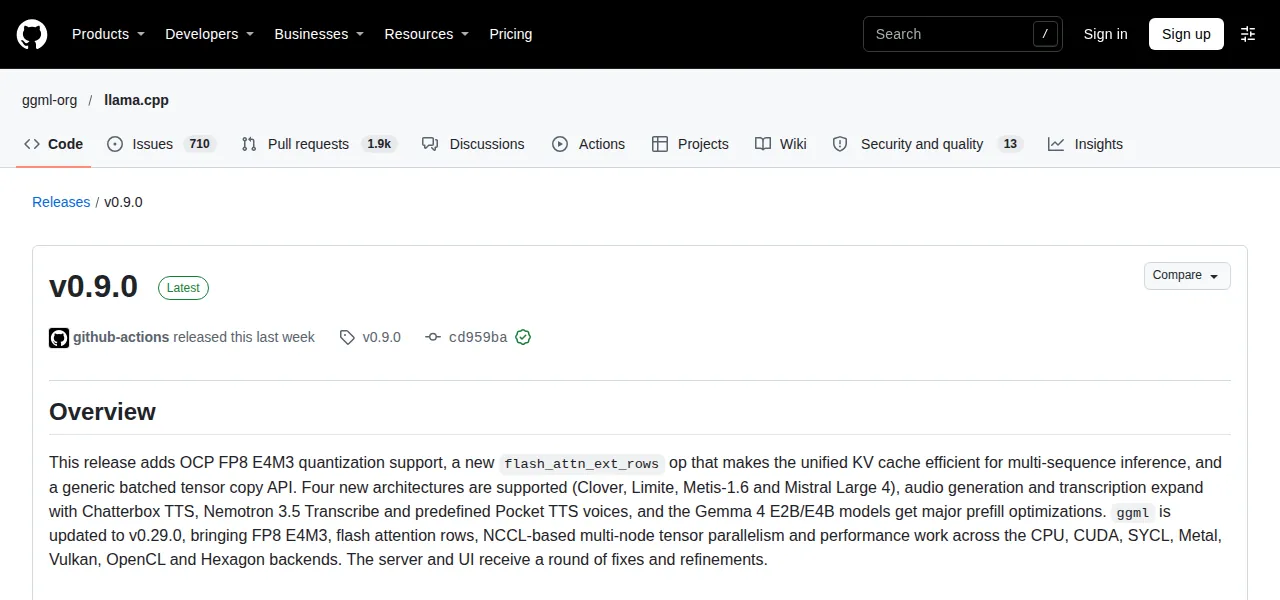
llama-server --version imprime 0.9.0-dev (build 12110, commit cd959bae9) Captura: GitHub, ggml-org/llama.cpp, 11-11-2026Los endpoints que vas a usar y qué contesta cada uno
llama-server habla el dialecto de OpenAI, así que a casi cualquier cliente le basta con la URL base http://127.0.0.1:9931/v1. Estos son los endpoints que llamamos, con el código que dio cada uno en un arranque por defecto:
| Endpoint | Para qué sirve | Arranque por defecto (v0.9.0 y v1.0.0) |
|---|---|---|
GET /health |
¿está listo el servidor? | 503 mientras carga, luego 200 {"status":"ok"} |
GET /v1/models |
el modelo que sirve, al estilo OpenAI | 200 |
POST /v1/chat/completions |
chat, al estilo OpenAI | 200 |
GET /slots |
cada slot y su contexto | 200 |
GET /props |
ajustes: slots, plantilla, qué está activado | 200 |
GET /metrics |
contadores para Prometheus | 501 hasta que añades --metrics |
GET / |
la página de chat | 200 en un navegador |
Un detalle de /v1/models: el id del modelo es la ruta que pasaste a -m, en nuestro caso /models/SmolLM2-135M-Instruct-Q4_K_M.gguf. Arranca con --alias smollm2 y el id pasa a ser smollm2, mucho más cómodo para los clientes que te piden escribir el nombre del modelo. La respuesta trae además el contexto de entrenamiento (n_ctx_train, 8.192 aquí) y el tamaño, útiles para comprobar qué fichero está cargado de verdad. Y cada respuesta de chat lleva un bloque timings y un system_fingerprint con la compilación, b12110-cd959bae9 en la v0.9.0 y b12359-b1b770d90 en la v1.0.0.
«Loading model»: el 503 de /health
Nada más arrancar, /health responde 503 con {"error":{"message":"Loading model","type":"unavailable_error","code":503}}. No es un fallo: el modelo todavía está cargando. El nuestro tardó 0,28 segundos y aun así lo pillamos 5 veces seguidas antes del primer 200; con un modelo de muchos gigas estarás ahí bastante más. Si tienes un script, que espere al 200 antes de mandar trabajo.
«This server does not support metrics endpoint. Start it with `--metrics`»
Es el 501 que devuelve /metrics en un arranque por defecto. Con --metrics devuelve contadores de Prometheus como llamacpp:prompt_tokens_total, llamacpp:tokens_predicted_total y llamacpp:n_tokens_max.
«Error: gzip is not supported by this browser»
Probamos la página de chat con un curl http://127.0.0.1:9931/ a pelo y nos llevamos un 415 con ese texto. La página va guardada comprimida y curl, sin más, no dice que acepte gzip. Un navegador sí lo dice, y curl --compressed recibe un 200 normal. No hay nada roto.
-c y -np: cómo reparte llama-server el contexto entre los slots
Aquí nacen casi todas las sorpresas. Un slot es un asiento para una conversación; -np (o --parallel) dice cuántos hay y -c (o --ctx-size) dice cuántos tokens de memoria reserva el servidor en total. Esto dijo el registro, línea n_slots / n_ctx_slot / kv_unified, en cada arranque con nuestro modelo de 8.192 tokens:
| Arrancas con | Slots | Contexto por slot | ¿Bolsa compartida? | Caché KV reservada (RAM, compilación CPU) |
|---|---|---|---|---|
| nada (por defecto) | 4 | 8.192 | sí, 8.192 para los 4 | 180 MiB |
-np 4 |
4 | 8.192 | no: 4 × 8.192 | 720 MiB |
-c 4096 -np 4 |
4 | 1.024 | no | 90 MiB |
-c 4096 -np 4 -kvu |
4 | 4.096 | sí, 4.096 para los 4 | no consta |
-c 16384 -np 4 |
4 | 4.096 | no | 360 MiB |
-np 1 |
1 | 8.192 | no | 180 MiB |
Medido con llama.cpp v0.9.0 el 11 de noviembre de 2026 y con la v1.0.0 el 15 de noviembre de 2026 (mismas cifras), SmolLM2-135M en Q4_K_M; memoria según la línea KV buffer size del registro. Un modelo más grande necesita muchísima más memoria por token.
De ahí salen tres reglas. Sin flags, llama-server elige 4 slots y una caché unificada (lo leímos en tools/server/server.cpp, líneas 126-130 en la v0.9.0 y 129-133 en la v1.0.0): una sola bolsa de tokens de la que beben todas las conversaciones, así que un chat largo puede usarla entera. Si escribes tú -np 4, la bolsa deja de ser compartida: cada slot recibe el contexto completo y la caché ocupó 4 veces más, 720 MiB en vez de 180. Y con -c más -np, -c se divide: 4.096 entre 4 slots deja 1.024 tokens a cada uno, y el registro avisa, muy educado, n_ctx_seq (1024) < n_ctx_train (8192) -- the full capacity of the model will not be utilized. -kvu (--kv-unified) recupera la bolsa compartida.
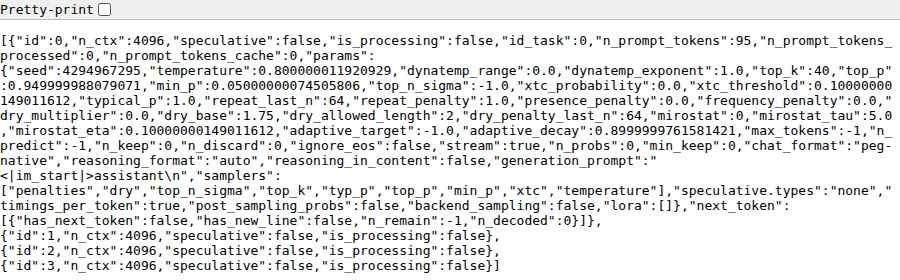
-c 4096 y sin -np: 4 slots, cada uno capaz de usar los 4.096 tokens de la bolsa compartida Captura: llama-server v0.9.0 (localaiscope.com), 11-11-2026Más slots sirven para trabajo en paralelo de verdad. Con -np 1 mandamos 2 peticiones a la vez: una acabó en 1,18 s y la otra esperó su turno y tardó 2,18 s. Con -np 2, las dos acabaron en 1,33 s. Si el único usuario eres tú, 1 slot con todo el contexto es lo sensato; con -np escrito a mano, cada slot de más reserva su propia caché (en nuestra prueba, en RAM; una tarjeta gráfica no la medimos). Cuánta memoria ocupan el modelo y su contexto en tu tarjeta lo calcula nuestro buscador de modelos, a 8.192 tokens.
«request (931 tokens) exceeds the available context size (256 tokens), try increasing it»
Ese es el error literal que nos dio un prompt que no cabía en su slot. Arrancamos con -c 512 -np 2 (256 tokens por slot) y mandamos 931 tokens. La respuesta fue un 400:
{"error":{"code":400,"message":"request (931 tokens) exceeds the available context size (256 tokens), try increasing it","type":"exceed_context_size_error","n_prompt_tokens":931,"n_ctx":256}}El número entre paréntesis es el contexto de un slot, no el -c que escribiste. Si ves una cifra más pequeña de la que esperabas, divide tu -c entre tus slots y ahí tienes al culpable. Los arreglos, por orden: quita -np (o pon -np 1), añade -kvu para que los slots compartan la bolsa, o sube -c.
El otro borde es más discreto. Con el mismo servidor, un prompt corto, max_tokens 400 e ignore_eos (para que el modelo no pudiera parar por su cuenta), la generación se paró en 256 tokens en total (35 de prompt y 221 de respuesta) con finish_reason: "length" y un 200, y el registro dijo truncated = 1. Ningún error: la respuesta se corta donde acaba el slot, porque el desplazamiento de contexto viene apagado por defecto en la v0.9.0 y en la v1.0.0 (lo leímos en common/common.h, línea 580 en la v0.9.0, 592 en la v1.0.0). Si las respuestas se quedan a medias, mira finish_reason antes de echarle la culpa al modelo.
--host, --port y --api-key: «Invalid API Key»
--host 0.0.0.0 --port 8080 hizo lo que promete: el registro mostró listening on http://0.0.0.0:8080 y el socket quedó abierto en todas las interfaces. Antes de hacerlo en un portátil que sale de casa, ponle una clave. Con --api-key (o la variable LLAMA_API_KEY, para no escribirla en la línea de comandos), una petición sin clave, o con otra, se llevó un 401:
{"error":{"message":"Invalid API Key","type":"authentication_error","code":401}}Mándala como Authorization: Bearer tu-clave, que es lo que hacen los clientes de OpenAI; el código de la v0.9.0 también la acepta en una cabecera X-Api-Key. Dos cosas que la clave no cubre, medidas: /health siguió contestando 200 sin ella, y la página de chat también es pública (sin clave siguió contestando, con el 415 del gzip de curl a pelo); sus propias llamadas a la API sí necesitan la clave, según leímos en el código. Y si el puerto está ocupado, el servidor no arranca: couldn't bind HTTP server socket, hostname: 127.0.0.1, port: 9931, y se cierra. Ese error y 13 más están en nuestra guía de errores de llama.cpp.
La interfaz web: un chat en el mismo puerto
Abre http://127.0.0.1:9931 en el navegador y tienes un chat completo: conversaciones, nombre del modelo, número de parámetros y cuantización, y tokens por segundo debajo de cada respuesta. Viene activada; --no-webui la apaga si solo quieres la API.
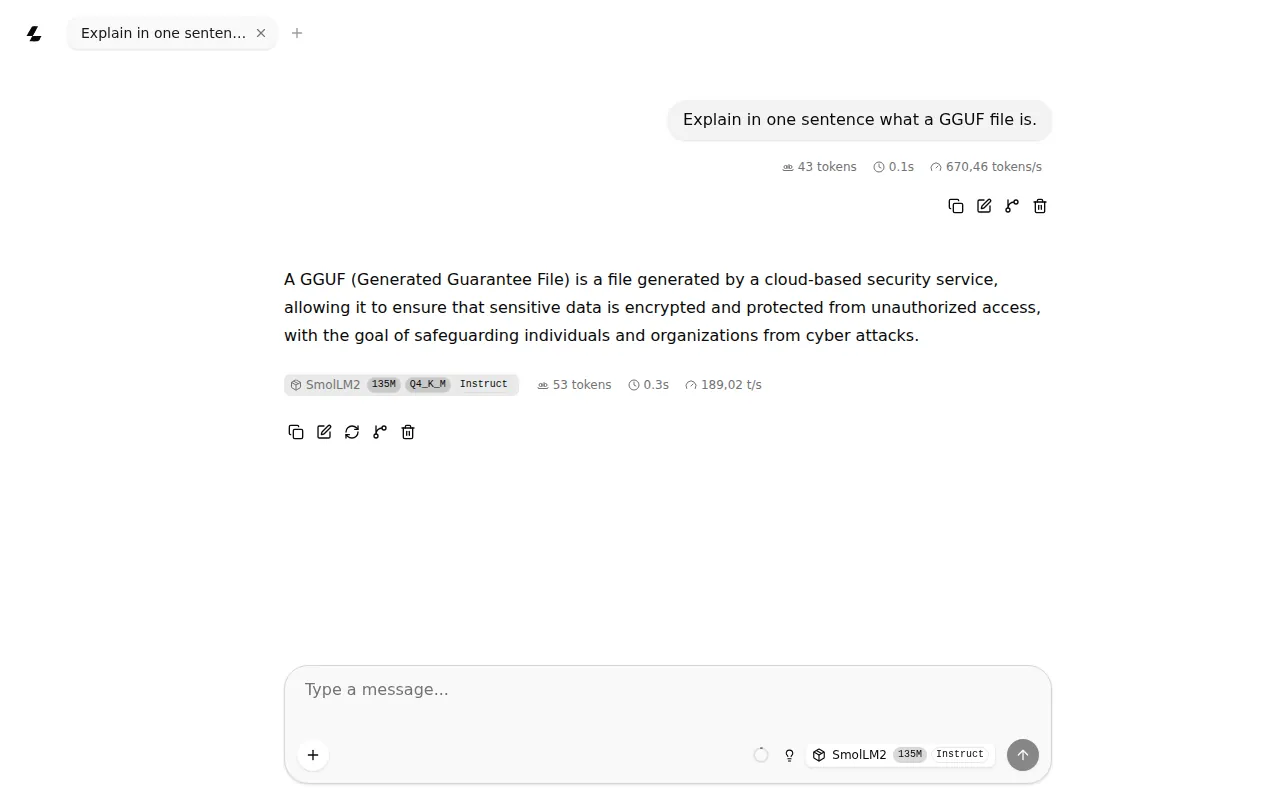
Sí, la respuesta está mal, y con mucho arte: 135 millones de parámetros dan para probar un servidor, no para explicarlo. Para preguntas de verdad, un modelo de verdad. En este curso en español se arranca llama-server y se usan la interfaz de chat y el endpoint local:
Se abre en YouTube (sin cookies) solo si pulsas.
Varios modelos detrás de un solo servidor: el modo router
Arranca llama-server sin modelo y con una carpeta, y se convierte en un router:
llama-server --models-dir ~/modelosNuestro registro dijo starting server in router mode. models will be automatically loaded on-demand y, a modo de aviso, router mode enabled - do not expose to untrusted environments. /v1/models listó nuestros 2 ficheros GGUF (el mismo modelo, copiado con 2 nombres), cada uno con el nombre de su fichero sin .gguf y marcado unloaded. Una petición de chat sin nombre de modelo se llevó un 400: model name is missing from the request. Con "model": "SmolLM2-135M-Instruct-Q4_K_M" en el cuerpo, el router lanzó un llama-server aparte para ese modelo en su propio puerto, contestó, y la lista lo mostró loaded mientras el otro seguía unloaded. En el código leímos que mantiene hasta 4 modelos cargados por defecto (--models-max).
Se abre en YouTube (sin cookies) solo si pulsas.
El arranque que copiaríamos
Para una persona en una máquina:
export LLAMA_API_KEY="una-cadena-larga-y-aleatoria"
llama-server -m ./tu-modelo.gguf -c 8192 -np 1 --alias local
Eso te da un slot con los 8.192 tokens, una clave y un nombre corto de modelo, en 127.0.0.1:9931. Compruébalo con curl http://127.0.0.1:9931/health y curl -H "Authorization: Bearer $LLAMA_API_KEY" http://127.0.0.1:9931/v1/models. Instalar llama.cpp, elegir la compilación para tu tarjeta y el resto de la seguridad, CORS incluido, está en nuestra guía para instalar llama.cpp; lo que envía por su cuenta, en la ficha de llama.cpp; y si lo comparas con un servidor pensado para muchos usuarios, mira vLLM vs llama.cpp.