On vous comprend. Vous avez vu l’AI Cube de Xiaomi, un petit boîtier de 80 Go de mémoire pensé pour faire tourner de grands modèles de langage à la maison, et la question évidente est tombée tout de suite : combien, et où est le bouton « acheter » ? Nous nous sommes posé exactement la même, avec le même cœur qui bat un peu trop vite. La réponse est courte et un brin décevante : il n’y a pas de prix, et il n’y a pas de bouton. Alors nous avons fait la chose utile. Nous avons pris le Cube et les 4 machines de 64 à 192 Go de mémoire unifiée qui ont déjà un prix fabricant, puis nous avons passé les 5 au même calcul que toutes les machines de ce site, face aux mêmes 26 modèles.
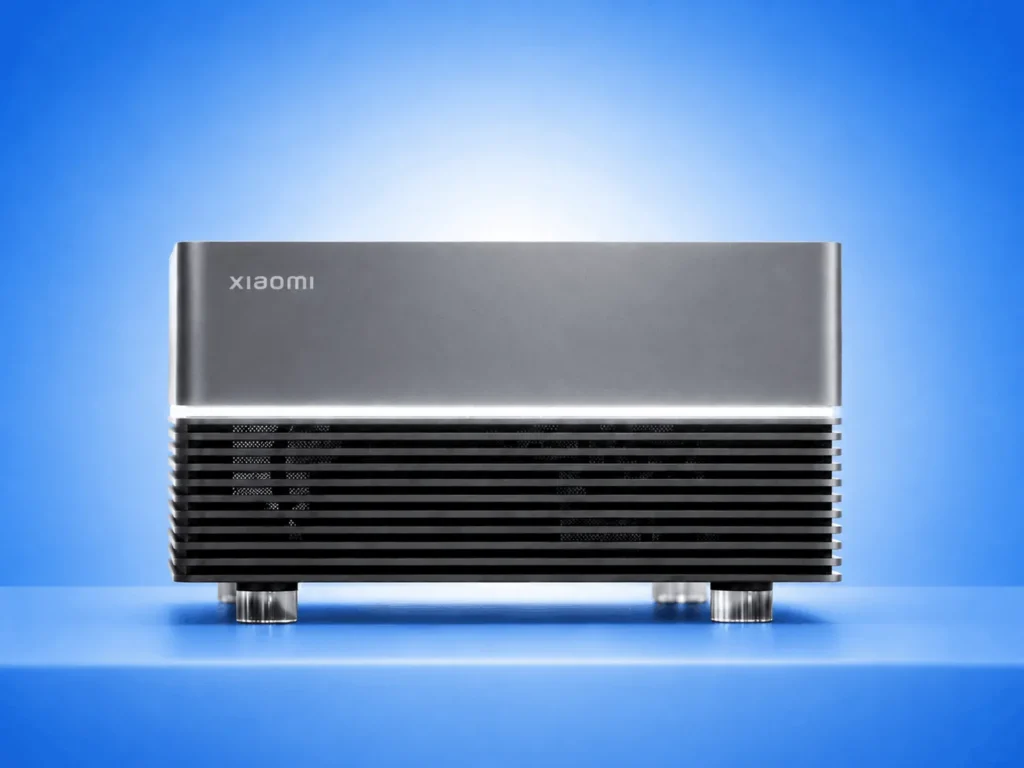
 Xiaomi AI Cube, 80 Go — prototype d’ingénieriePrototype · Fiche matériel
La bonne nouvelle, c’est que ce que promet le Cube — un petit boîtier capable de loger un modèle trop gros pour une carte graphique de joueur — a déjà un prix, en 4 versions, de 2 899 $ à 6 799 $. Laquelle vaut le coup dépend des modèles que vous voulez faire tourner, de la quantité de texte que vous leur donnez à lire et du temps que vous êtes prêt à attendre la réponse. Passons-les en revue.
Les cinq machines côte à côte
Le chiffre qui décide si un modèle tourne n’est pas la mémoire inscrite sur la boîte : c’est la mémoire qui reste pour le modèle une fois que le système s’est servi. Sur les machines Apple, c’est le total moins les 3 Gio que nous réservons au système d’exploitation. Sur les machines AMD Ryzen AI Max, il existe une seconde limite, facile à rater : AMD plafonne la part de cette mémoire que la partie graphique a le droit d’utiliser.
| Machine | Mémoire | Pour le modèle | Bande passante mémoire | Prix fabricant (US) | Modèles qui tiennent à 32k | Plafond de contexte de gpt-oss-120b |
|---|---|---|---|---|---|---|
| Mac mini, M5 Pro, 64 Go | 64 Go | 61,00 Gio | 307 Go/s (Apple) | 2 899 $ | 20 sur 26 | 32k tokens |
| Xiaomi AI Cube, 80 Go | 80 Go | 77,00 Gio | 341 Go/s (notre estimation) | aucun : prototype | 22 sur 26 | 128k tokens |
| PC, Ryzen AI Max+ 395, 128 Go | 128 Go | 96,00 Gio | 256 Go/s (déduit) | 3 449 $ | 23 sur 26 | 128k tokens |
| Mac Studio, M5 Max, 128 Go | 128 Go | 125,00 Gio | 614 Go/s (Apple) | 5 099 $ | 23 sur 26 | 128k tokens |
| PC, Ryzen AI Max+ PRO 495, 192 Go | 192 Go | 160,00 Gio | 273 Go/s (déduit) | 6 799 $ | 24 sur 26 | 128k tokens |
Les modèles sont comptés à la compression de référence (Q4_K_M, ou la plus proche que publie l’auteur), et 128k, c’est le maximum qu’accepte gpt-oss-120b lui-même : sur 4 des 5 machines, la limite vient donc du modèle, pas de la machine. Trois choses sautent aux yeux, et c’est d’elles que parle la suite. Le Mac de 64 Go fait déjà tenir gpt-oss-120b. Les deux machines de 128 Go acceptent exactement les mêmes modèles, malgré 29 Gio d’écart. Et le Cube, celui qu’on ne peut pas acheter, atterrit au milieu du tableau, pas tout en haut.
Mac mini M5 Pro, 64 Go : le ticket le moins cher pour un 120B
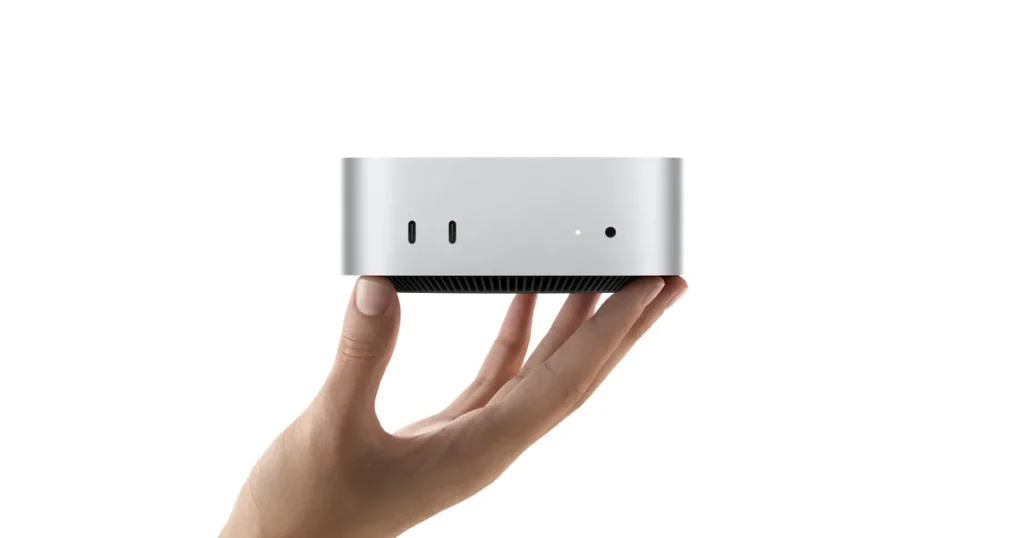
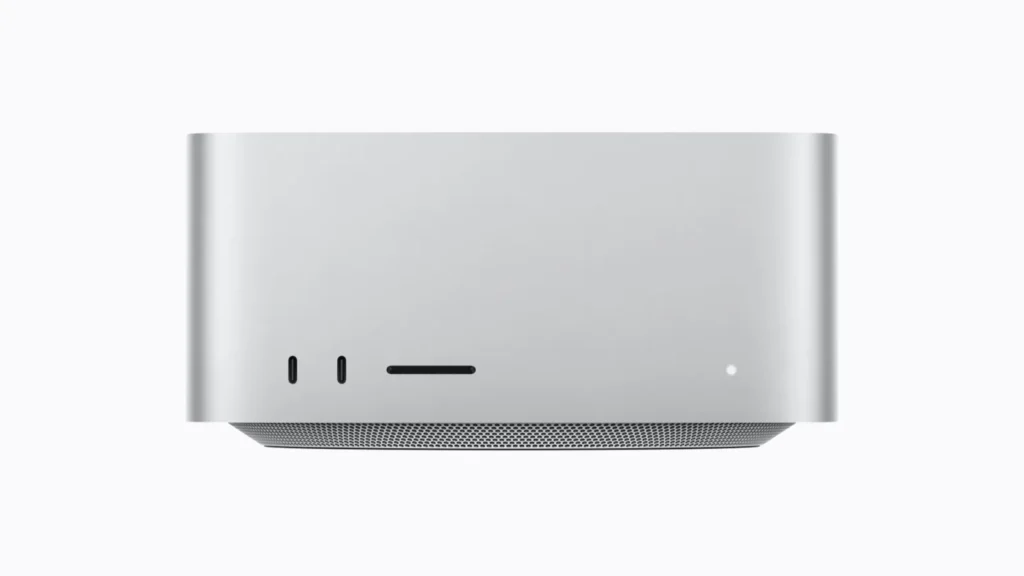
 Mac mini avec M5 Pro et 64 Go unifiésFiche matériel
C’est la plus petite machine en vente de ce comparatif à faire tourner gpt-oss-120b, et rien que pour ça, elle mérite qu’on s’y arrête. Apple demande 2 899 $ sur sa boutique américaine pour la configuration avec 64 Go de mémoire et 512 Go de stockage (prix relevé le 1er octobre 2026). C’est 1 200 $ de plus que les 1 699 $ du Mac mini M5 Pro d’entrée de gamme, parce que ce modèle de base n’a que 24 Go, et qu’avec 24 Go, cette liste reste hors de portée.
Avec 61,00 Gio pour le modèle, il fait tenir 20 de nos 26 modèles à 32k de contexte. Les 6 qu’il laisse de côté sont les 6 fichiers les plus lourds du catalogue : llama4-scout-17b (60,87 Gio rien que pour les poids : il échoue d’un cheveu une fois ajoutés le cache et la mémoire de travail du moteur d’exécution), nemotron-3.5-super-120b (65,29 Gio : ici, les poids seuls débordent déjà), qwen3.8-flash-next, deepseek-v4-flash, glm-5.3-flash et glm-5.2.
Le hic, c’est le plafond. gpt-oss-120b est un fichier de 58,46 Gio, et dans 61,00 Gio, il tient à 32k de contexte, pas un cran de plus. Imaginez une valise qu’on ne ferme qu’en s’asseyant dessus : elle ferme, mais plus de place pour les souvenirs. Pour discuter et pour la plupart des documents, 32k suffisent largement. Pour lui faire lire une base de code entière, non.
Ryzen AI Max+ 395, 128 Go : pourquoi 128 font en réalité 96
 PC avec Ryzen AI Max+ 395 et 128 Go unifiésFiche matériel
Voici le chiffre qui nous a le plus surpris. Un PC équipé du Ryzen AI Max+ 395 d’AMD et de 128 Go de mémoire unifiée ne laisse pas 125 Gio au modèle, comme le ferait un Mac doté de la même mémoire. AMD le dit lui-même : cette génération « topped out at 128GB of total memory with up to 96GB reserved for GPU workloads », autrement dit 128 Go au total au maximum, dont 96 Go au plus réservés au GPU. Notre moteur compte donc 96,00 Gio, et c’est de ce chiffre que découle chaque verdict de sa fiche.
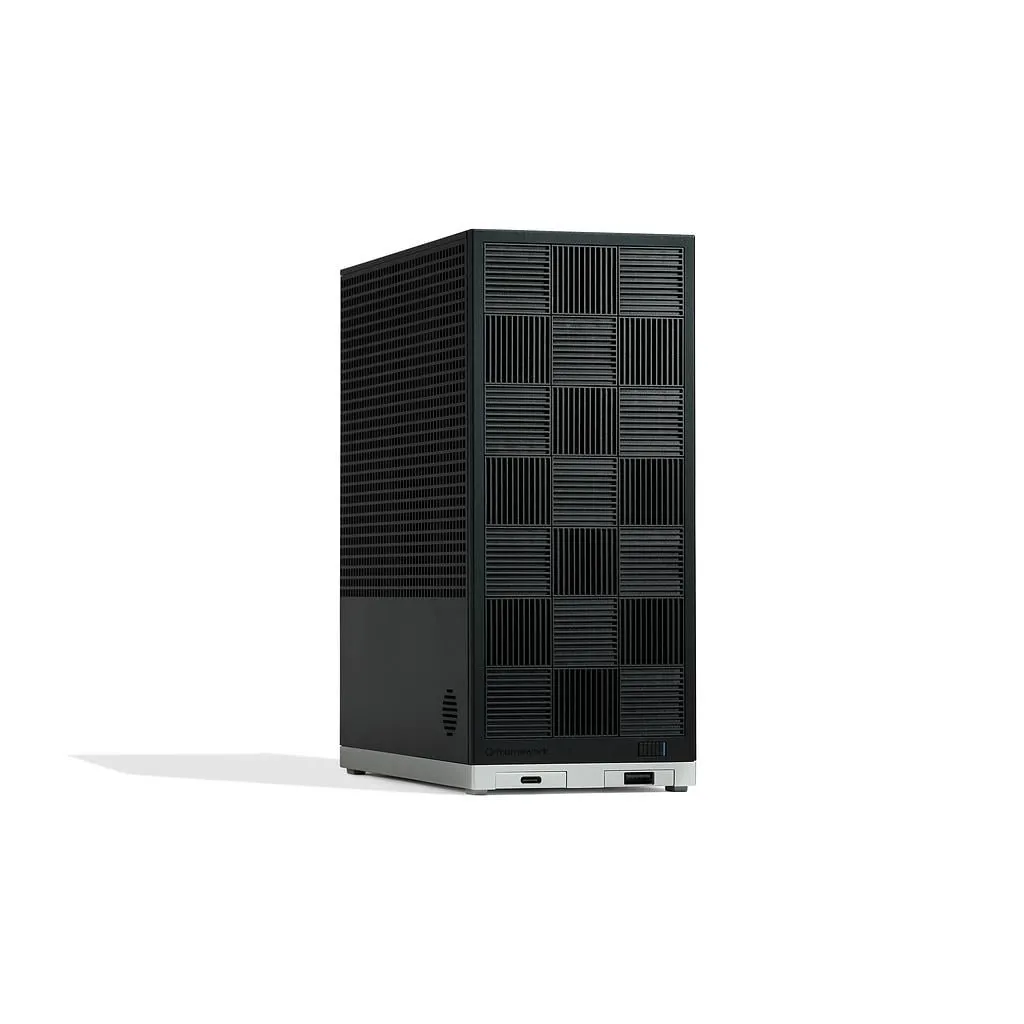
Et pourtant, 96 Gio, c’est beaucoup. Il fait tenir 23 des 26 modèles à 32k et 21 à 128k. Il accepte gpt-oss-120b à 128k, son maximum déclaré, llama4-scout-17b jusqu’à 256k, qwen3.8-flash-next et ses 87,25 Gio jusqu’à 128k, et nemotron-3.5-super-120b jusqu’à son propre maximum déclaré. Les 3 qu’il ne peut pas prendre sont deepseek-v4-flash (127,28 Gio), glm-5.3-flash (187,04 Gio) et glm-5.2 (433,83 Gio).
Côté prix, Framework affiche son Desktop avec le Max+ 395 et 128 Go à 3 449 $ hors taxes, et la page indiquait cette configuration en rupture de stock quand nous l’avons consultée le 30 septembre 2026. En mai 2026, AMD annonçait 3 999 $ comme prix de vente de sa propre machine 395 de 128 Go, la Ryzen AI Halo. Dans un cas comme dans l’autre, c’est la voie la moins chère de ce comparatif vers le modèle de 87 Gio.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Mac Studio M5 Max, 128 Go : la même liste, deux fois plus vite
 Mac Studio avec M5 Max et 128 Go unifiésFiche matériel
Mêmes 128 Go sur la boîte, et cette fois 125,00 Gio pour le modèle, car Apple ne publie pas de plafond GPU séparé ; macOS garde une limite par défaut qu’un réglage permet de relever (iogpu.wired_limit_mb), et notre chiffre suppose que vous la relevez. On s’attendrait à ce que ces 29 Gio de plus fassent entrer des modèles supplémentaires. Eh bien, non.
Là où le Mac Studio prend le large, c’est la vitesse. Apple annonce 614 Go/s de bande passante mémoire pour cette puce, contre 256 Go/s sur le 395, et quand un modèle écrit sa réponse, il doit relire les poids qu’il utilise à chaque token. Notre moteur estime gpt-oss-120b à environ 36 tokens par seconde sur le Mac Studio et à environ 14 sur le 395. Pour qwen3.6-35b-a3b, environ 102 contre environ 39. Ces vitesses sont des estimations tirées d’une formule publique, pas des mesures, et elles ne décident jamais si un modèle tient ; mais un écart de bande passante de 2,4 fois, aucune estimation ne l’invente.
L’addition : 5 099 $ sur la boutique américaine d’Apple pour le M5 Max avec 128 Go et 512 Go de stockage (prix relevé le 1er octobre 2026). C’est 1 650 $ de plus que l’offre de Framework, pour la même liste de modèles. Ce que vous payez, ce sont des réponses qui arrivent plus de deux fois plus vite, selon notre estimation, et qwen3.8-flash-next et llama4-scout-17b qui voient deux fois plus loin.
Ryzen AI Max+ PRO 495, 192 Go : le seul qui charge deepseek-v4-flash
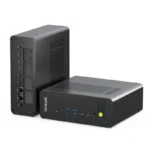 PC avec Ryzen AI Max+ PRO 495 et 192 Go unifiésFiche matériel
C’est la dernière des cinq à arriver chez les acheteurs, et la plus grosse. Le Ryzen AI Max+ PRO 495 d’AMD accepte jusqu’à 192 Go, avec, selon les mots d’AMD, « up to 160GB dedicated to the GPU » : jusqu’à 160 Go réservés au GPU. Notre moteur compte 160,00 Gio pour le modèle : 29 de moins que ce que laisserait un Mac de 192 Go, et tout de même 35 de plus que le Mac Studio ci-dessus.
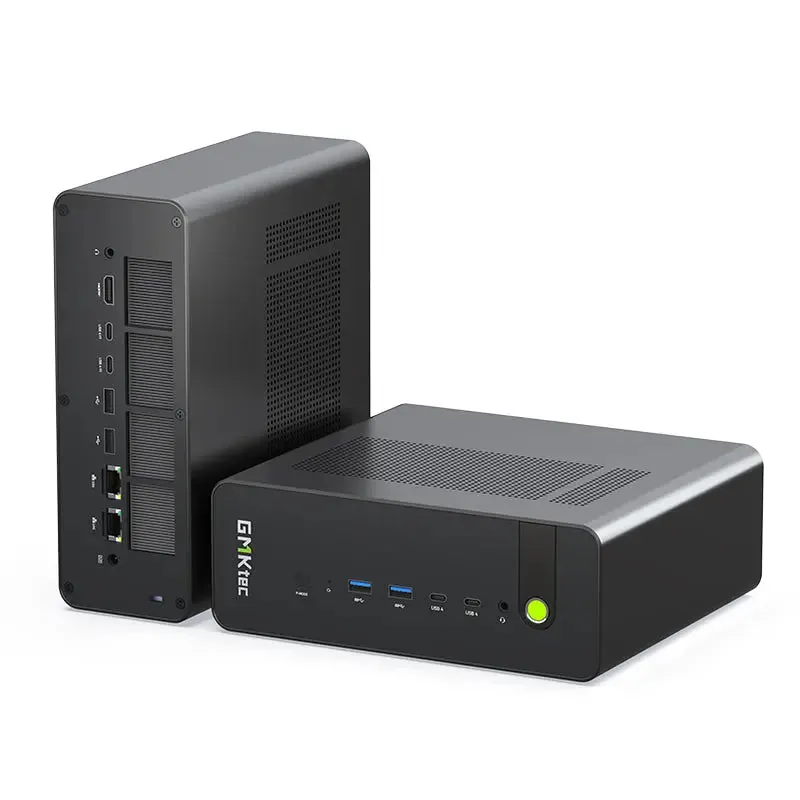
Ces 160 Gio lui permettent de faire la seule chose qu’aucune autre machine de ce comparatif ne sait faire : charger deepseek-v4-flash, un fichier de 127,28 Gio à sa compression de référence, jusqu’à 256k de contexte. Il fait tenir 24 des 26 modèles à 32k et 22 à 128k. Les 2 qui restent dehors sont glm-5.3-flash, dont les 187,04 Gio débordent même de ces 160, et glm-5.2 qui, avec ses 433,83 Gio, n’est un modèle pour machine domestique selon aucun calcul.
GMKtec vend son EVO-X5 Pro avec cette puce, 192 Go et 2 To de stockage, à 6 799 $ sur sa propre boutique (il était à 6 599 $ jusqu’à début octobre ; prix revérifié le 9 octobre 2026), et le 30 septembre, les expéditions avaient déjà commencé. C’est la machine la plus chère de ce comparatif, et la seule qu’on achèterait pour une raison unique : un modèle qui ne tient pas dans les 125 Gio du Mac Studio mais tient dans 160, c’est-à-dire aujourd’hui, dans notre catalogue, deepseek-v4-flash.
S’ouvre sur YouTube (sans cookies) seulement si vous appuyez. Plus de vidéos sur sa fiche →
Et l’AI Cube ? Pile au milieu
Remettons maintenant le Cube sur la table. Avec 80 Go et 77,00 Gio pour le modèle, il fait tenir 22 des 26 modèles à 32k : 2 de plus que le Mac mini de 64 Go, et 1 ou 2 de moins que toutes les autres. Face au Mac mini, il ajoute llama4-scout-17b (jusqu’à 128k), nemotron-3.5-super-120b (jusqu’à 256k ; avec 65,29 Gio, le plus gros fichier que le Cube accepte) et un gpt-oss-120b bien plus à l’aise, qui passe de 32k à 128k. Face au PC 395 et au Mac Studio, il est tout simplement derrière : pas de qwen3.8-flash-next, moins de portée pour llama4-scout-17b (128k contre 256k et 512k) et le même plafond de 128k pour gpt-oss-120b.
Une réserve, en toute honnêteté. La vitesse du Cube est le seul chiffre de cette page que nous ne pouvons pas cerner du tout : Xiaomi n’a pas publié la bande passante de ses 80 Go, si bien que les 341 Go/s de sa fiche sont notre propre estimation, signalée comme telle. Les 1,22 To/s associés au Cube appartiennent à la mémoire empilée sur l’une de ses puces, pas aux 80 Go où loge réellement un modèle ; nous l’avons décortiqué dans notre comparatif Mac mini M6 contre AI Cube (en anglais). La mémoire, elle, décide de ce qui tient, et 80 Go est le chiffre dont partent tous les verdicts ci-dessus.
Ce que nous n’avons pas pu vérifier
- AMD ne publie aucune bande passante en Go/s. Les 256 et 273 Go/s découlent du type et de la vitesse de mémoire qu’AMD publie bel et bien (un bus de 256 bits à 8 000 et 8 533 MT/s). C’est un calcul, pas une mesure, et les fiches le disent.
- Les plafonds GPU d’AMD sont les chiffres publiés par AMD. Sous Linux, la limite se règle, et AMD ne publie pas de maximum pour ce réglage ; nous retenons les 96 et 160 Go qu’il annonce, si bien qu’une machine réglée aux petits oignons pourrait offrir davantage, dans une mesure qu’AMD ne précise pas.
- Sur Mac, la mémoire pour le modèle suppose un réglage. macOS garde une limite par défaut sur la quantité de mémoire que le GPU peut verrouiller, et
iogpu.wired_limit_mbla relève ; les 61,00 et 125,00 Gio ci-dessus supposent que vous la relevez, ce qui compte surtout pourgpt-oss-120bsur le Mac mini de 64 Go. - Toutes les vitesses de cette page sont des estimations. Ce qui tient est calculé à partir de la taille réelle des fichiers et du cache qu’exige l’architecture de chaque modèle ; les tokens par seconde viennent d’une formule fondée sur la bande passante et, pour le Cube, d’une bande passante qui est elle-même une hypothèse.
- Les prix sont ceux que chaque fabricant publie pour les États-Unis, en dollars, aux dates indiquées. Aucune des machines AMD n’affiche de prix en euros.
Alors, laquelle acheter ?
Si aucun des 6 gros modèles ne figure sur votre liste, les 5 machines font tenir les mêmes 20 à 32k, de qwen3-1.7b à gpt-oss-120b. Le choix se joue alors sur la vitesse, le prix et votre préférence entre macOS et un PC. De quoi bien s’amuser, dans un camp comme dans l’autre.
Lesquels des 26 modèles tiennent sur votre machine, au contexte que demande votre travail et dans la langue où vous travaillez : c’est à cette question que répond le Trouveur de modèle, et la liste complète des 18 machines donne chaque chiffre avec son étiquette de provenance. Une fois la machine sur votre bureau, notre guide d’installation de llama.cpp lance un modèle en 1 commande, et sur Mac, le guide MLX est l’autre voie à connaître.