Elige LM Studio si quieres una ventana: buscas un modelo, lo cargas y chateas, sin terminal y con un servidor que viene cerrado. Elige llama.cpp si quieres código abierto, el motor más nuevo nada más salir y que nada se envíe fuera. Por debajo, mismo motor: LM Studio corre los GGUF sobre su propia compilación de llama.cpp.
Esa última frase es la gracia de la comparativa, y hemos comprobado hasta dónde llega. LM Studio 0.4.26 es la versión que entregaba su servicio de descarga el 27 de octubre de 2026 (compilación 0.4.26-4), y ni la 0.4.27 (29 de octubre) ni la 0.4.28 (31 de octubre, la que sirve el 5 de noviembre de 2026) nombran un runtime de llama.cpp nuevo en su registro de cambios; llama.cpp v0.9.0 es su versión estable del 4 de noviembre de 2026. El código de llama.cpp lo hemos leído allí donde decide memoria, peticiones a la vez, red y privacidad. El de LM Studio es cerrado, así que de ese contamos lo que escribe su fabricante, y lo decimos cada vez. No los hemos cronometrado, así que aquí no hay ganador en velocidad: con el mismo GGUF sobre llama.cpp, la velocidad depende de la compilación del motor y de los ajustes, y justo ahí es donde se diferencian.
 LM StudioFicha del programa
 llama.cppFicha del programa
| LM Studio | llama.cpp | |
|---|---|---|
| Qué es | Una aplicación de escritorio con buscador de modelos, chat y servidor, montada sobre motores | El motor en sí, con servidor, chat en la terminal y página de chat |
| Versión el 5 de noviembre de 2026 | 0.4.28 (descarga 0.4.28-2) | v0.9.0 (compilación b12110, 4 de noviembre), más las compilaciones diarias (b12125 el 5 de noviembre) |
| llama.cpp por dentro | Runtime 2.50.0, sobre b11337 (2 de octubre de 2026), tal como llegó con la 0.4.26; los registros de cambios de la 0.4.27 y la 0.4.28 no nombran otro más nuevo | Es llama.cpp: el canal estable o cualquier compilación diaria |
| Código y licencia | Cerrado; gratis en casa y en el trabajo, sin revenderlo como servicio. Su línea de órdenes lms, sus SDK y su motor MLX son MIT |
Código abierto, MIT |
| Funciona en | Windows x64 (con AVX2) y ARM64, macOS 14+ con Apple Silicon, Linux x64 y ARM64. Sin Mac Intel | Windows, macOS, Linux y Android; compilaciones para CPU, CUDA, ROCm, Vulkan, Metal, SYCL y OpenVINO. Mac Intel con el procesador |
| Ficheros de modelo | GGUF y MLX; eliges tú en su buscador | GGUF; safetensors solo tras convertirlos |
| Peticiones a la vez, de serie | 4 (Max Concurrent Predictions; motores llama.cpp y MLX) | 4, compartiendo una misma reserva de memoria de contexto |
| Contexto de serie | No lo publica; lo fijas al cargar | El máximo del modelo, recortado a lo que quepa (nunca menos de 4.096 tokens) |
| Modelo sin uso | Los que carga la API bajo demanda se descargan a los 60 minutos; los cargados con lms load se quedan |
Sigue cargado hasta que paras el servidor |
| Ventana | Aplicación de escritorio completa; llmster sin ventana |
Una página de chat en el navegador, encendida de serie |
| Escucha en | 127.0.0.1:1234 |
127.0.0.1:9931 (8080 hasta la v0.6.0) |
| Clave y CORS | Clave opcional con permisos (Require Authentication); CORS apagado | Clave opcional (--api-key); CORS abierto a cualquier página web |
| Lo que envía solo | 2 cosas, según su fabricante: comprobar actualizaciones y actualizar motores (esto último, apagable). No se puede comprobar | Nada |
El mismo motor: qué llama.cpp lleva dentro LM Studio 0.4.26
LM Studio no escribe un motor propio para los GGUF. Empaqueta llama.cpp en lo que llama un runtime, con su propia numeración, y su registro de cambios dice sobre qué llama.cpp va cada uno. La 0.4.26, disponible desde el 8 de octubre de 2026, trajo el runtime 2.50.0, montado sobre la compilación b11337 de llama.cpp, una diaria del 2 de octubre de 2026. En los Mac con Apple Silicon hay un segundo motor, MLX, que LM Studio desarrolla en abierto con licencia MIT; y desde la 0.4.25, un tercero, Splash, para M3 o posteriores con macOS 26.4 o superior, que es palabra del fabricante, porque la aplicación es cerrada.

Y ahora lo curioso. El 5 de noviembre de 2026 el llama.cpp estable, la v0.9.0, es la compilación b12110, del 4 de noviembre: 773 compilaciones por delante de la que lleva dentro LM Studio 0.4.26 (con la v0.8.0, la estable hasta el 4 de noviembre, eran 623). Y el número de compilación de llama.cpp sube unas 21 al día, de las que unas 13 se publican como compilaciones diarias (del 28 de octubre al 5 de noviembre de 2026); el 5 de noviembre la última es la b12125. Así que el día que llega a llama.cpp una familia de modelos nueva, usar llama.cpp a pelo es la forma más rápida de probarla. LM Studio la sigue, pero a su ritmo.
Un punto justo a favor de LM Studio: sus motores se actualizan solos, activado de fábrica, y puedes apagarlo en los ajustes de la aplicación. O sea, que el llama.cpp de tu LM Studio puede ser más nuevo que el 2.50.0; la propia aplicación te dice qué runtime tienes. En este vídeo se ve cómo actualizar LM Studio y sus motores llama.cpp en Windows; está grabado con otra versión, así que donde no coincida, manda esta página.
Se abre en YouTube (sin cookies) solo si pulsas.
Ventana o terminal: instalarlos y la primera respuesta
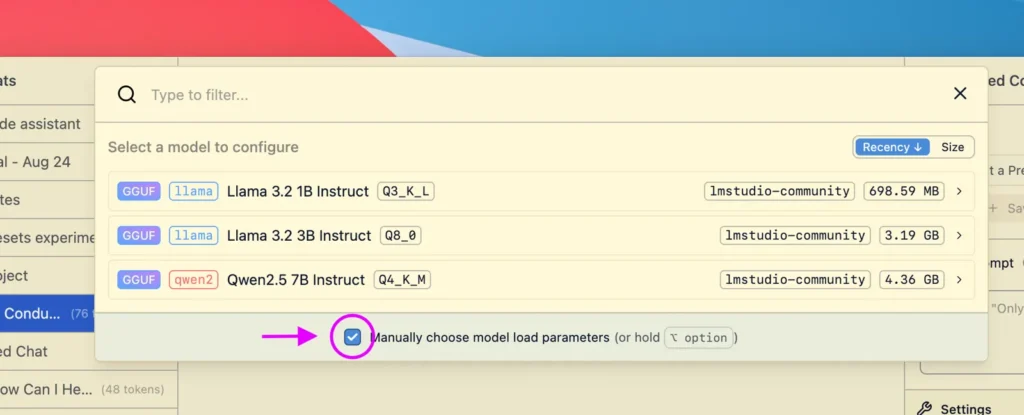
LM Studio es un instalador de los de siempre: un .dmg en el Mac, un .exe en Windows, un AppImage o un .deb en Linux. Después, 3 pasos dentro de la aplicación y ninguno en la terminal: buscas y descargas un modelo en la pestaña Discover, lo cargas y chateas. Si lo quieres sin ventana, en un servidor o un mini PC, tiene llmster, un demonio sin interfaz que manejas con su línea de órdenes lms.
llama.cpp te pide antes una elección: qué compilación. La vía tranquila es brew install llama.cpp, que en Mac y Linux te da la v0.9.0 estable (Homebrew la sirve desde el 5 de noviembre de 2026). La página de versiones de GitHub publica compilaciones por sistema y tarjeta gráfica, y coges la que encaja con la tuya. Después, 1 orden:
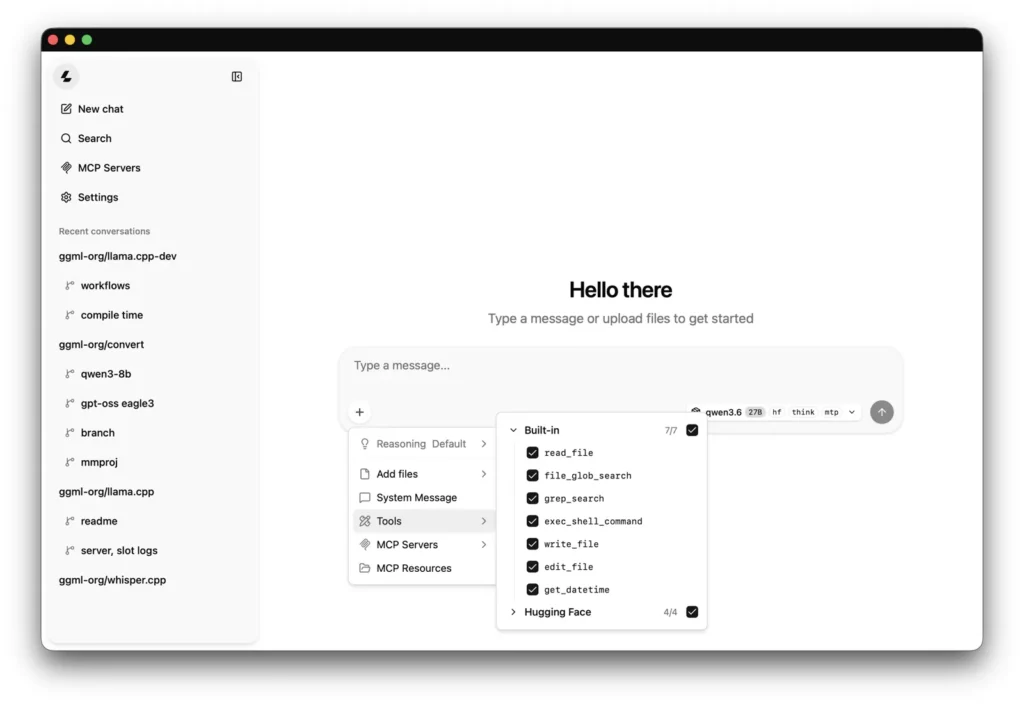
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF -c 8192Baja el modelo de Hugging Face y abre el servidor y una página de chat en http://127.0.0.1:9931. Esa página es la respuesta de llama.cpp a la ventana de LM Studio: tus conversaciones y, desde la v0.7.0, un gestor de modelos, todo en el navegador. Los chats se guardan en el almacenamiento del navegador, así que si borras los datos del sitio, desaparecen; LM Studio los guarda como ficheros JSON en ~/.lmstudio/conversations/.
Nuestra guía para instalar LM Studio y la de llama.cpp van paso a paso. En hardware, la lista larga es la de llama.cpp: corre hasta en un Mac Intel, solo con el procesador, y en móviles Android. LM Studio no tiene versión para Mac Intel, y en Windows x64 pide un procesador con AVX2.
Qué fichero corres y quién lo elige
Los dos leen GGUF, el formato que creó llama.cpp. La diferencia está en cómo te llega el fichero.
El buscador de LM Studio enseña GGUF y MLX uno al lado del otro y eliges tú; en un Mac con Apple Silicon puedes tener los dos. Sus modelos van a ~/.lmstudio/models/, y lms import añade un GGUF que bajaste por otro lado. llama.cpp solo lee GGUF: un modelo en safetensors hay que convertirlo antes con el script convert_hf_to_gguf.py. Con -hf lo trae de Hugging Face, elige la compresión Q4_K_M si no le dices otra y guarda el fichero en la caché estándar de Hugging Face.
En el Mac, qué formato coger es una pregunta en sí misma, y nuestra comparativa MLX vs GGUF mide 7 modelos en los dos. Y si prefieres saltarte la aplicación y elegir el motor, nuestra comparativa MLX vs llama.cpp pone mlx-lm y llama.cpp lado a lado.
4 peticiones a la vez en los dos, y el contexto
Aquí coinciden más de lo que parece. Arrancas llama serve y abre 4 huecos: en el código de la v0.9.0, como en el de la v0.8.0, el número de huecos viene en auto, y auto significa 4, con una sola reserva de memoria de contexto que comparten todos. Si lo arrancas con -c 8192, tienes 8.192 tokens para los 4 juntos. -np fija otro número.
La documentación de LM Studio da la misma cifra: Max Concurrent Predictions vale 4 de serie, así que hasta 4 peticiones se procesan juntas en vez de esperar en cola. Está en los ajustes avanzados del cargador de modelos y funciona con su motor llama.cpp y, desde la 0.4.2 (febrero de 2026), también con su motor MLX; la 0.4.13 (mayo de 2026) lo extendió a los modelos MLX que leen imágenes. Cómo reparte la memoria entre esas 4 no lo publica, y con el código cerrado no lo podemos leer.
En el contexto se separan. llama.cpp empieza por arriba: su tamaño de contexto viene, de serie, en el más largo con el que se entrenó el modelo, y un mecanismo llamado --fit, encendido de serie, lo recorta hasta un suelo de 4.096 tokens y pasa capas a la memoria del sistema hasta que el modelo cabe, intentando dejar 1.024 MiB libres en cada dispositivo. LM Studio no publica su valor de serie; ves el número, y lo cambias, en el cargador o con lms load --context-length. Nuestro consejo vale para los dos: escribe tú la cifra y sabrás lo que tienes.
La memoria tras la respuesta también cambia. llama-server mantiene el modelo cargado hasta que lo paras; --sleep-idle-seconds lo pone a descansar pasado un rato. En LM Studio, los modelos que la API carga bajo demanda se descargan a los 60 minutos sin peticiones, y cargar uno nuevo de esa manera saca el anterior.
Qué puertas quedan abiertas: 127.0.0.1:1234 contra 127.0.0.1:9931
Primero la buena noticia: los dos escuchan solo en tu propio equipo nada más instalarlos. LM Studio espera en 127.0.0.1:1234; llama.cpp v0.9.0, en 127.0.0.1:9931 (era 8080 hasta la v0.6.0, y las imágenes Docker del proyecto siguen usando 8080 dentro del contenedor). Nadie de tu wifi llega a ninguno hasta que lo abres a propósito: Serve on Local Network o lms server start --bind 0.0.0.0 en LM Studio, --host 0.0.0.0 en llama.cpp. Pueden convivir: puertos distintos, sin choques.
La diferencia está en el CORS, que decide qué páginas web pueden usar un servidor local desde tu navegador, y aquí salen de extremos opuestos. LM Studio lo deja apagado salvo que actives Enable CORS o arranques el servidor con --cors. llama.cpp, de serie, refleja cualquier origen y permite credenciales, así que una web que visites puede mandar peticiones a tu llama-server y leer las respuestas mientras esté en marcha; el propio servidor lo avisa al arrancar con security: no API key is set and CORS allows all origins.
Los dos pueden pedir clave. LM Studio tiene Require Authentication desde la 0.4.0, con tokens que llevan permisos; viene apagado. llama.cpp tiene --api-key, la variable LLAMA_API_KEY y --api-key-file para varias. Una trampa en llama.cpp: la clave no cambia el CORS. El ajuste que lo cierra es --cors-origins localhost.

Lo que envía cada uno, y lo que puedes comprobar
Aquí gana llama.cpp de calle, y no tienes que fiarte de nosotros: el código es público. Buscamos analítica, telemetría y rastreo en su motor, su servidor, su chat de terminal y su página de chat y no encontramos nada. La v0.8.0 trajo 2 salidas nuevas, que la v0.9.0 mantiene tal cual, las dos apagadas hasta que las enciendes: --connect, experimental, que abre un túnel entre pares hacia tu servidor a través de un programa aparte, llama-connect; y la opción Discover Models de la página de chat, que, una vez marcada en los ajustes, consulta Hugging Face desde tu navegador, además del catálogo de modelos del propio proyecto en llama.app (su ayuda dice que es para el modo router, cuando el servidor arranca sin un modelo fijo). llama.cpp no comprueba actualizaciones ni tiene cuenta. Solo sale a internet cuando se lo pides: descargar modelos con -hf, llama download o --model-url, modelos empaquetados como imágenes de contenedor con --docker-repo, y llama update en las instalaciones hechas con el script del proyecto. Con los modelos ya en disco, --offline le prohíbe toda descarga.
LM Studio dice que no tiene telemetría, y según su propia cuenta salen 2 cosas por su cuenta: la aplicación comprueba actualizaciones (su política de privacidad dice que recibe la versión y compilación de la aplicación, el sistema operativo y la IP), y los motores se actualizan solos, activado de fábrica y apagable en los ajustes. Buscar en Discover llega a Hugging Face, pero solo cuando lo usas; el Hub, la búsqueda web y las funciones de nube piden cuenta. ¿Es todo? No te lo podemos decir: el código es cerrado y sus términos prohíben la ingeniería inversa, así que nadie de fuera de la empresa puede comprobarlo. Es el precio de la ventana.
La licencia va en la misma línea. llama.cpp es MIT: léelo, cámbialo y mételo en tu propio producto. LM Studio es gratis en casa y en el trabajo según sus términos, que prohíben revenderlo como servicio. Cada destino, con su fuente y su fecha, está en nuestra ficha de LM Studio y en la de llama.cpp.
Cuál instalaríamos, según tu caso
- Primera vez con IA local y sin terminal: LM Studio. Buscar, cargar, chatear y un servidor que viene cerrado.
- Un Mac con Apple Silicon: LM Studio, que además corre modelos MLX; llama.cpp solo lee GGUF.
- Un modelo que salió esta semana: una compilación diaria de llama.cpp, que recibe las familias nuevas antes que el runtime de LM Studio.
- Que no salga nada del equipo, y poder comprobarlo: llama.cpp con
--offline. Solo el código abierto permite verificarlo. - Un producto o un servicio montado encima: llama.cpp, MIT; los términos de LM Studio prohíben revenderlo como servicio.
- Un Mac Intel o un móvil Android: llama.cpp, el único de los 2 que funciona ahí.
- Los dos: sin problema. Puertos distintos, 1234 y 9931, y el mismo GGUF sirve para ambos.
Si algo falla por el camino, tenemos una guía para cuando LM Studio no funciona y otra para cuando llama.cpp no funciona. ¿Dudas también con Ollama? Nuestras comparativas LM Studio vs Ollama y llama.cpp vs Ollama lo cubren, y el buscador de modelos te dice qué modelos caben en tu equipo.