Las variables de entorno de Ollama se ponen en el servidor, no en tu terminal: un override de systemd en Linux (Environment=), launchctl setenv en macOS, variables de usuario en Windows y -e en Docker. Para comprobar qué ha cogido de verdad, mira la línea server config que imprime ollama serve al arrancar.
Arrancamos Ollama 0.40.16, la última estable a 19 de noviembre de 2026, por partida doble: el binario oficial para Linux del tarball de la versión (el 19 de noviembre) y la imagen oficial de Docker ollama/ollama:0.40.16 (el 18), sin ningún modelo cargado y en un servidor sin GPU. Cada valor por defecto de esta guía sale de la línea de arranque del propio servidor, y le dimos unos cuantos valores absurdos a propósito para ver qué hacía con ellos. Alguna respuesta nos pilló por sorpresa.
 OllamaFicha del programa
Las 26 variables OLLAMA_ y su valor por defecto en la v0.40.16
Al arrancar, ollama serve v0.40.16 escribe una línea server config con 40 variables y el valor que está usando; 26 empiezan por OLLAMA_ (las otras 14 son de proxy, de GPU y de llama.cpp). Esta es la tabla, con el valor por defecto que medimos sin poner ninguna:
| Variable | Por defecto (medido, v0.40.16, 18/19-11-2026) | Para qué sirve |
|---|---|---|
OLLAMA_HOST |
http://127.0.0.1:11434 (imagen Docker: 0.0.0.0:11434) |
Dirección y puerto en los que escucha el servidor |
OLLAMA_ORIGINS |
17 orígenes locales (localhost, 127.0.0.1, 0.0.0.0, app://, file://, tauri://, vscode-webview://, vscode-file://) |
Webs que pueden llamar a la API desde el navegador (CORS) |
OLLAMA_KEEP_ALIVE |
5m0s |
Cuánto se queda un modelo en memoria tras la última petición |
OLLAMA_MODELS |
$HOME/.ollama/models (Docker: /root/.ollama/models) |
Carpeta donde se guardan los modelos |
OLLAMA_CONTEXT_LENGTH |
0 (automático: 4096 en nuestra máquina sin GPU) |
Contexto por defecto si la petición no pide otro |
OLLAMA_NUM_PARALLEL |
1 |
Peticiones que atiende cada modelo a la vez |
OLLAMA_MAX_LOADED_MODELS |
0 (automático) |
Modelos cargados a la vez |
OLLAMA_MAX_QUEUE |
512 |
Peticiones en cola antes de empezar a rechazar |
OLLAMA_FLASH_ATTENTION |
false |
Fuerza la flash attention (1) o la bloquea (0) |
OLLAMA_KV_CACHE_TYPE |
vacía (f16) |
Cuantización de la caché de contexto: q8_0 o q4_0 |
OLLAMA_LOAD_TIMEOUT |
5m0s |
Cuánto puede estar atascada una carga antes de rendirse |
OLLAMA_GPU_OVERHEAD |
0 |
Memoria gráfica reservada por GPU, en bytes |
OLLAMA_SCHED_SPREAD |
false |
Reparte siempre el modelo entre todas las GPU |
OLLAMA_IGPU_ENABLE |
vacía | Activa las GPU integradas |
OLLAMA_VULKAN |
true |
Motor Vulkan |
OLLAMA_LLM_LIBRARY |
vacía | Fuerza una librería y se salta la autodetección |
OLLAMA_DEBUG |
INFO |
Nivel de log (1 = DEBUG) |
OLLAMA_DEBUG_LOG_REQUESTS |
false |
Guarda el cuerpo de las peticiones en una carpeta temporal |
OLLAMA_NO_CLOUD |
false |
Apaga las funciones en la nube de ollama.com |
OLLAMA_REMOTES |
[ollama.com] |
Servidores permitidos para modelos remotos |
OLLAMA_CREATE_REMOTE |
false |
Obliga a create a pasar por la API aunque el servidor sea local |
OLLAMA_MAX_TRANSFER_STREAMS |
4 |
Descargas en paralelo al bajar o subir modelos safetensors |
OLLAMA_NOPRUNE |
false |
No limpia los blobs sin usar al arrancar |
OLLAMA_NOHISTORY |
false |
No guarda el historial de ollama run |
OLLAMA_GO_TEMPLATE |
true |
Usa el TEMPLATE del Modelfile cuando lo hay |
OLLAMA_EDITOR |
vacía | Editor para escribir el prompt con Ctrl+G |
Las descripciones son las que la v0.40.16 lleva en su propio código, pasadas a cristiano. ollama serve --help solo enseña 19 de las 26 (más 2 de llama.cpp), así que la línea de arranque es la referencia completa.
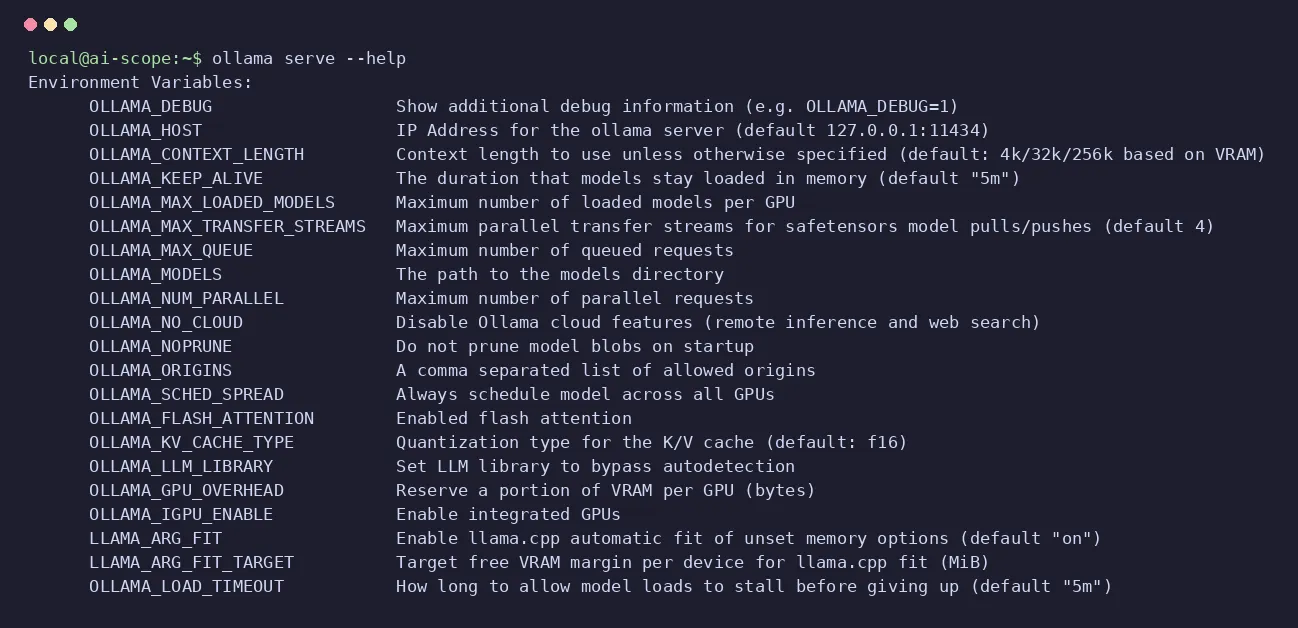
ollama serve --help: 19 OLLAMA_ de las 26 que lee de verdad el servidor Captura: nuestra terminal, Ollama 0.40.16, 19-11-2026Cómo poner las variables de entorno de Ollama en Linux, macOS, Windows y Docker
La variable tiene que llegar al proceso que ejecuta ollama serve. Un export en tu shell solo llega a lo que lances desde esa shell, y el servidor instalado como servicio o como aplicación no se entera. Por sistema, siguiendo la documentación de la v0.40.16:
- Linux (servicio systemd):
sudo systemctl edit ollama.service, una líneaEnvironmentpor variable bajo[Service], y despuéssystemctl daemon-reloadysystemctl restart ollama. - macOS (aplicación):
launchctl setenv OLLAMA_HOST "0.0.0.0:11434"por cada variable, y cierra y vuelve a abrir Ollama. - Windows: cierra Ollama desde la barra de tareas, abre «Editar las variables de entorno de esta cuenta», añade la variable y vuelve a arrancar Ollama.
- Docker:
-e OLLAMA_KEEP_ALIVE=30mendocker run, o un bloqueenvironment:en Compose.
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_KEEP_ALIVE=30m"
Si arrancas el servidor a mano, basta con ponerla delante: OLLAMA_KEEP_ALIVE=30m ollama serve, el mismo formato que usamos con el binario el 19 de noviembre. En Docker, el 18 de noviembre con la v0.40.16, pasamos cuatro a la vez con -e y la línea de arranque las enseñó todas: 30m0s, 8192, 2 y el puerto nuevo, 11500. Con contenedores hay más miga (volúmenes, GPU, puertos), y nuestra guía de Ollama en Docker la cuenta entera.
Se abre en YouTube (sin cookies) solo cuando pulsas reproducir.
Seis minutos sobre por qué importan estas variables y cómo ponerlas en Mac, Linux y Windows, publicados en septiembre de 2024 con una versión anterior de Ollama: para los valores por defecto, fíate de nuestra tabla, medida en la v0.40.16.
Cómo ver qué variables ha leído Ollama: la línea server config
Hay una línea que despeja cualquier duda. En la v0.40.16 la escribe routes.go:2474 con nivel INFO cada vez que arranca el servidor, y lleva todas las variables con el valor que va a usar, venga de ti o sea el de serie:
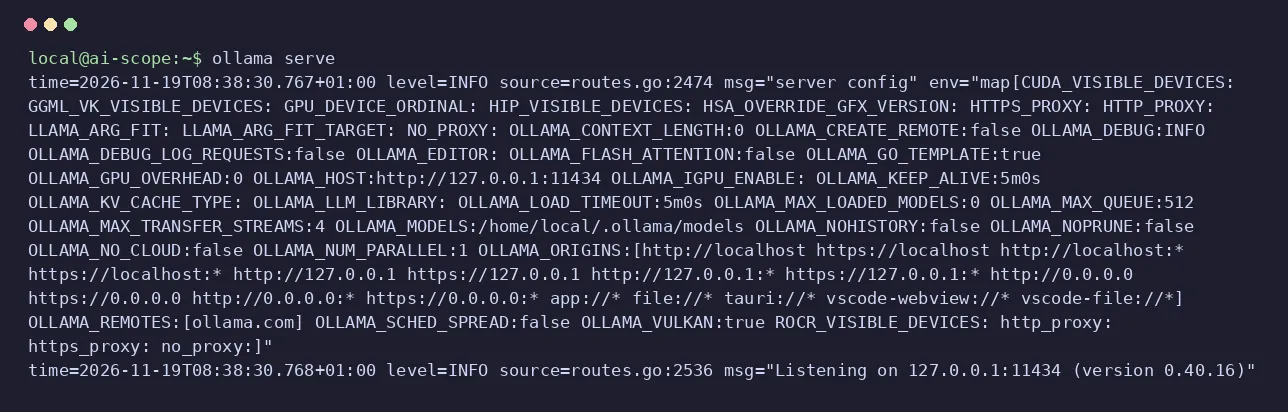
Dónde encontrarla depende de cómo corra Ollama. Con el servicio de Linux, journalctl -u ollama --no-pager | grep "server config"; en Docker, docker logs <contenedor> 2>&1 | grep "server config"; y a mano, es lo primero que suelta ollama serve. Si tu variable sale ahí con el valor que querías, el servidor la tiene; si sale el de serie, no le ha llegado (lo típico: la pusiste en tu shell y el servicio es otro proceso). En la misma línea compruebas cosas como OLLAMA_KEEP_ALIVE:30m0s: el servidor escribe las duraciones en esa forma completa.
OLLAMA_HOST: 127.0.0.1 por defecto, y 0.0.0.0 en Docker
El 19 de noviembre de 2026, el binario oficial de Linux de la v0.40.16 arrancó sin variables escuchando en 127.0.0.1:11434: solo tu propia máquina llega a él. Lo comprobamos desde fuera: en 127.0.0.1 contestó {"version":"0.40.16"}, y por la IP de red del equipo la conexión falló. Con OLLAMA_HOST=0.0.0.0 (sin puerto) pasó a [::]:11434, todas las interfaces, y mantuvo el puerto 11434.
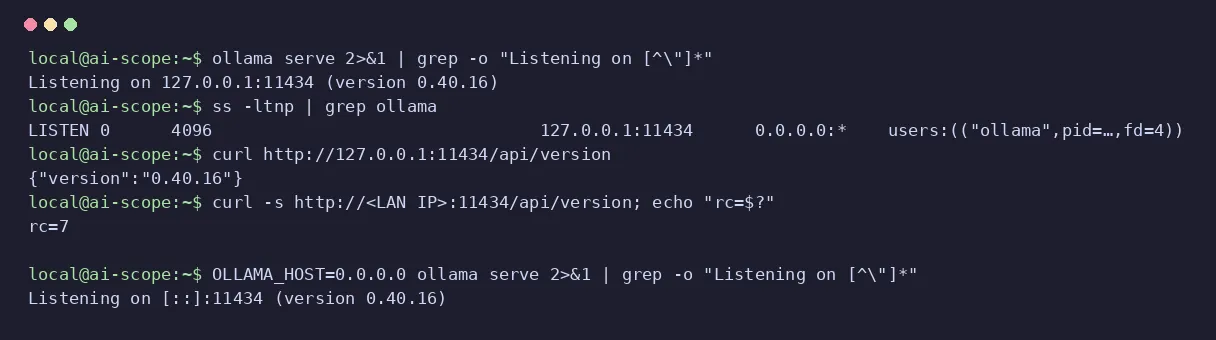
La imagen oficial de Docker va al revés: trae OLLAMA_HOST=0.0.0.0:11434 ya puesta, así que dentro del contenedor escucha en todas las interfaces (lo vimos el 18 de noviembre con ollama/ollama:0.40.16), y desde fuera del contenedor llegas a él por el puerto que publiques con -p. Abrir Ollama a tu red sirve para usarlo desde el portátil o el móvil, y también significa que cualquiera en esa red puede llegar a él.
OLLAMA_ORIGINS es la otra mitad. No decide quién se conecta, sino qué páginas web deja tu navegador que hablen con la API. Con OLLAMA_ORIGINS=https://mi-app.example, la v0.40.16 puso nuestro origen el primero y conservó los 17 de serie: suma, no sustituye. El detalle, con ejemplos, está en nuestra guía de la API de Ollama.
OLLAMA_KEEP_ALIVE: 5 minutos, 0, 30 o -1 (para siempre)
OLLAMA_KEEP_ALIVE decide cuánto se queda cargado un modelo después de su última petición. El valor por defecto en la v0.40.16 es 5m0s, medido el 19 de noviembre de 2026, y es la cuenta atrás que enseña ollama ps en su columna UNTIL. Probamos cuatro valores con esa versión:
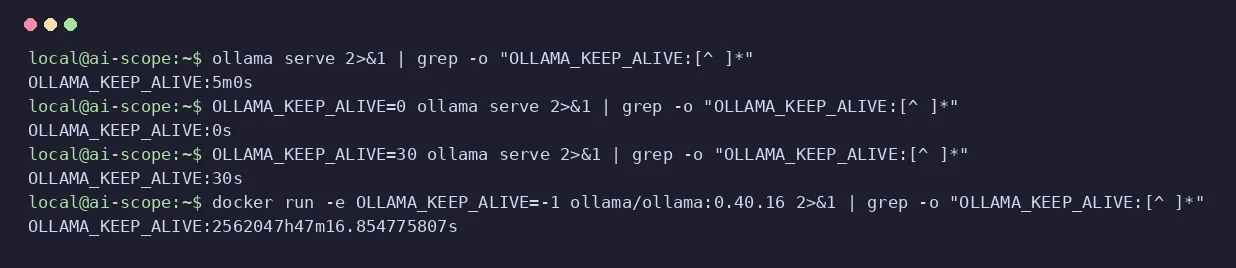
0→0s: el modelo se descarga en cuanto contesta. Libera memoria, y la siguiente petición tiene que volver a cargarlo.30→30s: un número sin unidad son segundos, no minutos. Escribe30msi quieres media hora.-1→2562047h47m16.854775807s: cualquier valor negativo significa «no lo descargues nunca».
La variable fija el valor por defecto de todo el servidor. Cada petición puede cambiarlo con su propio campo keep_alive en /api/generate o /api/chat, que manda sobre la variable según la documentación de la v0.40.16; y ollama stop descarga un modelo al momento, como contamos en nuestra guía de comandos de Ollama.
OLLAMA_NUM_PARALLEL, OLLAMA_MAX_LOADED_MODELS y OLLAMA_MAX_QUEUE
Estas tres deciden cuántas cosas hace Ollama a la vez, y todas cuestan memoria. En la v0.40.16, medido el 19 de noviembre de 2026, los valores por defecto son 1, 0 y 512:
OLLAMA_NUM_PARALLEL(1): peticiones que sirve cada modelo al mismo tiempo. Según la documentación de la v0.40.16, la memoria necesaria crece conNUM_PARALLEL× contexto: 4 peticiones en paralelo con 8192 tokens de contexto reservan caché para 32.768 tokens.OLLAMA_MAX_LOADED_MODELS(0 = automático): la documentación pone el tope automático en 3 modelos por GPU, o 3 si va por CPU, siempre que quepan en memoria.OLLAMA_MAX_QUEUE(512): peticiones esperando turno; pasado ese número, el servidor contesta con un error 503.
Para una sola persona chateando en casa, los valores de serie van bien. Sube NUM_PARALLEL si varias herramientas o personas comparten el mismo servidor, y haz antes las cuentas del contexto.
OLLAMA_FLASH_ATTENTION y OLLAMA_KV_CACHE_TYPE: menos memoria con contextos largos
OLLAMA_KV_CACHE_TYPE cuantiza la caché del contexto: q8_0 gasta más o menos la mitad de memoria que el f16 de serie, y q4_0 más o menos un cuarto, según la documentación de la v0.40.16, que añade que ese ahorro se da con la flash attention activada. El 19 de noviembre de 2026, OLLAMA_KV_CACHE_TYPE=q8_0 apareció tal cual en la línea de arranque. Cuánto cuesta cada contexto, modelo a modelo, lo tienes en nuestra guía de la longitud de contexto en Ollama.
OLLAMA_FLASH_ATTENTION sale false por defecto, que quiere decir «no forzada»: según su documentación, la v0.40.16 ya usa la flash attention cuando el motor y el dispositivo la admiten, y la variable sirve para forzarla con 1 o bloquearla con 0. Y aquí viene la trampa que encontramos:
«invalid environment variable, using default»: un valor que no vale
Es el aviso que da la v0.40.16 cuando una variable que espera un número entero recibe otra cosa. El 18 de noviembre de 2026, con OLLAMA_NUM_PARALLEL=abc, el servidor arrancó igual y dejó esto en el log:
time=2026-11-18T15:53:14.078Z level=WARN source=config.go:265 msg="invalid environment variable, using default" key=OLLAMA_NUM_PARALLEL value=abc default=1El 19 de noviembre, con OLLAMA_MAX_LOADED_MODELS=dos, el mismo mensaje con default=0. La línea lo dice todo: qué variable (key), qué escribiste (value) y qué ha usado en su lugar (default). Sale en las variables que esperan un número entero: NUM_PARALLEL, MAX_LOADED_MODELS, MAX_QUEUE, CONTEXT_LENGTH, MAX_TRANSFER_STREAMS y GPU_OVERHEAD. Por ese mismo código, un 16k en OLLAMA_CONTEXT_LENGTH volvería a 0, el automático: escribe 16384.
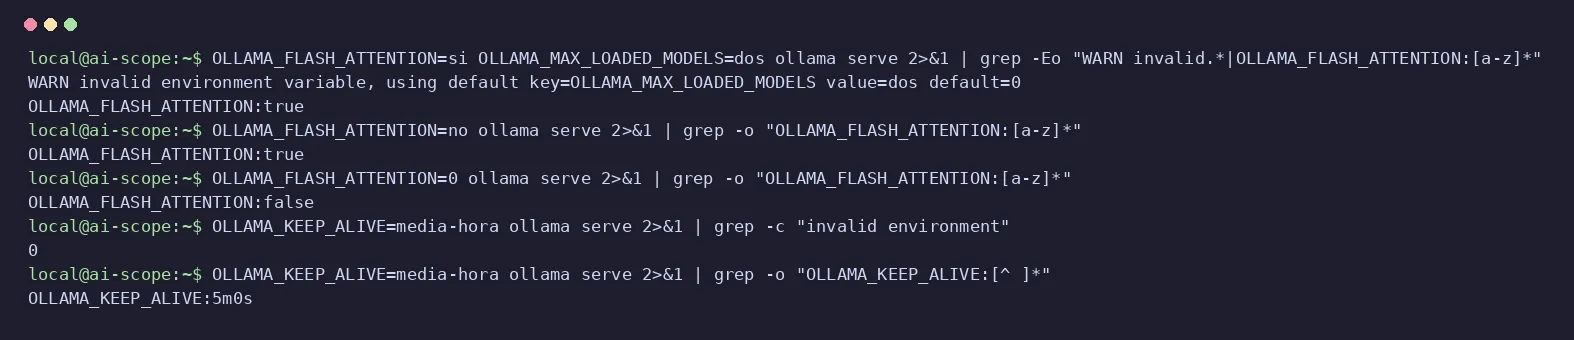
Las que preocupan son las que no avisan. OLLAMA_KEEP_ALIVE=media-hora arrancó sin un solo aviso y se quedó en 5m0s (Ollama no habla español, quién lo iba a decir); los interruptores leen cualquier disparate como true. Por eso la línea server config vale más que cualquier aviso: busca tu variable en ella después de cada cambio. Y si el servidor ni siquiera arranca, nuestra lista de errores de Ollama con su texto exacto sigue donde lo deja esta.